# AI 每天替我巡系統,直到守門的那一支自己壞掉
> Boris Cherny 分享 Anthropic 以 Claude 執行日常維護 routine,幾週內開出 388 個 PR,其中 180 個合併。從我自己維運 23 個 launchd job、7 條 crontab 與 11 支 git hook 腳本的經驗來看,Agentic Operations 最難的部分不是讓 agent 開始工作,而是建立一套獨立的方法,確認它真的把事情做成了。
- Author: Paul Kuo(郭曜郎)
- Date: 2026-08-14
- Pillar: 智能與秩序 / Intelligence & Order
- Tags: Agentic Operations, AI 維運, 自動化治理, 韌性工程, launchd, Claude Code, 靜默失敗
- Canonical: https://paulkuo.tw/articles/agentic-operations-silent-failure/
- Site index for LLMs: https://paulkuo.tw/llms.txt
---
> **TL;DR**:Anthropic 讓 Claude 每天自主執行 App 維護 routine,幾週內開出 388 個 PR,其中 180 個合併。真正的轉折,是工作的發起端從人換成 agent。但我跑了 150 天、目前掛著 23 個 launchd job 之後,最在意的反而是另一件事:routine 跑得動,不代表事情真的做成了。執行可以自動化,驗證標準不能由同一套系統自己決定。
8 月 9 日那天,我推一批 commit 到鏡像,pre-push 的 git 健檢連續崩了三次。它印給我的字是「非分歧」。
而同一次 push 的 origin,其實正落後三個 commit,其中一個是 security fix。
健檢沒有說謊。它只是崩在偵測還沒跑完的地方,然後照著我當初寫死的字串,回報一個它根本沒驗證過的結論。
我後來把那行字改成「分歧狀態未知(偵測未完成)」,旁邊留了一句給未來的自己:措辭不可再改回「非分歧」。健檢一旦崩潰,分歧與否就是未知,不是已排除。
五天後我看到 Boris Cherny [在 Threads 上發的那一串](https://www.threads.com/share/Hz4w8ezD4/)。
## Anthropic 讓 Claude 每天開 388 個 PR,這代表什麼?
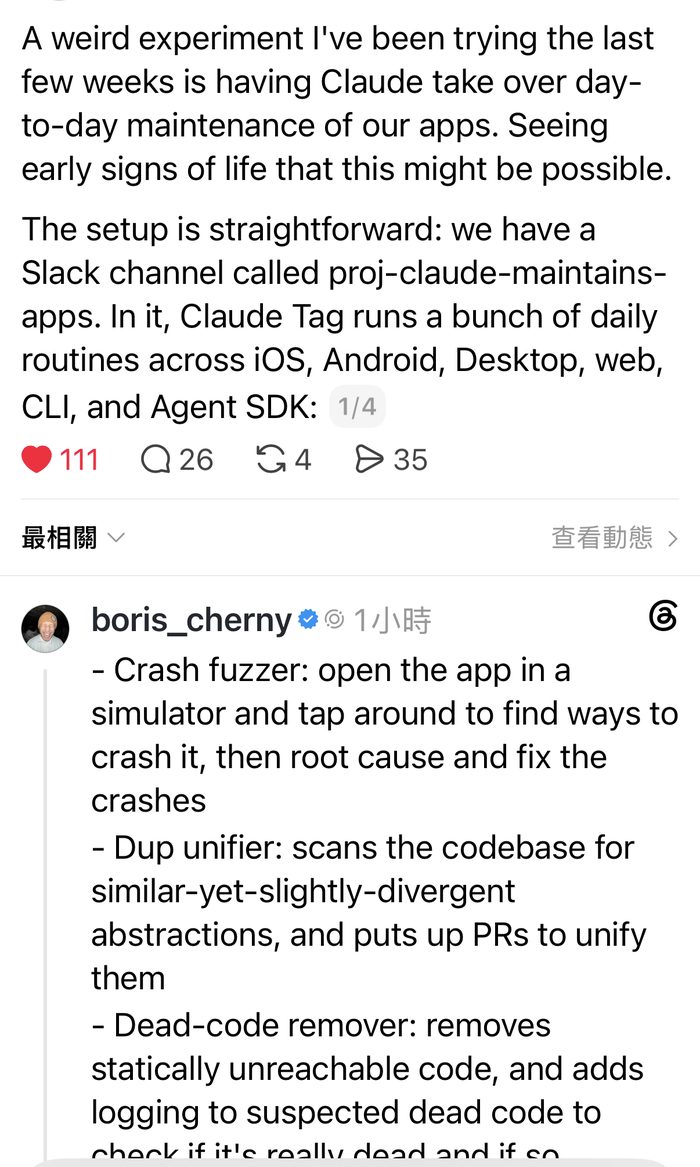
Boris Cherny 是 [Claude Code 的創造者兼負責人](https://www.linkedin.com/in/bcherny/)。他說團隊開了一個 Slack channel 叫 `proj-claude-maintains-apps`,讓 Claude 每天在裡面固定跑一批維護 routine,橫跨 iOS、Android、Desktop、web、CLI 和 Agent SDK:
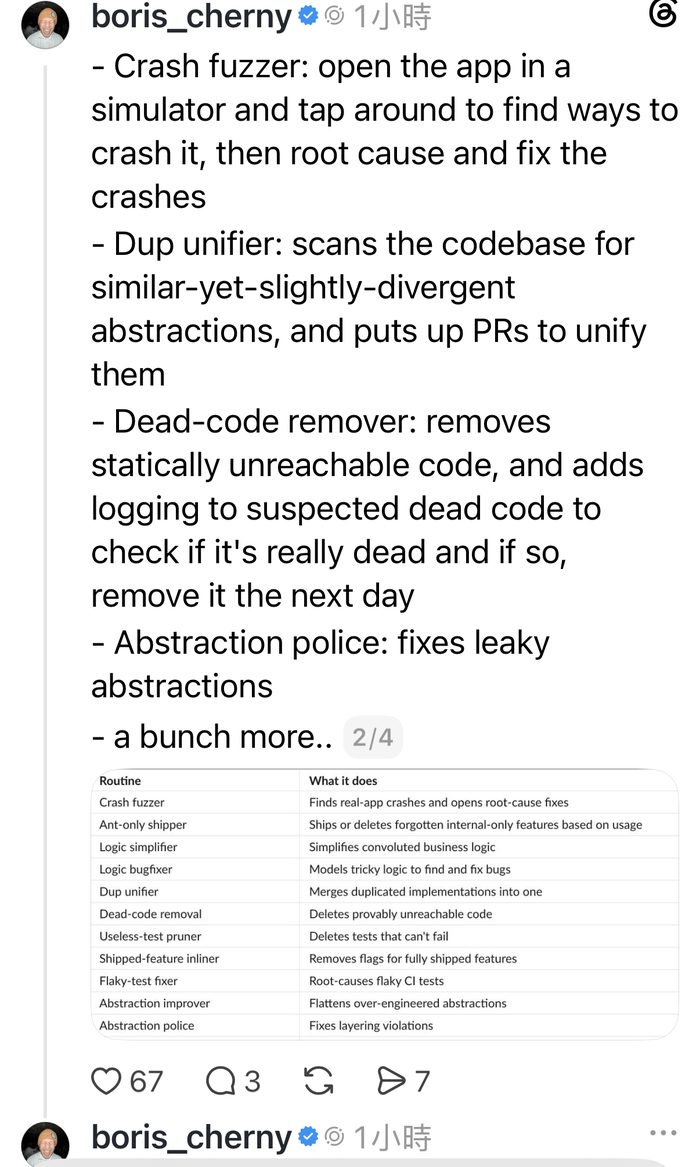
- **Crash fuzzer**:在模擬器裡操作 App,主動找出 crash,追根因,開修復 PR
- **Dup unifier**:掃 codebase 找功能相似但逐漸分岔的實作,開 PR 統一它們
- **Dead-code remover**:刪確定不可達的程式碼;不確定的先加 logging,隔天根據實際執行情況再判斷
- **Logic simplifier / bugfixer**:簡化複雜的商業邏輯,並建立模型去找邏輯漏洞
- **Flaky-test fixer**:追不穩定 CI test 的根因
- **Useless-test pruner**:刪永遠不會 fail 的 test
- **Abstraction improver / police**:處理過度工程化的抽象,以及架構分層違規
串文 1/4 與 2/4。左邊是實驗說明與那個 Slack channel,右邊列出 11 種 routine 各自負責什麼。
來源:Boris Cherny(@boris_cherny)於 Threads
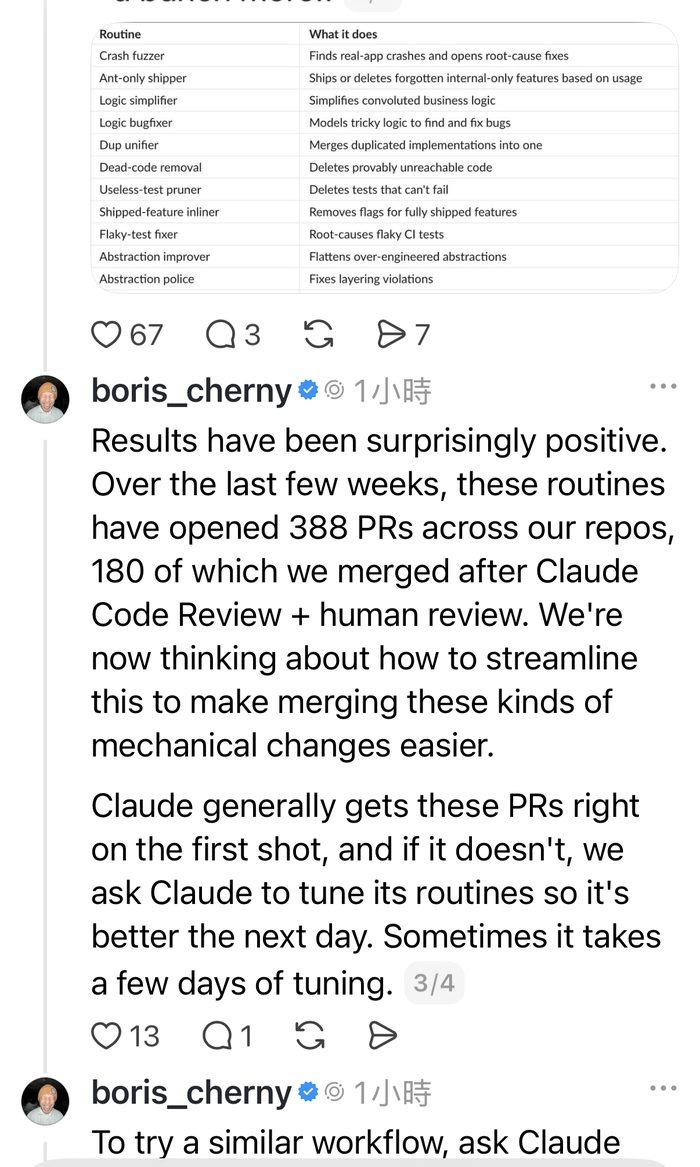
幾週下來,這些 routine 在他們的 repo 開了 388 個 PR,經 Claude Code Review 加人工 review 後 merge 了 180 個。
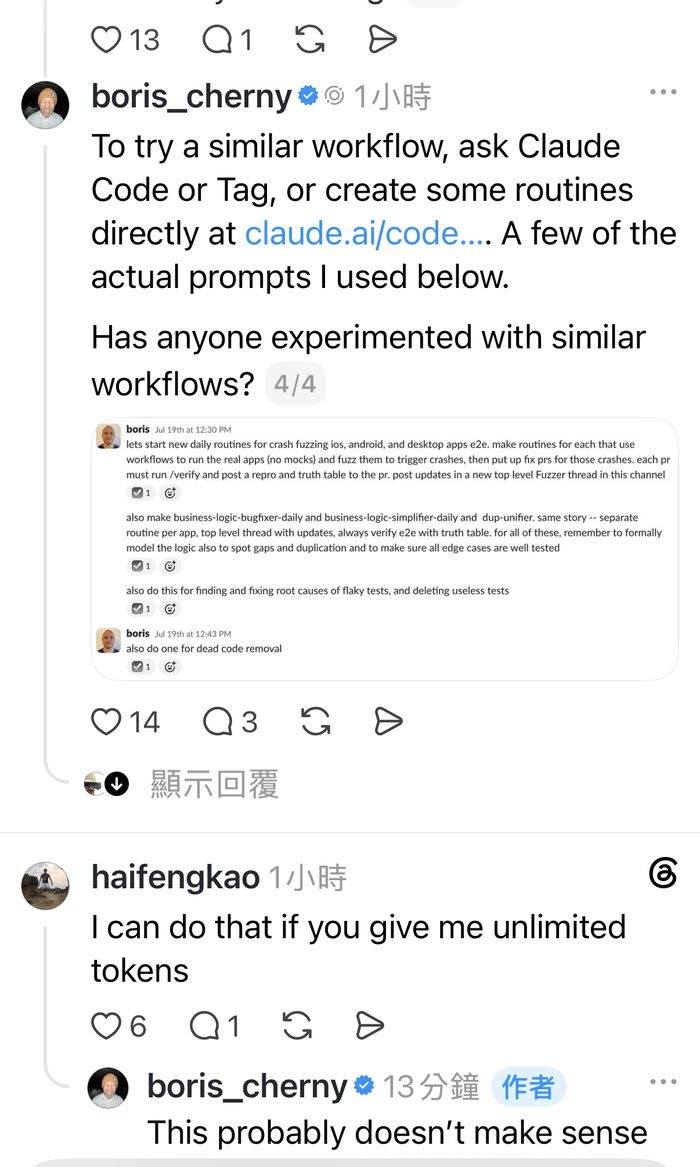
串文 3/4 與 4/4。左邊是幾週下來的成果數字,右邊是他 7 月 19 日實際下給 Claude 的 prompt 原文。
來源:Boris Cherny(@boris_cherny)於 Threads
我讀這串,注意的不是 Claude 的 coding 能力又變強多少,而是工作的發起端換人了。
原本的流程是:人發現問題,下指令,AI 寫程式碼。
現在的流程是:人定義規則與治理邊界,agent 持續觀察系統,發現問題,修改,測試,開 PR,review,學習,隔天再跑一次。
Boris 那串裡,對我來說最重的一句在第三段:第一次沒做對,就修改 routine,讓 Claude 隔天做得更好;有時需要調整幾天。這意味著,公司累積下來的不再只有程式碼,還包括「這間公司怎麼維護軟體」的操作知識。
以前公司把工程經驗寫成 SOP、coding guideline、CI/CD pipeline。下一階段,是把這些經驗寫成一群每天上工的 agent routine。
Copilot 的典型模式,是人發起工作,AI 在旁邊協助。到了這套模式,agent 開始承接日常執行,人退到治理、審核與例外處理的位置。Boris 六月接受 Fortune 訪問時說,他已經八個月沒有手寫程式碼;有些日子,他同時管理的是數百、數千,甚至數萬個 agent。到了那個規模,維護 routine 已經不可能逐一盯著看。
## 一個人的網站,需要幾個自動化才守得住?
我看到那串會有感,是因為我在小得多的規模上做著類似的事,已經 150 天。
現在這台 Mac 上,`launchctl list` 掛著 23 個我自己的 job。挑幾個說:
- **每日 09:00**:contract test。從一份 `auth-contract.json` 讀約 116 條 endpoint 契約,逐條 curl、抓 status、比對 expect。全綠就對 BetterStack 打一次心跳,任一條 fail 就 exit 1 並把問題 append 進待辦檔。
- **每日 10:00**:governance scanner,掃近期 commit 有沒有動到共用檔案卻漏標影響範圍。
- **每週日 10:00**:drift scan,比對契約和實際實作有沒有漂移。
- **每週日 05:00**:restore drill,拿備份的 repo bundle 實際還原一次。
- **每小時第 5 分**:launchd watchdog,檢查其他 job 有沒有照時間打卡。
- **每 48 小時**:repo health check。
- **每天 04:00**:把整個 repo 打包成 bundle 上傳 R2。
crontab 另外有 7 條,主要是資料抓取和三處異地備份。git hook 掛著 4 個(`commit-msg`、`pre-commit`、`post-commit`、`pre-push`),背後接 11 支腳本:gitleaks 掃密鑰、PII gate、URL 邊界檢查、wiki schema enum 檢查、skill 版本 gate、AI 味 lint,還有四支 post-commit 的 skill 同步。
Cowork 那邊有 39 個排程定義,其中 11 個還開著:早上八點的控制塔早報、九點三十八分掃維運告警信、九點四十五分檢查 Fitbit token 是否斷線、十點零九分跑 wiki 素材管線、十點三十五分跑跨專案治理彙整、十一點三十三分把當天的閱讀筆記做成主題綜述。
Boris 那批 routine 多半在找東西修:crash、重複實作、死碼、不穩定或無效的 test。我這批則幾乎都在確認東西還活著:契約沒破、鏡像沒歪、備份還原得回來、心跳沒斷。
差別來自規模。Anthropic 有團隊可以 review 那 388 個 PR,我沒有。我只有自己,所以順序得反過來:先把保險買好,再談生產力。
## routine 每天都跑,你怎麼知道它真的在做事?
Boris 那串講了成果,沒講一件事:當 routine 自己出錯的時候,是誰告訴你?
我踩過三種。三種的共同點是,它們看起來都好好的。
**第一種,做了但沒發生。** 我的資料更新腳本每個工作日 14:10 跑一次,裡面有一行 `git add data/timing.json data/stock.json`。2026 年 4 月 28 日,這兩個檔被加進 `.gitignore`。`git add` 撞到 gitignore 路徑會報錯、非零退出,但那行後面接了 `2>/dev/null`,錯誤被吞掉。腳本照跑、log 照寫、退出碼被下一行蓋掉。這件事無聲跑了約 90 天沒人發現。檔案每天還是有更新,只是從那天起就不進版控了。
**第二種,警報是真的響,但是假的。** launchd 的 watchdog 每小時檢查其他 job 有沒有打卡。我用的是筆電,闔蓋睡眠的時候 launchd 不會補打那一拍,watchdog 就報斷線。我一開始每次都認真去查,查了幾次才發現要先跟 `pmset` 的睡眠紀錄對一下。現在每天早上掃告警信的那支 routine 內建這道關聯:先問「那個時段電腦是不是在睡」,只有醒著卻斷線才升成真事故。
**第三種,守門的自己壞了,還跟你說沒事。** 就是 8 月 9 日那次。
這三種失敗有一個共同點:exit code 是綠的、log 是滿的、儀表板是亮的,該發生的事卻沒有發生。
自動化最貴的地方在這裡:它出錯的樣子,跟正常運作一模一樣。
很容易把這類問題歸因於任務邊界不夠清楚。但上面三個任務的邊界都很明確:兩個檔案有沒有進版控是二元的,116 條 endpoint 的預期狀態已經寫死,退出碼是不是 3 也沒有詮釋空間。它們照樣可以無聲失敗。
分野在另一個地方:驗證層有沒有站在執行層外面。`git add` 那次,執行跟回報走的是同一條 codepath,錯誤被吞掉、退出碼被下一行覆蓋,於是「做了」和「做成了」在系統裡沒有分別。
Boris 分享的流程裡,PR 正好補上這一層。PR 加上 Claude Code Review、人工 review 和 CI,形成一條外部、可審計的驗證介面,routine 不能只靠自己宣布完成。388 個 PR 最後合併 180 個;我把中間這道落差讀成驗證層正在運作。我這邊沒有同樣的關卡,只好自己做出一批專門負責驗證的 routine。
還有一層差別跟 routine 的性格有關。進攻型 routine 的產出是可見的,今天沒開 PR,一眼就看得出來。防守型 routine 正常運作時的產出是「什麼都沒發生」,而那個狀態跟它根本沒在跑,從外面看是同一件事。
所以我後來加的東西,有一半的工作是確認事情有沒有做成。contract test 對照的是一份寫死的契約檔,逐條比對回來的 status,它問的不是系統的自我感覺。restore drill 每週日真的把備份還原一次,因為沒還原過的備份等於沒有備份。另外有一支 chaos drill runner,工作就是主動製造故障,看告警到底會不會響。
這些 routine 不直接產出內容或功能。它們唯一的工作,是證明其他 routine 沒有在說空話。
這也是我[之前寫過的那次自動化連環反咬](/articles/automation-bites-back)留下的功課:當自動化的數量超過任何單一參與者的地圖,故障的主要來源就從「元件壞掉」變成「元件都正確、但彼此不知情」。
## 那 39 個排程裡,有 28 個已經關掉了
還有一件 Boris 那串沒有展開、但企業最好提早面對的事:routine 會過期。
我那 39 個 Cowork 排程,只有 11 個還開著。關掉的 28 個裡面,有的是一次性提醒(活動起駕前改 cron、某天提醒升 wrangler 版本);有的是被合併,三個 wiki 相關的排程在 4 月 23 日併成一支每日管線,三個 GSC 相關的在 7 月 5 日併成一支月度總檢;有的是專案結束了。
每一個關掉的排程,description 欄位裡我都留了一行:已停用某月某日,由誰取代。半年後我會忘記為什麼有兩支腳本在做同一件事,那時候我能查的只有這行字。
企業導入 agent routine 之後,也會遇到同樣的問題,而且規模更大:沒人記得那支每天早上六點執行的東西當初為什麼存在,也沒人敢把它關掉。
> **📊 關鍵數據**
> - **Anthropic 端**:幾週內 388 個 PR,merge 180 個(約 46%),11 種 routine,橫跨 6 個平台
> - **我這端**:23 個 launchd job、7 條 crontab、4 個 git hook 接 11 支腳本、39 個排程定義中 11 個啟用
> - **靜默失敗最長潛伏期**:約 90 天(`git add` 撞 gitignore,錯誤被 `2>/dev/null` 吞掉)
## 把 codebase 換成 ERP,這套能平移嗎?
Boris 這套的抽象形狀是這樣:
找異常 → 找原因 → 提改善方案 → 驗證 → 留紀錄 → 人類批准 → 執行
把 codebase 換成 ERP、MES、CRM、ESG 報告、財務或採購資料,這個流程仍然可以成立。人不必每天去問 AI,agent 可以定期檢查:對帳有沒有異常、庫存週轉是否偏離、供應商的碳排資料有沒有缺漏、客訴是否出現重複樣態。
企業導入 AI 走到這裡,面對的已經不是再添購幾個工具,而是開始管理一支不下班的維運組織。
但平移的時候有兩件事要一起搬,不然會出事。
**第一件是權限分級。** 388 個 PR 最後合併 180 個,這個比例我讀成健康訊號,而不是品質不佳的直接證明。agent 架構需要按風險分級:低風險的機械性工作可以自動執行;中風險的變更進入 review;高風險的動作保留人工批准。ERP 裡改一個報表欄位,和改一張過帳規則,不該走同一條路。這件事我在寫 [Governance Harness 那篇](/articles/governance-harness-engineering) 時整理過:每一層自動化防線,背後都對應一次自律失靈的紀錄。
**第二件,就是上面講了整篇的那件事**:搬 routine 的同時,要把「怎麼知道 routine 在說實話」一起搬過去。企業評估導入時通常只算前半段的效益,很少有人在第一天就把 contract test、drift scan、restore drill 這類東西編進預算。那些東西在出事之前,看起來全都是浪費。
這兩件事在軟體業之所以比較容易,我認為有運氣成分。PR 這個機制二十年前就存在了,它剛好是一個現成的、外部的、可審計的批准介面:誰提的、改了什麼、誰看過、誰按下 merge,整條都留在系統裡。Boris 那套能跑起來,很大一部分是踩在這個現成的基礎上。
ERP、MES、CRM 裡通常沒有完全等價的東西。變更管理雖然有簽核流程,但多半是為人的操作頻率設計,未必承受得住 agent 每天提出的大量變更;系統日誌可以留下紀錄,紀錄本身卻不等於批准。企業要平移這套模式,第一關也許不是先比較模型能力,而是先替自己的系統設計一個像 PR 一樣的治理介面。
## 不能外包的那半
Boris 那句「第一次沒做對,就修 routine 讓它隔天更好」,是整串最重的一句。它意味著累積下來的資產從程式碼換成了操作知識。
但操作知識有兩半。
一半是「怎麼把事情做好」。這半 agent 學得很快,Boris 說有時候調個幾天就行。
另一半是「怎麼確認事情真的做成了」。執行與部分驗證都可以交給 agent,但驗收標準不能只由同一套系統自己定義。否則你失去的不是一道檢查,而是第二個獨立的視角。
我在[讓 codex 去挑 Claude 的錯](/articles/ai-second-opinion-independence)那篇寫過類似的結論:第二意見有沒有用,取決於你守不守得住它的獨立性。維運是同一個道理,只是尺度更大,而且沒有人會在事後幫你複查。
如果把前一階段理解成 AI 幫人寫程式,這一步的差別在於:人開始把「維護系統」這件事本身交出去。它的影響可能比 coding agent 更深,因為維護貫穿軟體生命週期,而且往往比建置持續得更久。
這篇是「[智能與秩序](/topics/ai/)」系列裡關於人機協作的一篇。同一個柱子底下,我寫過[工具長成器官之後判斷權留在誰手上](/articles/automation-bites-back),也寫過[一個人和四個 AI 視窗的治理實踐](/articles/governance-harness-engineering)。這篇補的是第三塊:當 agent 開始自己上工,你需要一套獨立於它的方式,知道它今天到底有沒有在做事。
## 明天早上它們還是會醒來
我那 23 個 job 明天早上還是會照時間醒來,跑完,打一次心跳,然後睡回去。它們大部分的日子什麼都不會發現,這正是它們該有的樣子。
我留意的是另一件事。8 月 9 日那天,如果不是我剛好去翻了一下,那行「非分歧」可能到今天還會留在那裡。
每天準時。每天全綠。
也每天回答一個它從來沒有完成驗證的問題。