# AIが毎日システムを巡回していた。番人自身が壊れるまで。
> Boris ChernyがAnthropicでClaudeを使って日常メンテナンスのroutineを回し、数週間で388件のPRを開き、180件がマージされたと共有した。私自身23個のlaunchdジョブ、7つのcrontab、11本のgit hookスクリプトを150日運用してきた経験から言えば、Agentic Operationsで最も難しいのはagentに仕事を始めさせることではない。それが本当に仕事を完遂したと確認する、独立した検証の仕組みを作ることだ。
- Author: Paul Kuo(郭曜郎)
- Date: 2026-08-14
- Pillar: 知性と秩序 / Intelligence & Order
- Tags: Agentic Operations, AI運用, 自動化ガバナンス, レジリエンス・エンジニアリング, launchd, Claude Code, サイレント障害
- Canonical: https://paulkuo.tw/ja/articles/agentic-operations-silent-failure/
- Language: Japanese (日本語)
- Translation: AI-translated from the zh-Hant (Traditional Chinese) original
- Original (zh-Hant): https://paulkuo.tw/articles/agentic-operations-silent-failure.md
- Site index for LLMs: https://paulkuo.tw/llms.txt
---
> **TL;DR**:AnthropicはClaudeに毎日Appのメンテナンスroutineを自律実行させ、数週間で388件のPRを開き、180件がマージされた。本当の転換点は、仕事の起点が人からagentへ移ったことだ。だが150日間・23個のlaunchdジョブを回してきた私が最も気にするのは別のことだ。routineが動いていることと、仕事が完遂されていることは別の話だ。実行は自動化できる。検証基準は同じシステムに決めさせてはいけない。
8月9日、ミラーへのコミットをひとまとめにpushしたとき、pre-pushのgit健全性チェックが三度連続で落ちた。画面に返ってきた言葉は「非分岐」だった。
同じpushのoriginは、実際には三コミット遅れていた。そのうちの一つはセキュリティ修正だった。
チェックは嘘をついていない。ただ、検出が完了しないまま落ちて、私がかつてハードコードした文字列どおりに、一度も検証しなかった結論を返しただけだ。
あの一行を後で「分岐状態不明(検出未完了)」に書き直し、隣に将来の自分へのメモを残した。「非分岐」という表現には戻さないこと。チェックが落ちた時点で、分岐しているかどうかは不明であり、否定されたわけではない。
五日後、Boris Chernyの[Threadsのスレッド](https://www.threads.com/share/Hz4w8ezD4/)を見た。
## AnthropicがClaudeに毎日388件のPRを開かせた。それは何を意味するのか
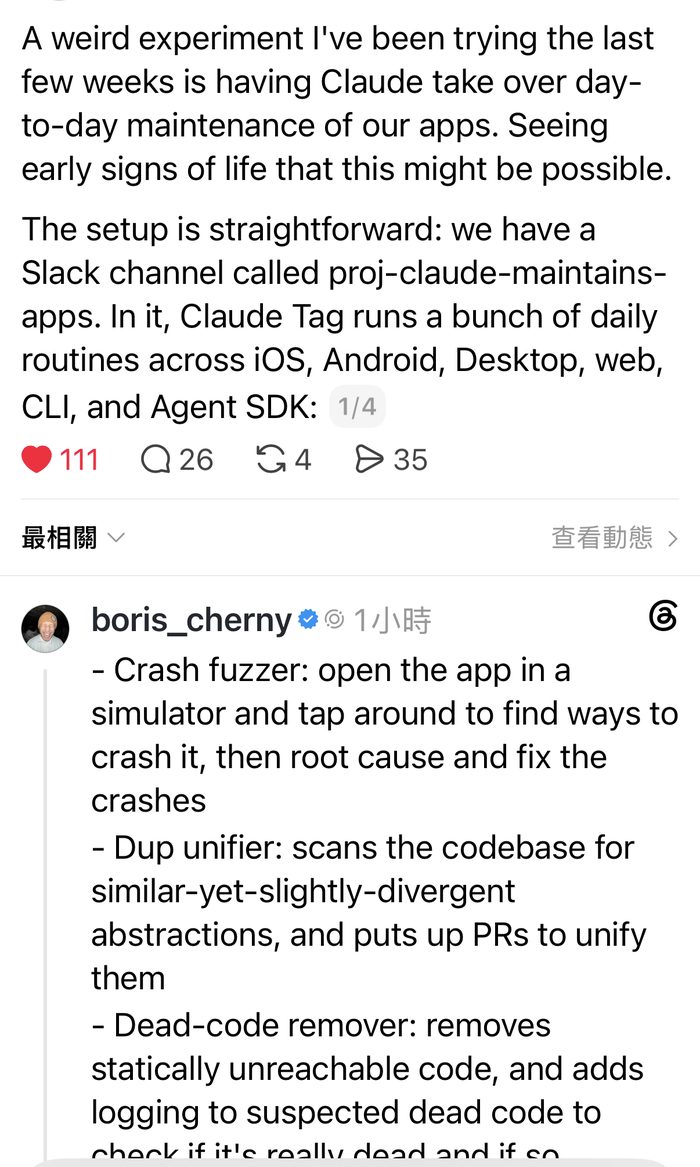
Boris Chernyは[Claude Codeの生みの親であり責任者だ](https://www.linkedin.com/in/bcherny/)。チームが`proj-claude-maintains-apps`というSlackチャンネルを作り、ClaudeがそこでiOS・Android・Desktop・web・CLI・Agent SDKを横断するメンテナンスroutineを毎日定期的に走らせていると説明した。
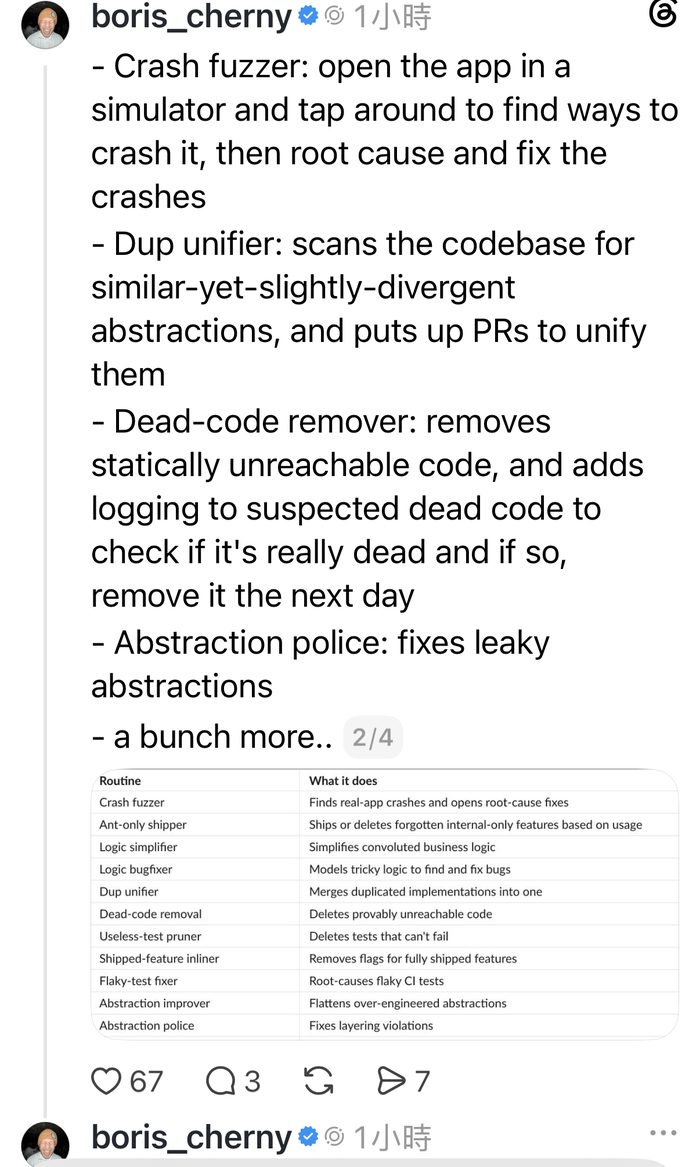
- **Crash fuzzer**:シミュレーター上でAppを自動操作し、クラッシュを能動的に探して根本原因を追い、修正PRを開く
- **Dup unifier**:コードベースをスキャンして機能が似ているが少しずつ乖離した実装を見つけ、統一するPRを開く
- **Dead-code remover**:到達不能なコードを削除する。確信が持てない場合はまずloggingを加え、翌日の実行状況を見てから削除を判断する
- **Logic simplifier / bugfixer**:複雑なビジネスロジックを単純化し、論理の抜け穴を見つけるモデルを構築する
- **Flaky-test fixer**:不安定なCIテストの根本原因を追う
- **Useless-test pruner**:絶対にfailしないテストを削除する
- **Abstraction improver / police**:過剰なエンジニアリングの抽象化と、アーキテクチャ層の違反を処理する
スレッド1/4と2/4。左が実験の説明とSlackチャンネル、右が11種のroutineの内訳。
出典:Boris Cherny(@boris_cherny)on Threads
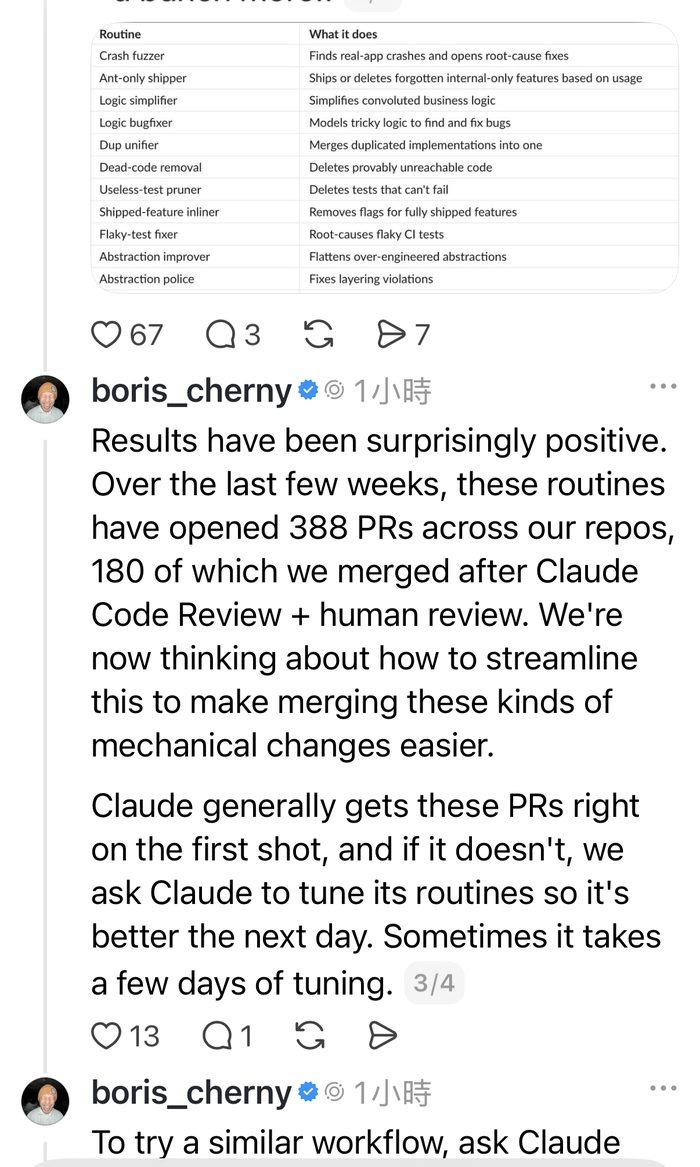
数週間で、これらのroutineがリポジトリに388件のPRを開き、Claude Code Reviewと人によるレビューを経て180件がマージされた。
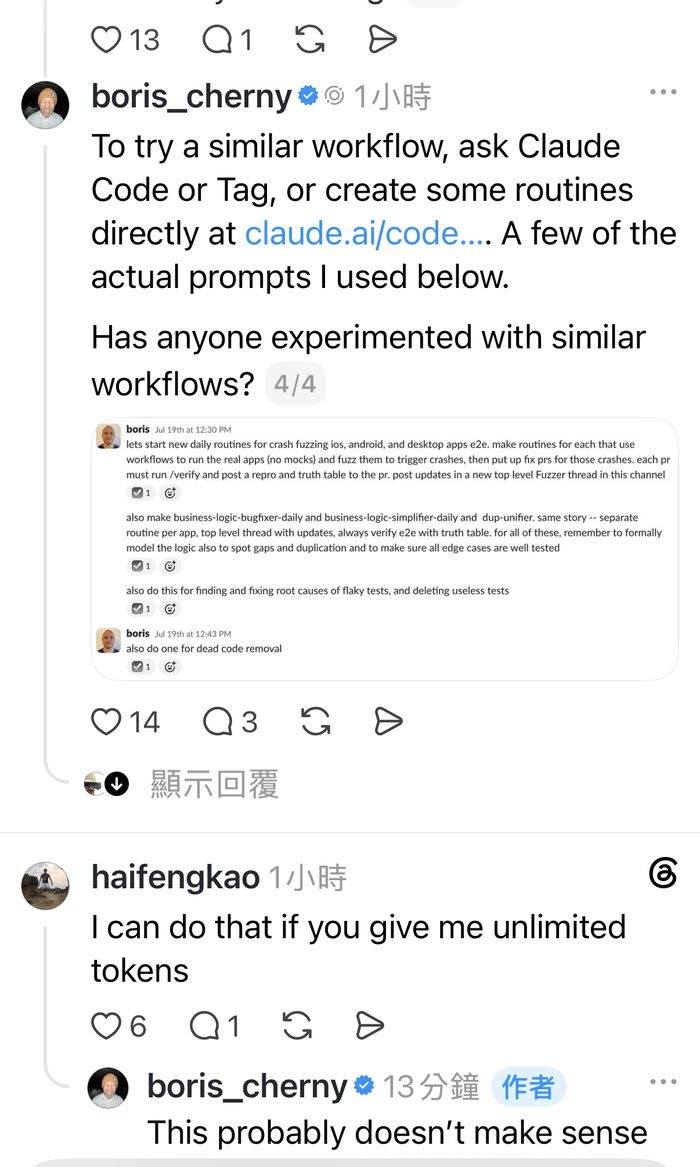
スレッド3/4と4/4。左が数週間の成果数字、右が7月19日にClaudeへ送ったプロンプトの原文。
出典:Boris Cherny(@boris_cherny)on Threads
このスレッドを読んで私が注目したのは、Claudeのコーディング能力がどれだけ上がったかではない。仕事の起点が変わったことだ。
従来の流れ:人が問題を見つけ、指示を出し、AIがコードを書く。
新しい流れ:人がルールとガバナンスの境界を定義し、agentがシステムを継続的に観察し、問題を発見し、修正し、テストし、PRを開き、レビューし、学習し、翌日また走る。
Borisのスレッドで私にとって最も重い一文は三段落目にある。最初にうまくいかなかったら、routineを修正してClaudeが翌日より良くできるようにする。数日調整が必要なこともある。これが意味するのは、会社に蓄積されるものがコードだけではなく、「この会社がどうやってソフトウェアをメンテナンスするか」という運用知識まで含まれるようになったということだ。
以前は工学の経験をSOP・コーディングガイドライン・CI/CDパイプラインとして文書化していた。次の段階では、その経験を毎日仕事に来るagent routineの群れとして書き込んでいく。
Copilotの典型的なモデルは人が仕事を起こし、AIが脇で助ける形だ。このパターンではagentが日常の実行を担い、人はガバナンス・審査・例外処理の側へ退く。Borisは6月のFortune誌のインタビューで、すでに8か月間コードを手書きしていないと話した。日によっては、数百・数千、場合によっては数万のagentを同時に管理している。その規模では、メンテナンスroutineを一つひとつ見張ることはもはや不可能だ。
## 個人サイト一つを守るのに、自動化はいくつ必要か
あのスレッドを見て共鳴したのは、私自身がずっと小さな規模で似たことを150日間続けているからだ。
今このMacには、`launchctl list`で23個の自作ジョブが動いている。いくつか挙げると:
- **毎日09:00**:contract test。`auth-contract.json`から約116件のエンドポイント契約を読み込み、一件ずつcurlしてステータスを比較する。全件グリーンならBetterStackにハートビートを一回打ち、一件でもfailならexit 1を返してtodoファイルに問題を追記する。
- **毎日10:00**:governance scanner。最近のコミットで共有ファイルに触れたのに影響範囲のタグが抜けていないかをスキャンする。
- **毎週日曜10:00**:drift scan。契約と実際の実装が乖離していないかを比較する。
- **毎週日曜05:00**:restore drill。バックアップのリポジトリバンドルを使って実際に復元を実行する。
- **毎時5分**:launchd watchdog。他のジョブが時刻どおりにチェックインしているかを確認する。
- **48時間ごと**:リポジトリ健全性チェック。
- **毎日04:00**:リポジトリ全体をバンドルとしてパッケージしてR2にアップロードする。
crontabには別に7つのエントリがあり、主にデータ取得と三か所への分散バックアップを担当する。git hookは4つ(`commit-msg`・`pre-commit`・`post-commit`・`pre-push`)で、11本のスクリプトを呼び出す。gitleaksによるシークレットスキャン・PIIゲート・URL境界チェック・wiki schemaのenumチェック・skillバージョンゲート・AIくさいコードのlint、それにpost-commitのskill同期スクリプトが四本だ。
Cowork側には39個のスケジュール定義があり、そのうち11個がまだ動いている。朝8時の管制塔レポート、9時38分に運用アラートメールをスキャン、9時45分にFitbitトークンの切断チェック、10時09分にwikiの素材パイプラインを走らせ、10時35分にプロジェクト横断のガバナンス集計、11時33分にその日の読書メモをテーマ別に要約する。
Borisのroutineは主に「直すものを探す」ものだ。クラッシュ・重複実装・デッドコード・不安定または無効なテストを。私のroutineはほぼすべて「まだ生きているかを確認する」ものだ。契約が壊れていないか、ミラーがずれていないか、バックアップが復元できるか、ハートビートが途切れていないか。
この差は規模から来る。AnthropicにはあのPRをレビューするチームがいる。私にはいない。自分一人だから、順序を逆にするしかない。まず保険を買ってから、生産性の話をする。
## routineは毎日動いている。でも本当に仕事をしているとどうやって知るのか
Borisのスレッドは成果を語っているが、一つのことには触れていない。routineが自分でエラーを起こしたとき、それを誰が教えてくれるのか。
私は三種類を踏んだ。三種類に共通するのは、どれも外から見たら正常に見えることだ。
**第一の種類:実行されたが完遂されなかった。** データ更新スクリプトは毎営業日14:10に動き、その中に`git add data/timing.json data/stock.json`という一行がある。2026年4月28日、この二ファイルが`.gitignore`に追加された。gitignoreのパスに`git add`がぶつかるとエラーが出て非ゼロで終了するが、その行の後ろに`2>/dev/null`が付いていたためエラーが飲まれた。スクリプトは走り続け、logは書かれ続け、exit codeは次の行で上書きされた。約90日間、誰にも気づかれなかった。ファイルは毎日更新されていたが、その日以降はバージョン管理に入っていなかった。
**第二の種類:アラートは本当に鳴ったが、偽物だった。** launchd watchdogは毎時間、他のジョブがチェックインしているかを確認する。私はノートパソコンを使っている。蓋を閉じてスリープ中はlaunchdがその拍を補わないので、watchdogは切断を報告する。最初は毎回まじめに調査していたが、何度か調べてようやく`pmset`のスリープ履歴と突き合わせる必要があるとわかった。今では毎朝アラートメールをスキャンするroutineにこの照合が組み込まれている。「その時間帯にPCがスリープしていたか」を先に確認して、起きていたのに切断されていた場合だけ本当の障害として扱う。
**第三の種類:番人自身が壊れたまま、安全と報告し続けた。** 8月9日がまさにそれだ。
この三種類に共通することが一つある。exit codeは緑で、logは埋まっていて、ダッシュボードは光っている。それでも、起きるべきことが起きていない。
自動化で最も厄介なのはここだ。エラーの見た目が、正常動作と区別できない。
この種の問題をタスクの境界が不明確だったからと片付けるのは簡単だ。だが上の三つはどれも境界が明確だった。二つのファイルがバージョン管理に入ったかどうかは二値だし、116件のエンドポイントの期待するステータスはハードコードされているし、exit codeが3かどうかに解釈の余地はない。それでもサイレントに障害になれる。
分水嶺は別のところにある。検証層が実行層の外に立っているかどうかだ。`git add`のケースでは、実行と報告が同じコードパスを通っており、エラーが飲まれてexit codeが上書きされたため、「実行された」と「完遂された」がシステム内で区別されなかった。
Borisが共有したフローでは、PRがその層を補う。PRにClaude Code Reviewと人によるレビューとCIが加わり、外部から監査可能な検証インターフェースが形成される。routineは自分だけで完了を宣言できない。388件のPRのうち180件がマージされたという差を、私は検証層が機能しているサインとして読む。私の側には同じ関門がないため、検証専用のroutineを自分で用意するしかなかった。
もう一つの差はroutineの性格に関係する。攻撃型routineの成果は目に見える。今日PRが開かれなければ一目でわかる。守備型routineが正常に機能しているときの成果は「何も起きない」であり、その状態はroutineがまったく動いていない状態と、外から見たら同じだ。
だから私が後から加えたものの半分は、仕事が完遂されたかどうかを確認することを仕事にしている。contract testが照合するのは固定の契約ファイルで、返ってきたステータスを一件ずつ比較する。システムの自己申告を問うのではない。restore drillは毎週日曜に実際にバックアップから復元する。一度も復元したことのないバックアップはバックアップではないからだ。chaos drill runnerは意図的に障害を起こして、アラートが本当に鳴るかを確かめる。
これらのroutineはコンテンツも機能も直接生み出さない。その唯一の仕事は、他のroutineが嘘をついていないことを証明することだ。
これは[以前書いた自動化の連鎖的な反咬み](/ja/articles/automation-bites-back)が残した教訓でもある。自動化の数が関係者の誰一人の把握も超えると、障害の主な原因は「コンポーネントが壊れた」から「コンポーネントはどれも正しく動いているが、互いに知らない」へと変わる。
## 39個のスケジュールのうち、28個はもう止まっている
Borisのスレッドが展開しなかった、でも企業が早めに向き合った方がいいことがもう一つある。routineは劣化する。
私のCoworkの39個のスケジュール定義のうち、動いているのは11個だけだ。止まっている28個の内訳を見ると、一回限りのリマインダー(イベント前のcron変更・wranglerのバージョンアップ通知)もあれば、統合されたものもある。wiki関連の三つのスケジュールは4月23日に一本の日次パイプラインに束ねられ、GSC関連の三つは7月5日に一本の月次総点検に統合された。プロジェクトが終わって止まったものもある。
止まった各スケジュールのdescriptionフィールドには一行残している。停止日・何に引き継がれたか。半年後には、なぜ二本のスクリプトが同じことをやっているのかを忘れている。そのときに参照できるのはその一行だけだ。
企業がagent routineを導入した後も、同じ問題に突き当たる。しかも規模がずっと大きい。毎朝6時に動いているあれが、なぜ存在するのか誰も覚えていない。でも誰も止められない。
> **📊 主要データ**
> - **Anthropic側**:数週間で388件のPR、マージ180件(約46%)、11種のroutine、6プラットフォームを横断
> - **私の側**:23個のlaunchdジョブ、7つのcrontab、4つのgit hookが11本のスクリプトを呼び出す、39個のスケジュール定義のうち11個が有効
> - **サイレント障害の最長潜伏期間**:約90日間(`git add`がgitignoreにぶつかり、エラーが`2>/dev/null`に飲まれた)
## コードベースをERPに置き換えたとき、このパターンは移植できるか
Borisのこの仕組みの抽象的な形はこうだ。
異常を見つける → 原因を探る → 改善案を提示する → 検証する → 記録を残す → 人間が承認する → 実行する
コードベースをERP・MES・CRM・ESGレポート・財務データ・調達データに置き換えても、この流れは成立する。人が毎日AIに問いかける必要はない。agentが定期的に確認できる、照合に異常はないか、在庫回転が基準から外れていないか、サプライヤーの炭素排出データに欠損はないか、クレームに繰り返しのパターンが出ていないか。
企業がAI導入をここまで進めると、直面するのはもはやツールをいくつか追加することではない。休まない運用組織を管理することだ。
だが移植するとき、二つのものを一緒に持っていかないと後で問題になる。
**一つ目は権限の分級だ。** 388件のPRのうち180件がマージされたという比率を、私は健全なサインとして読む、品質不足の直接的な証拠としてではなく。agentのアーキテクチャはリスクに応じた分級が必要だ。低リスクの機械的な作業は自動実行、中リスクの変更はレビューへ、高リスクのアクションは人による承認を残す。ERPで帳票の項目を一つ変えることと、転記ルールを変えることは、同じ経路を通るべきではない。この点は[Governance Harness の記事](/ja/articles/governance-harness-engineering)でも整理した。自動化の各防衛層の背後には、規律が崩れた記録が一つずつある。
**二つ目は、この記事で書き続けてきたことだ。** routineを移植するとき、「routineが本当のことを言っているかをどう知るか」という検証層も一緒に移植しなければならない。導入を評価する企業はたいてい前半の効果だけを計算する。contract test・drift scan・restore drillのような仕組みを最初から予算に入れる人はほとんどいない。問題が起きるまで、それらは純粋なコストにしか見えないからだ。
この二つがソフトウェア業界では比較的やりやすい理由の一つに、運の要素があると思う。PRという仕組みが二十年前から存在していた。誰が変更を提案し、何を変えて、誰がレビューし、誰がマージを押したか。外部から監査可能な承認インターフェースがすでにあった。Borisのこの仕組みが動く理由の大きな部分は、この既存の土台を踏んでいることにある。
ERP・MES・CRMには完全に等価なものがない。変更管理に承認フローはあるが、たいていは人の操作頻率に合わせて設計されており、agentが毎日大量に提出する変更を受け止めるようにはできていない。システムログは記録を残すが、記録があることは承認があることと同じではない。企業がこのパターンを移植するとき、最初の問いはモデル性能の比較ではないかもしれない。自分たちのシステムにPRに相当するガバナンス・インターフェースをどう設計するか、そこから始める方が正しい。
## 外注できない半分
Borisの「最初にうまくいかなかったら、routineを修正してClaudeが翌日より良くできるようにする」という一文が、スレッド全体で私に最も重く響いた。蓄積される資産がコードから運用知識へ広がったことを意味するからだ。
だが運用知識には二つの半分がある。
一つは「いかに仕事をうまくやるか」だ。この半分はagentが速く学ぶ。Borisによれば数日調整すれば済む場合もある。
もう一つは「仕事が本当に完遂されたとどうやって確認するか」だ。実行と部分的な検証はagentに委ねられる。だが検証の基準は、同じシステムだけに決めさせてはいけない。そうなると失うのは一つのチェックではなく、独立した第二の視点だ。
[codexにClaudeの誤りを指摘させた記事](/ja/articles/ai-second-opinion-independence)で似た結論を書いた。第二の意見が機能するかどうかは、その独立性を守り続けられるかにかかっている。運用も同じ原理だ。ただスケールが大きく、事後に誰かが代わりに確認してくれることもない。
前の段階をAIが人のコード作成を助ける時代と理解するなら、このステップの差はここにある。人が「システムのメンテナンス」という仕事そのものを手放し始めている。その影響はコーディングagentより深いかもしれない。メンテナンスはソフトウェアのライフサイクル全体を貫いており、たいていは構築よりも長く続くからだ。
この記事は「[知性と秩序](/ja/topics/ai/)」シリーズの人機協働を扱う一篇だ。同じ柱の下で、[ツールが器官になった後、判断の権限は誰に残るか](/ja/articles/automation-bites-back)を書き、[一人と四つのAIウィンドウのガバナンス実践](/ja/articles/governance-harness-engineering)も書いた。この記事が補うのは三つ目のピースだ。agentが自律的に仕事を始めるとき、それとは独立した方法で、今日本当に仕事をしたかどうかを知る仕組みが必要だ。
## 明日の朝、それらはまた目を覚ます
23個のジョブは明日の朝も時刻どおりに起き、走り終えて、ハートビートを一回打ち、また眠りに戻る。ほとんどの日は何も見つからない。それが正しい姿だ。
私が気にしているのは別のことだ。8月9日、もし偶然に確認しに行かなかったら、あの「非分岐」という一行は今日もそこに残っていたかもしれない。
毎日、時刻どおりに。毎日、全件グリーン。
そして毎日、一度も検証を完了していない問いに答え続けていた。