# AI 每天替我巡系统,直到守门的那一支自己坏掉
> Boris Cherny 分享 Anthropic 以 Claude 执行日常维护 routine,几周内开出 388 个 PR,其中 180 个合并。从我自己维运 23 个 launchd job、7 条 crontab 与 11 支 git hook 脚本的经验来看,Agentic Operations 最难的部分不是让 agent 开始工作,而是建立一套独立的方法,确认它真的把事情做成了。
- Author: Paul Kuo(郭曜郎)
- Date: 2026-08-14
- Pillar: 智能与秩序 / Intelligence & Order
- Tags: Agentic Operations, AI 维运, 自动化治理, 韧性工程, launchd, Claude Code, 静默失败
- Canonical: https://paulkuo.tw/zh-cn/articles/agentic-operations-silent-failure/
- Language: Simplified Chinese (简体中文)
- Translation: AI-translated from the zh-Hant (Traditional Chinese) original
- Original (zh-Hant): https://paulkuo.tw/articles/agentic-operations-silent-failure.md
- Site index for LLMs: https://paulkuo.tw/llms.txt
---
> **TL;DR**:Anthropic 让 Claude 每天自主执行 App 维护 routine,几周内开出 388 个 PR,其中 180 个合并。真正的转折,是工作的发起端从人换成 agent。但我跑了 150 天、目前挂着 23 个 launchd job 之后,最在意的反而是另一件事:routine 跑得动,不代表事情真的做成了。执行可以自动化,验证标准不能由同一套系统自己决定。
8 月 9 日那天,我推一批 commit 到镜像,pre-push 的 git 健检连续崩了三次。它印给我的字是「非分歧」。
而同一次 push 的 origin,其实正落后三个 commit,其中一个是 security fix。
健检没有说谎。它只是崩在侦测还没跑完的地方,然后照着我当初写死的字符串,回报一个它根本没验证过的结论。
我后来把那行字改成「分歧状态未知(侦测未完成)」,旁边留了一句给未来的自己:措辞不可再改回「非分歧」。健检一旦崩溃,分歧与否就是未知,不是已排除。
五天后我看到 Boris Cherny [在 Threads 上发的那一串](https://www.threads.com/share/Hz4w8ezD4/)。
## Anthropic 让 Claude 每天开 388 个 PR,这代表什么?
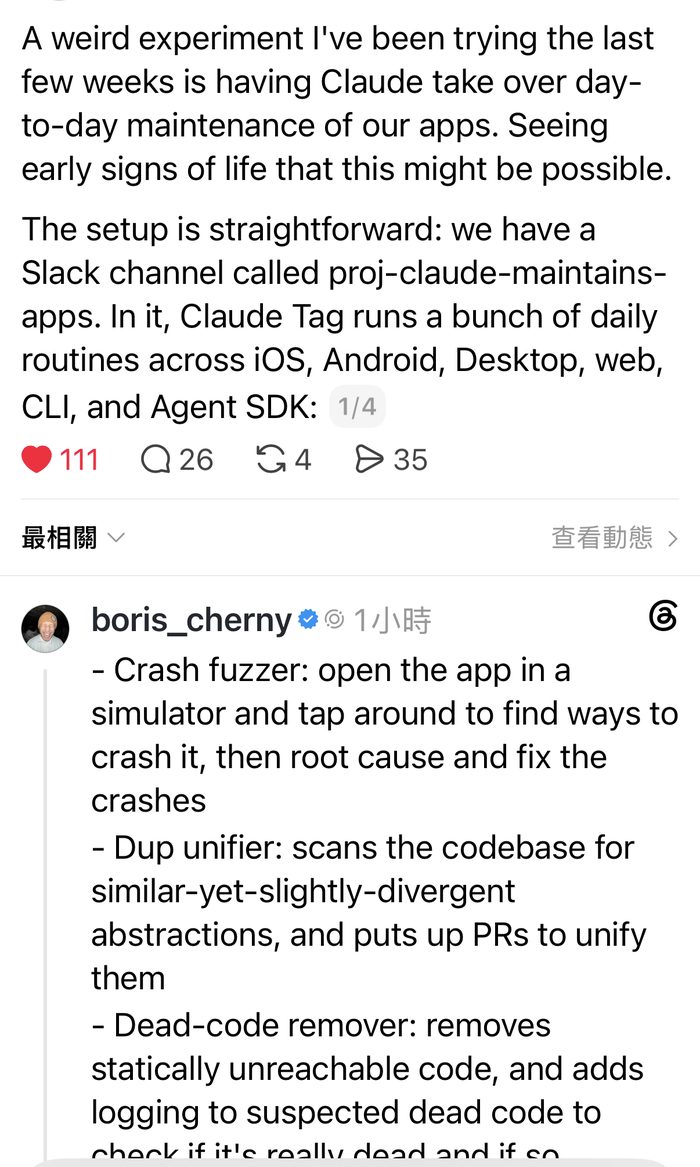
Boris Cherny 是 [Claude Code 的创造者兼负责人](https://www.linkedin.com/in/bcherny/)。他说团队开了一个 Slack channel 叫 `proj-claude-maintains-apps`,让 Claude 每天在里面固定跑一批维护 routine,横跨 iOS、Android、Desktop、web、CLI 和 Agent SDK:
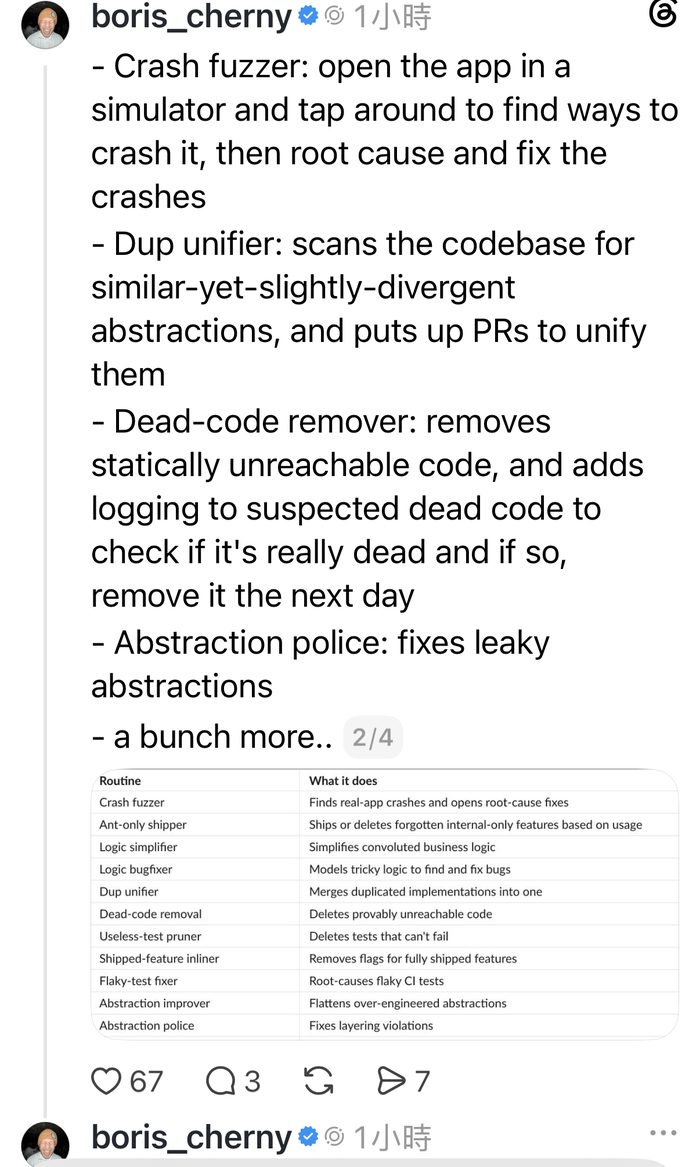
- **Crash fuzzer**:在模拟器里操作 App,主动找出 crash,追根因,开修复 PR
- **Dup unifier**:扫 codebase 找功能相似但逐渐分岔的实现,开 PR 统一它们
- **Dead-code remover**:删确定不可达的代码;不确定的先加 logging,隔天根据实际执行情况再判断
- **Logic simplifier / bugfixer**:简化复杂的业务逻辑,并建立模型去找逻辑漏洞
- **Flaky-test fixer**:追不稳定 CI test 的根因
- **Useless-test pruner**:删永远不会 fail 的 test
- **Abstraction improver / police**:处理过度工程化的抽象,以及架构分层违规
串文 1/4 与 2/4。左边是实验说明与那个 Slack channel,右边列出 11 种 routine 各自负责什么。
来源:Boris Cherny(@boris_cherny)于 Threads
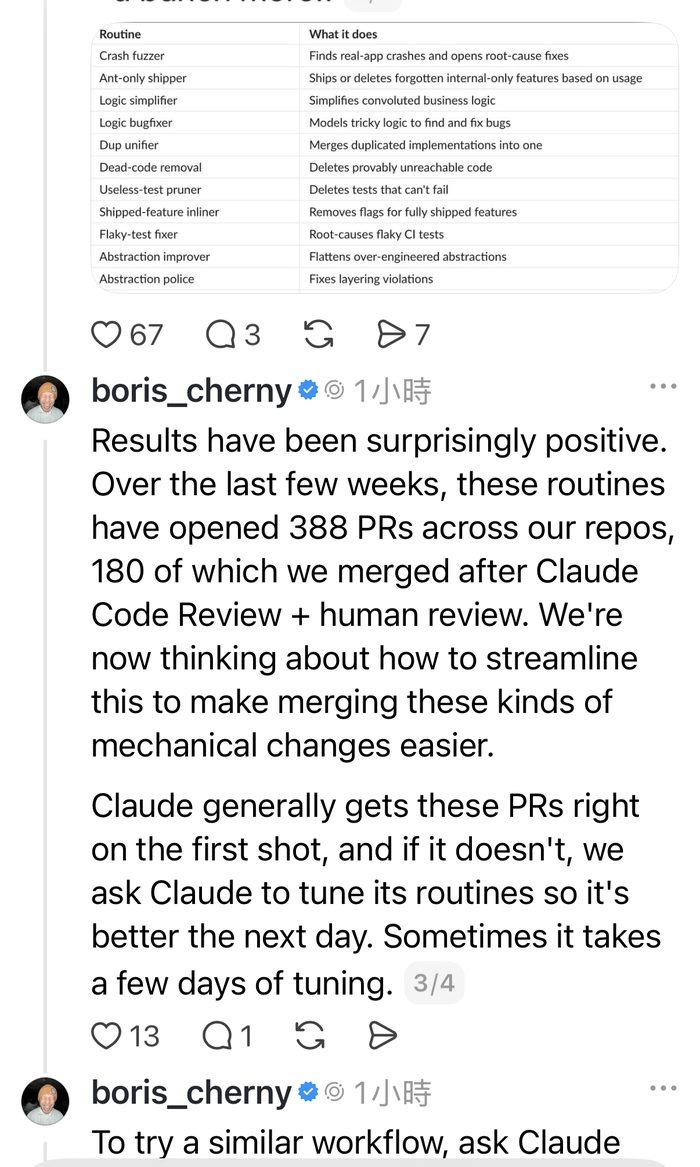
几周下来,这些 routine 在他们的 repo 开了 388 个 PR,经 Claude Code Review 加人工 review 后 merge 了 180 个。
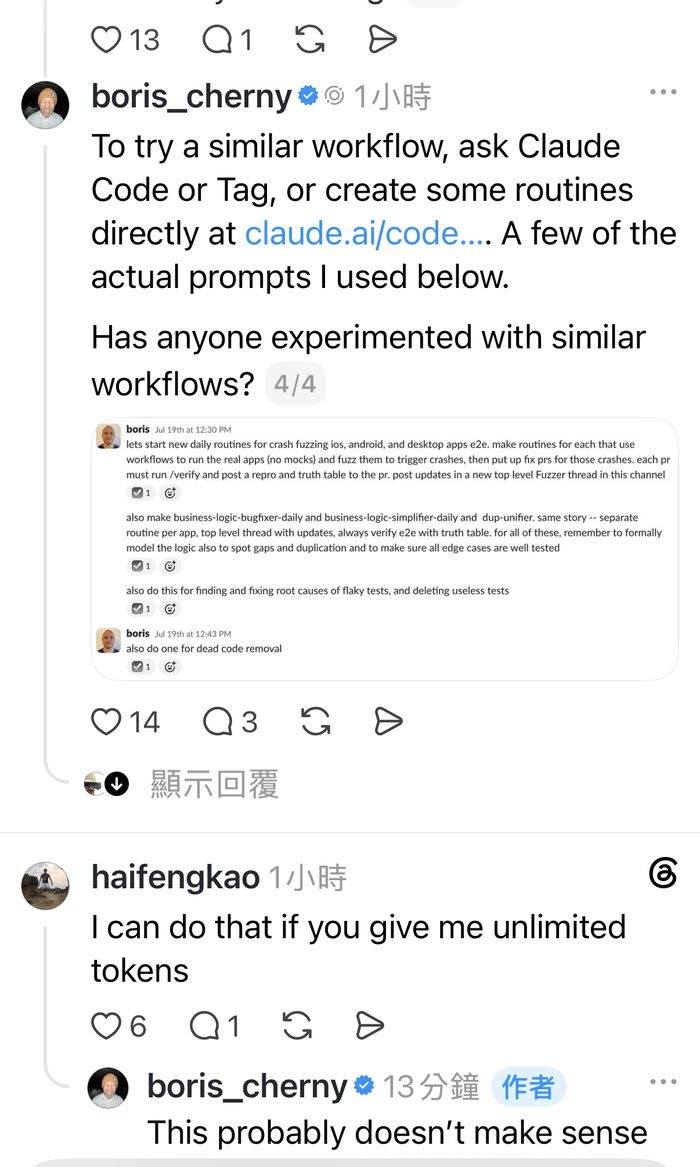
串文 3/4 与 4/4。左边是几周下来的成果数字,右边是他 7 月 19 日实际下给 Claude 的 prompt 原文。
来源:Boris Cherny(@boris_cherny)于 Threads
我读这串,注意的不是 Claude 的 coding 能力又变强多少,而是工作的发起端换人了。
原本的流程是:人发现问题,下指令,AI 写代码。
现在的流程是:人定义规则与治理边界,agent 持续观察系统,发现问题,修改,测试,开 PR,review,学习,隔天再跑一次。
Boris 那串里,对我来说最重的一句在第三段:第一次没做对,就修改 routine,让 Claude 隔天做得更好;有时需要调整几天。这意味着,公司累积下来的不再只有代码,还包括「这间公司怎么维护软件」的操作知识。
以前公司把工程经验写成 SOP、coding guideline、CI/CD pipeline。下一阶段,是把这些经验写成一群每天上工的 agent routine。
Copilot 的典型模式,是人发起工作,AI 在旁边协助。到了这套模式,agent 开始承接日常执行,人退到治理、审核与例外处理的位置。Boris 六月接受 Fortune 访问时说,他已经八个月没有手写代码;有些日子,他同时管理的是数百、数千,甚至数万个 agent。到了那个规模,维护 routine 已经不可能逐一盯着看。
## 一个人的网站,需要几个自动化才守得住?
我看到那串会有感,是因为我在小得多的规模上做着类似的事,已经 150 天。
现在这台 Mac 上,`launchctl list` 挂着 23 个我自己的 job。挑几个说:
- **每日 09:00**:contract test。从一份 `auth-contract.json` 读约 116 条 endpoint 契约,逐条 curl、抓 status、比对 expect。全绿就对 BetterStack 打一次心跳,任一条 fail 就 exit 1 并把问题 append 进待办文件。
- **每日 10:00**:governance scanner,扫近期 commit 有没有动到共用文件却漏标影响范围。
- **每周日 10:00**:drift scan,比对契约和实际实现有没有漂移。
- **每周日 05:00**:restore drill,拿备份的 repo bundle 实际还原一次。
- **每小时第 5 分**:launchd watchdog,检查其他 job 有没有照时间打卡。
- **每 48 小时**:repo health check。
- **每天 04:00**:把整个 repo 打包成 bundle 上传 R2。
crontab 另外有 7 条,主要是数据抓取和三处异地备份。git hook 挂着 4 个(`commit-msg`、`pre-commit`、`post-commit`、`pre-push`),背后接 11 支脚本:gitleaks 扫密钥、PII gate、URL 边界检查、wiki schema enum 检查、skill 版本 gate、AI 味 lint,还有四支 post-commit 的 skill 同步。
Cowork 那边有 39 个排程定义,其中 11 个还开着:早上八点的控制塔早报、九点三十八分扫维运告警信、九点四十五分检查 Fitbit token 是否断线、十点零九分跑 wiki 素材管线、十点三十五分跑跨项目治理汇整、十一点三十三分把当天的阅读笔记做成主题综述。
Boris 那批 routine 多半在找东西修:crash、重复实现、死码、不稳定或无效的 test。我这批则几乎都在确认东西还活着:契约没破、镜像没歪、备份还原得回来、心跳没断。
差别来自规模。Anthropic 有团队可以 review 那 388 个 PR,我没有。我只有自己,所以顺序得反过来:先把保险买好,再谈生产力。
## routine 每天都跑,你怎么知道它真的在做事?
Boris 那串讲了成果,没讲一件事:当 routine 自己出错的时候,是谁告诉你?
我踩过三种。三种的共同点是,它们看起来都好好的。
**第一种,做了但没发生。** 我的数据更新脚本每个工作日 14:10 跑一次,里面有一行 `git add data/timing.json data/stock.json`。2026 年 4 月 28 日,这两个文件被加进 `.gitignore`。`git add` 撞到 gitignore 路径会报错、非零退出,但那行后面接了 `2>/dev/null`,错误被吞掉。脚本照跑、log 照写、退出码被下一行盖掉。这件事无声跑了约 90 天没人发现。文件每天还是有更新,只是从那天起就不进版控了。
**第二种,警报是真的响,但是假的。** launchd 的 watchdog 每小时检查其他 job 有没有打卡。我用的是笔电,阖盖睡眠的时候 launchd 不会补打那一拍,watchdog 就报断线。我一开始每次都认真去查,查了几次才发现要先跟 `pmset` 的睡眠记录对一下。现在每天早上扫告警信的那支 routine 内建这道关联:先问「那个时段电脑是不是在睡」,只有醒着却断线才升成真事故。
**第三种,守门的自己坏了,还跟你说没事。** 就是 8 月 9 日那次。
这三种失败有一个共同点:exit code 是绿的、log 是满的、仪表板是亮的,该发生的事却没有发生。
自动化最贵的地方在这里:它出错的样子,跟正常运作一模一样。
很容易把这类问题归因于任务边界不够清楚。但上面三个任务的边界都很明确:两个文件有没有进版控是二元的,116 条 endpoint 的预期状态已经写死,退出码是不是 3 也没有诠释空间。它们照样可以无声失败。
分野在另一个地方:验证层有没有站在执行层外面。`git add` 那次,执行跟回报走的是同一条 codepath,错误被吞掉、退出码被下一行覆盖,于是「做了」和「做成了」在系统里没有分别。
Boris 分享的流程里,PR 正好补上这一层。PR 加上 Claude Code Review、人工 review 和 CI,形成一条外部、可审计的验证界面,routine 不能只靠自己宣布完成。388 个 PR 最后合并 180 个;我把中间这道落差读成验证层正在运作。我这边没有同样的关卡,只好自己做出一批专门负责验证的 routine。
还有一层差别跟 routine 的性格有关。进攻型 routine 的产出是可见的,今天没开 PR,一眼就看得出来。防守型 routine 正常运作时的产出是「什么都没发生」,而那个状态跟它根本没在跑,从外面看是同一件事。
所以我后来加的东西,有一半的工作是确认事情有没有做成。contract test 对照的是一份写死的契约文件,逐条比对回来的 status,它问的不是系统的自我感觉。restore drill 每周日真的把备份还原一次,因为没还原过的备份等于没有备份。另外有一支 chaos drill runner,工作就是主动制造故障,看告警到底会不会响。
这些 routine 不直接产出内容或功能。它们唯一的工作,是证明其他 routine 没有在说空话。
这也是我[之前写过的那次自动化连环反咬](/zh-cn/articles/automation-bites-back)留下的功课:当自动化的数量超过任何单一参与者的地图,故障的主要来源就从「组件坏掉」变成「组件都正确、但彼此不知情」。
## 那 39 个排程里,有 28 个已经关掉了
还有一件 Boris 那串没有展开、但企业最好提早面对的事:routine 会过期。
我那 39 个 Cowork 排程,只有 11 个还开着。关掉的 28 个里面,有的是一次性提醒(活动起驾前改 cron、某天提醒升 wrangler 版本);有的是被合并,三个 wiki 相关的排程在 4 月 23 日并成一支每日管线,三个 GSC 相关的在 7 月 5 日并成一支月度总检;有的是项目结束了。
每一个关掉的排程,description 字段里我都留了一行:已停用某月某日,由谁取代。半年后我会忘记为什么有两支脚本在做同一件事,那时候我能查的只有这行字。
企业导入 agent routine 之后,也会遇到同样的问题,而且规模更大:没人记得那支每天早上六点执行的东西当初为什么存在,也没人敢把它关掉。
> **📊 关键数据**
> - **Anthropic 端**:几周内 388 个 PR,merge 180 个(约 46%),11 种 routine,横跨 6 个平台
> - **我这端**:23 个 launchd job、7 条 crontab、4 个 git hook 接 11 支脚本、39 个排程定义中 11 个启用
> - **静默失败最长潜伏期**:约 90 天(`git add` 撞 gitignore,错误被 `2>/dev/null` 吞掉)
## 把 codebase 换成 ERP,这套能平移吗?
Boris 这套的抽象形状是这样:
找异常 → 找原因 → 提改善方案 → 验证 → 留记录 → 人类批准 → 执行
把 codebase 换成 ERP、MES、CRM、ESG 报告、财务或采购数据,这个流程仍然可以成立。人不必每天去问 AI,agent 可以定期检查:对账有没有异常、库存周转是否偏离、供应商的碳排数据有没有缺漏、客诉是否出现重复样态。
企业导入 AI 走到这里,面对的已经不是再添购几个工具,而是开始管理一支不下班的维运组织。
但平移的时候有两件事要一起搬,不然会出事。
**第一件是权限分级。** 388 个 PR 最后合并 180 个,这个比例我读成健康信号,而不是质量不佳的直接证明。agent 架构需要按风险分级:低风险的机械性工作可以自动执行;中风险的变更进入 review;高风险的动作保留人工批准。ERP 里改一个报表字段,和改一张过账规则,不该走同一条路。这件事我在写 [Governance Harness 那篇](/zh-cn/articles/governance-harness-engineering) 时整理过:每一层自动化防线,背后都对应一次自律失灵的记录。
**第二件,就是上面讲了整篇的那件事**:搬 routine 的同时,要把「怎么知道 routine 在说实话」一起搬过去。企业评估导入时通常只算前半段的效益,很少有人在第一天就把 contract test、drift scan、restore drill 这类东西编进预算。那些东西在出事之前,看起来全都是浪费。
这两件事在软件业之所以比较容易,我认为有运气成分。PR 这个机制二十年前就存在了,它刚好是一个现成的、外部的、可审计的批准界面:谁提的、改了什么、谁看过、谁按下 merge,整条都留在系统里。Boris 那套能跑起来,很大一部分是踩在这个现成的基础上。
ERP、MES、CRM 里通常没有完全等价的东西。变更管理虽然有签核流程,但多半是为人的操作频率设计,未必承受得住 agent 每天提出的大量变更;系统日志可以留下记录,记录本身却不等于批准。企业要平移这套模式,第一关也许不是先比较模型能力,而是先替自己的系统设计一个像 PR 一样的治理界面。
## 不能外包的那半
Boris 那句「第一次没做对,就修 routine 让它隔天更好」,是整串最重的一句。它意味着累积下来的资产从代码换成了操作知识。
但操作知识有两半。
一半是「怎么把事情做好」。这半 agent 学得很快,Boris 说有时候调个几天就行。
另一半是「怎么确认事情真的做成了」。执行与部分验证都可以交给 agent,但验收标准不能只由同一套系统自己定义。否则你失去的不是一道检查,而是第二个独立的视角。
我在[让 codex 去挑 Claude 的错](/zh-cn/articles/ai-second-opinion-independence)那篇写过类似的结论:第二意见有没有用,取决于你守不守得住它的独立性。维运是同一个道理,只是尺度更大,而且没有人会在事后帮你复查。
如果把前一阶段理解成 AI 帮人写代码,这一步的差别在于:人开始把「维护系统」这件事本身交出去。它的影响可能比 coding agent 更深,因为维护贯穿软件生命周期,而且往往比建置持续得更久。
这篇是「[智能与秩序](/zh-cn/topics/ai/)」系列里关于人机协作的一篇。同一个柱子底下,我写过[工具长成器官之后判断权留在谁手上](/zh-cn/articles/automation-bites-back),也写过[一个人和四个 AI 窗口的治理实践](/zh-cn/articles/governance-harness-engineering)。这篇补的是第三块:当 agent 开始自己上工,你需要一套独立于它的方式,知道它今天到底有没有在做事。
## 明天早上它们还是会醒来
我那 23 个 job 明天早上还是会照时间醒来,跑完,打一次心跳,然后睡回去。它们大部分的日子什么都不会发现,这正是它们该有的样子。
我留意的是另一件事。8 月 9 日那天,如果不是我刚好去翻了一下,那行「非分歧」可能到今天还会留在那里。
每天准时。每天全绿。
也每天回答一个它从来没有完成验证的问题。