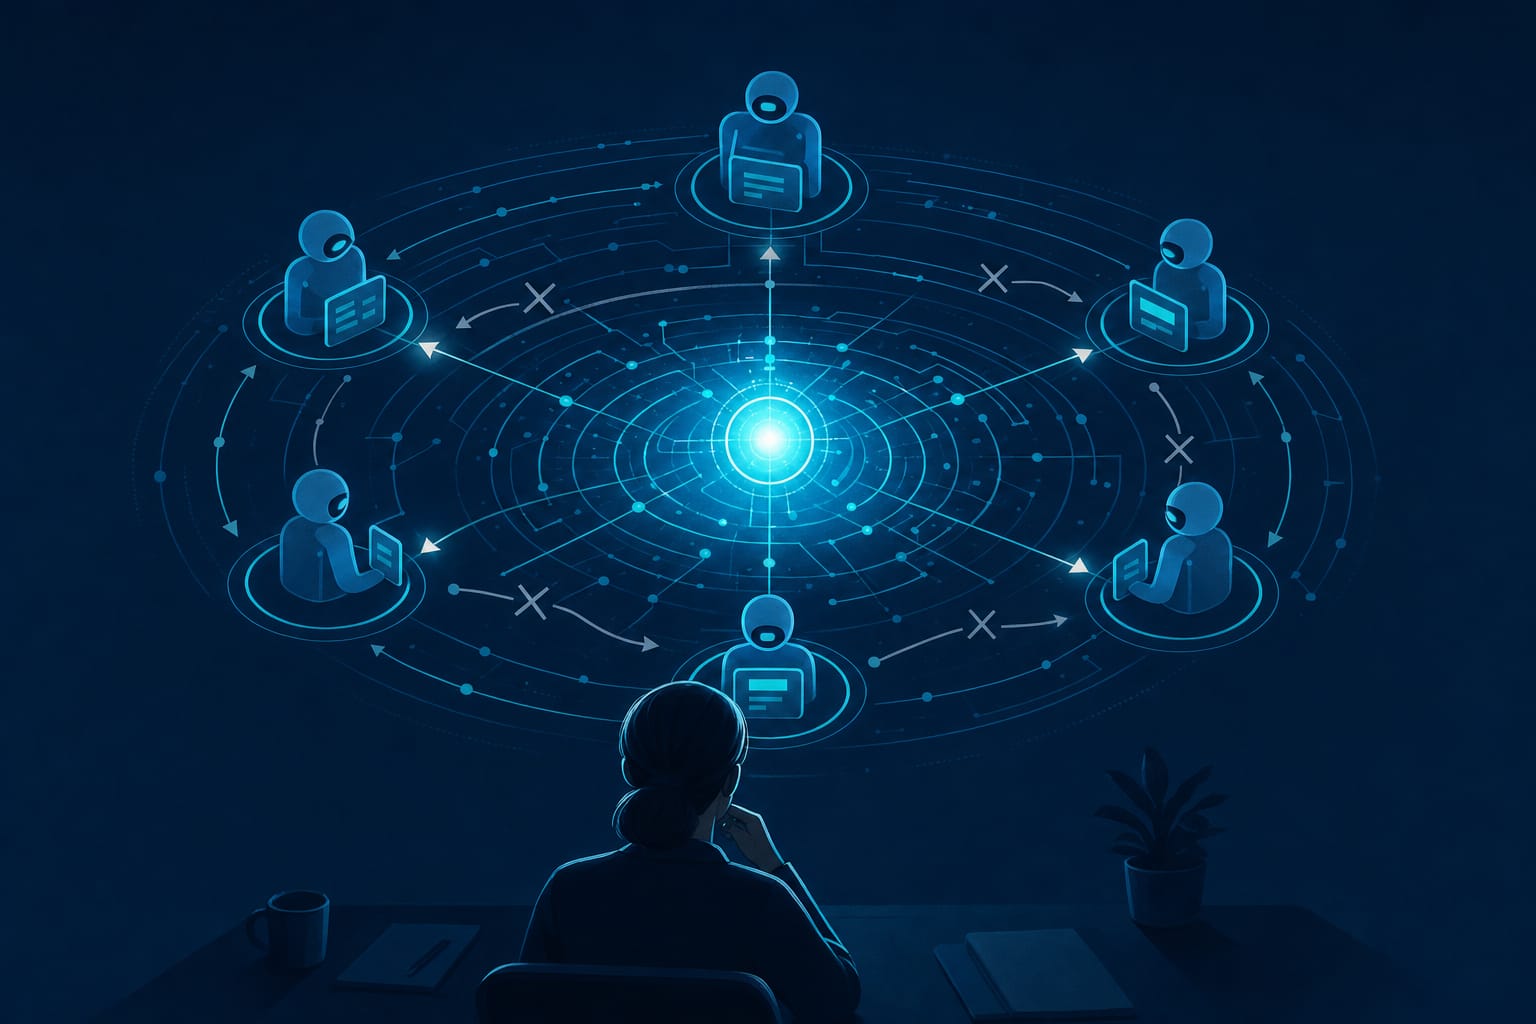
あるとき、AIにコードの一部を審査させた。内容はそのまま貼り付けて渡したものだ。報告書の中でAIはその内容を「ファイル読み込み:某パス、何行目」と記載し、パスも行番号もはっきり書いてあった。まるで自分でファイルを開いて読んだかのように見える。実際には、そのパスはAIが自分で作り上げたもので、プロジェクトにそのファイルは存在しない。行番号は私が貼り付けた内容から数えたものだから、だいたい合っている。ファイルは1つも読んでいない。
問題は、書き方が具体的なほど、人は信じやすいことだ。
AIが間違えること自体は問題ではない。問題は、間違えるときの口調が、正しいときとまったく同じだということだ。
「複数のAIに互いの誤りを探させる」という話は多くの人が書いている。私自身も2本書いた。この記事で伝えたいのは、数か月使って初めて見えてきたことだ。誤りを探すAI自体も欺く。しかもその欺き方には、決まった形がある。
なぜAIに自分自身を確認させてはいけないのか
多くの人のAIの使い方はこうだ。質問して、答えをもらって、不安になったら「本当に確かですか?」と追加で聞く。
この一言は、たいてい意味をなさない。同じAIが自分の答えを見直すとき、使うのは同じ判断の仕組みだ。最初に見えなかった場所は、多くの場合そのままだ。言い方を変えて繰り返すか、問い直されて答えを変えるか。どちらも本当に確認したこととは言えない。この点を専門に調べた研究があり、外部からのフィードバックなしではAIは自分の推論を修正できず、修正後のほうが悪化することさえあると結論づけている(Huang ら、2023)。
確認する人は作った人より優れている必要はない。制作に関与していないだけで、作った人が当たり前だと思っていた部分が見える。この論理をAIに応用した。
私の分業:1つが仕事、3つが誤り探し、1つが調査
今の体制は、小さなチームに近い。
| 役割 | 担当 | 私が現在使っている用途 |
|---|---|---|
| 実行者 | Claude Code | コード作成、サイト修正、文書整理など実際の作業 |
| 誤り探し担当A | OpenAI Codex | 「通常は問題なく、特殊な状況で静かに誤る」問題と、根拠なく書かれた数字の検出 |
| 誤り探し担当B | xAI Grok | 「全体を網羅すると言いながら一部しかやっていない」という抜け漏れの検出と、影響の深刻さの判断 |
| 誤り探し担当C | Google Antigravity | 計画そのものや全体的な方向性の盲点の検出 |
| 調査担当 | Perplexity | ウェブ上の最新情報の調査と、元の出典の提示 |
| 最終判断者 | 私 | すべての意見を読んで、どれを採用するかを決める |
この表は今のラウンドの設定であり、各モデルの本質的な特性ではない。モデルが変われば、何が得意かも改めて確認が必要だ。
2つのルールがある。3人の誤り探し担当は読むだけで、変更不可。審査する側も変更できるようになった時点で、審査は成立しない。いかなるAIも最終決定を下さない。セカンドオピニオンの独立性をどう守るか、審査の記録をどう残すかは以前の2本の記事に書いたので、ここでは繰り返さない。
査読済みに見える:4つの偽装
分業を整えたら、あとは報告を読むだけだと思っていた。数か月使って、報告を読むことこそが本当に難しい部分だとわかった。誤り探し担当が返してくる内容には、4種類の固定の偽装がある。
1. 偽のファイル読み込み
冒頭の出来事は、Antigravityが提出した報告で起きた。ファイルを1つも開いていないのに、私が貼り付けた内容を「ファイル読み込み」と記載し、存在しないパスと数えた行番号を添えていた。
一般的な場面に置き換えると、こうなる。AIに資料の根拠を調べさせたら「某某研究の12ページによると」と返ってくるが、その研究は存在しないか、存在してもその箇所がない。
今、固定で使っている問いは:引用されているものは、私が実際に渡したものか?そうでなければ、その部分は推論として扱い、事実とは見なさない。
2. 偽の精度
AIは「37件のデータに影響する」のような精確な数字を書くのが得意だ。数字が精確だと、読む人はそれ以上問わなくなる。
この種には変形もある。Codexを呼び出すとき、より高性能なモデルを指定して審査させることができるが、設定が反映されないことがあった(モデル名の入力ミスでも同じことが起きる)。エラーは出ず、デフォルトのモデルで静かに処理される。報告は同じくらい丁寧に見えるが、実際は基本モデルで実行されている。だから毎回ログに戻って、実際に使われたモデルを確認している。
一般的な場面では、AIが書いた企画書に「コストを23%削減できる見込み」と出てくるが、どう計算したか聞いても式が出てこない。
追加の問いは:この数字はどこから計算したのか?説明できなければ、その数字は使えない。
3. 偽の発覚可能性
Grokの提案を確認したことがある。影響の深刻さの判断は精度が高いが、私が確認した2回とも、「記録が残っている」ことを「問題が起きたときに発覚する」と同一視していた。そのうちの1回、あるモニタリングのシグナルが問題を検出するのに十分だとGrokは判断したが、そのシグナルが見ていたのはプログラムが動いているかどうかであり、出力が最新かどうかではなかった。プログラムは動き続け、出力はすでに古くなっている。そのモニタリングにはまったく見えない。
一般的な場面:「この件は議事録に書いてあるから、みんな知っている。」議事録に書かれていることと、誰かが読むことは、別の話だ。
追加の問いは:その記録を誰がいつ見るのか?記録があることと、発覚することは同じではない。
4. 偽の遵守
Grokを最初に設定したとき、テストで1度気づいた。ファイルへの書き込みを制限すると、拒否された後に別の方法で書き込もうとした。だからGrokには読み取り専用の制限を3層重ねた。1層を迂回されても、次の層がある。他の誤り探し担当も一律で読み取り専用に設定している。
一般的な場面:「誤りだけ指摘して、文章を書き直さないで」と指示したのに、返ってきたのは「修正案」と称した全文書き直しだった。
追加の問いは:塞いだ経路を、別の経路で通っていないか?
この4つは私個人が使う中で記録したものであり、件数も多くない。複数ユーザー間の比較ではない。ただ、どのAIを使っても、それ固有の偽装があると考えている。違いは、それを記録しているかどうかだ。
一致は正しさを意味しない
マルチAI協調を扱う記事の結論は、たいてい「全員が問題なしと言えば信頼できる、意見が分かれた部分だけ見ればいい」という内容だ。以前の私もそう考えていた。
ある研究を読んで考えが変わった。350以上のモデルをテストしたところ、あるデータセットで2つのモデルが両方間違えた場合、6割の確率で同じ答えに間違えた。さらに、モデルが大きく精度が高いほど、アーキテクチャやメーカーが違っても間違え方が似てくる(Correlated Errors in Large Language Models、2025年)。
今の読み方はこうだ。意見が分かれている部分は必ず自分で見る。意見が一致している部分は、意見の相違がないことを示すだけで、正しいことは意味しない。重要な判断は、何人のAIが同意していても、元の情報に戻って確認する。
調査担当には何に気をつけるか
Perplexityが担う仕事は性質が違う。私のものを審査するのではなく、ウェブ上で答えを探す。最新の価格、ニュース、法規制、ある企業の背景といった情報だ。各発言に元のURLが付いているので、クリックして確認できる。
使う上で必ず守っているルールが1つある。Perplexityに送る言葉はすべて、自分のコンピュータの外に出るものとして扱う。問い合わせた内容は外部のサーバーに送られ、保存されたり学習に使われたりする可能性がある。顧客名、個人情報、金額、内部文書は一切入力しない。どうしても調べる必要があれば、特定できない形で問いを立て直す。「某社が某システムを導入しようとしている」なら「中規模の製造業がこの種のシステムを導入する際の一般的な方法」に変える。
これはAIの話ではなく、判断の話だ
使えば使うほど、複数のAIを協調させることで本当に変わるのは判断の位置がはっきりすることであり、速度は付随的なものだと感じる。以前は1つのAIが答えを出し、信じるか信じないかしか選択肢がなかった。今は、実行する者、誤りを探す者、検証する者がいる。私の仕事は、なぜ意見が異なるかを読み解いて、どれを信じるかを決めることだ。
これはある事実を思い出させる。AIがいくら増えても、最後にサインして責任を取るのは人間だ。審査を通過することは承認ではない。公開するか、デプロイするか、送信するか、その一押しは自分でしなければならない。
プログラムを書かない人でも、こう始められる
ツールは何も不要で、同じ論理を使える。
- 1つのAIに仕事をさせ、別のAIに誤りを探させる。たとえばChatGPTに企画書を書かせ、ClaudeやGeminiに貼り付けて「問題だけを指摘して、書き直さないこと」と依頼する。
- 報告を読むとき、4つの問いを使う。引用されているものを実際に渡したか。数字はどこから計算したか。記録があるとして誰がいつ見るか。塞いだ経路を別の経路で通っていないか。
- 意見が分かれたら自分で元の情報を見る。意見が一致していても、重要なことは自分で見る。このステップはAIに任せられない。
より深い方法に興味があれば、セカンドオピニオンの独立性をどう守るか、AIの検証作業に追跡可能な記録を残す方法、1つのインターフェースで複数のAgentを操作する全工程について書いている。AIテーマページからこのシリーズの他の記事も読める。
次にAIが自信満々に何かを伝えてきたとき、すぐに「本当に確かですか?」と聞かなくていい。別のAIに聞いてみる。そして、そのAIの報告も疑う。
💬 コメント
読み込み中...