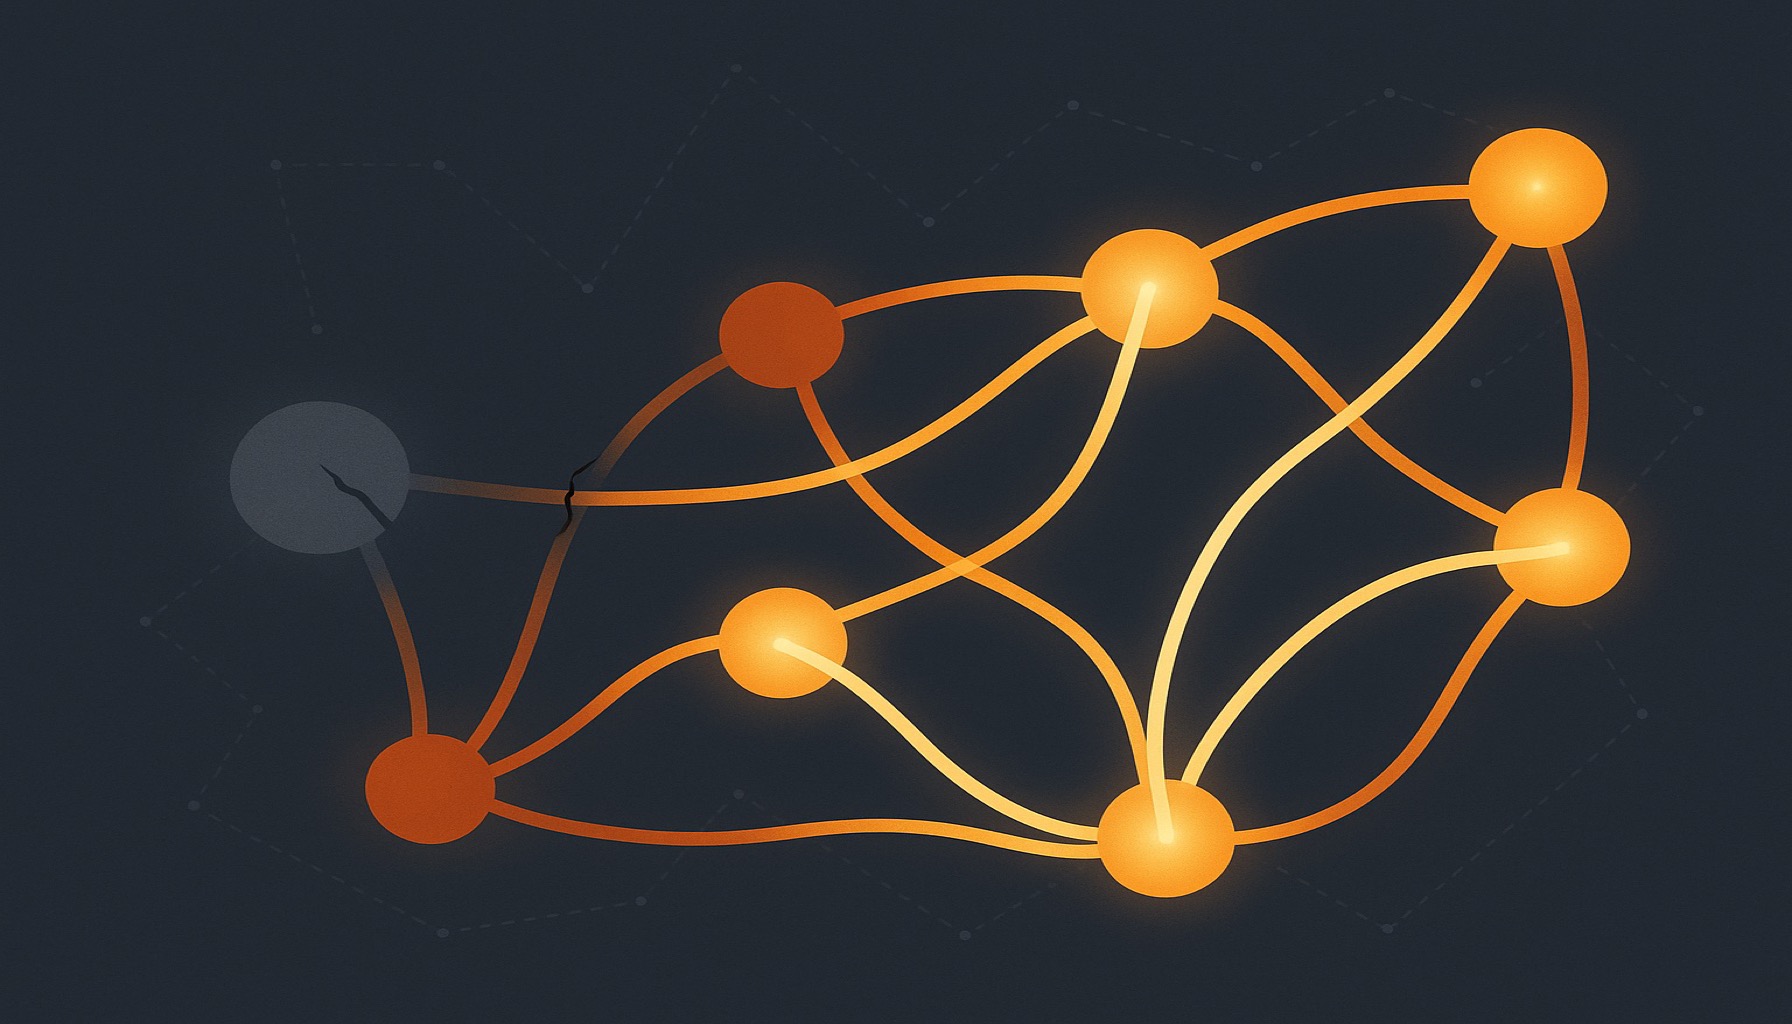
TL;DR: 2026年4月29日のGitHubアカウント停止をきっかけに、執筆、保存、公開の依存関係を見直した。二週間の再構築で重視したのは、明確な主本を一つ残し、ミラーとバックアップを増やし、公開と復元の手順を別に確認することだった。コピーが増えることは役に立つが、それだけで完全な復元能力があるとは言えない。
あの日、paulkuo.twのリポジトリに変更をプッシュしようとしても、失敗が続いた。その後GitHubを開くと、利用規約への違反でアカウントを停止したという画面が出ていた。2026年5月15日までの私の記録では、事前の警告は受けておらず、その時点では具体的な処置理由も、異議申立てへの返答も届いていなかった。これは私個人の経験であって、GitHubのすべての利用者への対応でも、現在のアカウント状態を示すものでもない。
GitHubの公開ポリシーには、異議申立てと復権の手続きがある。ただ、そのポリシーが、このアカウントの処置理由、返答、復旧時期を証明してくれるわけではない。
停止されて初めて、真剣に考えた。原稿は残っているのに、なぜ記事を公開できないのか。
まず、中断した仕事のつながりを描く
元の記録にある仕事の流れは、執筆、GitHubのリポジトリ、GitHub Actions、Cloudflare Pagesへの自動デプロイ、サイトでの公開だった。コードの保存、協働、デプロイの開始が、GitHubのサービスとアカウントに集中していた。
ローカルのファイルが消えたわけではない。でも、遠隔のサービスが制限され、従来の公開手順をいつもどおり完了できなくなった。データが残っていることと、サービスが復旧したことは、別々に確認する問題だ。
約二週間かけて依存を少しずつ分け、元の記録では5月12日を、記事公開の再開を確認した日としている。別のノートには、Gitでの保存と同期をそれより早く再開した記述がある。ただし、それを理由に、その時点で仕事の流れ全体が完全に戻っていたとは言えない。
この事故をきっかけに、一つずつ確認するようになった。どこに一つしか経路がなく、どの代替手段が本当に引き継げるのか。そして、引き継いだあとに、どう結果を確認するのか。
一つの主本に、ミラーとバックアップを組み合わせる
以前の文章では、ローカルのMac、Codeberg、GitLabを「三か所のSSoT」と書いていた。それでは、三か所がそれぞれ有効な版を決められるように見えてしまう。より明確なのは、承認された版を一つの主本とし、他を管理されたコピーとして扱うことだ。
主本は、どの版が有効かを決める。ミラーとバックアップは、保存し、取り戻せる可能性を増やす。
これは別々の責任だ。管理資料の主本が、現実のあらゆる事実の唯一の出所になるわけでもない。オンラインサービスや外部の出来事は、別に照合する必要がある。
当時は、自分で管理できる原稿と管理資料をローカルに置き、Gitホストには遠隔のコピーを保存し、Notionは閲覧に使った。これは私の構成上の選択であって、ローカル機器が生来信頼できるという証拠ではない。Mac、アカウント、鍵、記憶装置にも問題は起きる。取得でき、検証できるバックアップが引き続き必要になる。
再構築した五つの層は、何を扱うのか
創作層では、使えるローカルの原稿を残し、閲覧する場所と正式に変更する入口を分けた。同じルールに、食い違う複数の正本ができることを減らすためだ。
保存層では、CodebergやGitLabなどのGitコピーを増やし、別にCloudflare R2へバックアップオブジェクトを保存した。GitHubだけに依存するリスクは減らせる。ただしR2はオンラインのクラウドオブジェクトストレージであって、オフラインバックアップとは呼べない。
デプロイ層では、GitHub Actionsに依存せずに公開手順を実行できる方向へ変えた。ここに記すのは当時の再構築の方針であり、現在のサイトの確認手順を迂回する操作方法ではない。Gitの同期と本番公開は、引き続き別々に確認する必要がある。
監視層では、契約テスト、差分の監視、復元演習、通知を計画した。テスト名やスケジュールが存在しても、毎回成功しているとは限らず、通知が必ず届くとも限らない。以前の文章にあった正確なエンドポイント数、毎日の完全な検証、SMSの到達保証は今回確認し直しておらず、現在の監視能力の証拠には使わない。
協働層では、Chat、Cowork、Codeの仕事を分け、引き継ぎと未処理事項の記録でつないだ。役割名は当時の分担にすぎない。本当に残す必要があるのは、変更範囲、判断の根拠、未完了事項、次を決められる人だ。
この五層にも共通の依存はある。例えば、PagesとR2はどちらもCloudflareに属する。供給元やコピーを増やしても、特定の故障リスクに対する代替経路になるだけで、共通原因による故障をすべてなくしたとは言えない。
バックアップができたあと、どこまで確かめるか
バックアップのアップロードに成功しても、鍵がない、内容が足りない、環境が欠けているといった理由で使えない場合がある。アップロード、取得、復号、展開、Git clone、実行環境の再構築、本番サービスの復旧は、別々に確認する必要がある。
アップロード成功で分かるのは、バックアップが届いたかどうかだ。完全な復元は、別に確認しなければならない。
R2のオブジェクトライフサイクルでは、保持や削除を設定できる。bucket locksは、ルールを有効にすると上書きや削除を制限できる。製品にその機能があることは、私のバックアップに該当する設定があることを意味しない。オフラインコピーの証拠にもならない。
今なら演習の結果は、範囲を明確にして書きたい。どのバックアップを、どの環境で使い、どこまで確認し、何が未確認か。ファイル数の一致や展開の成功を、「別の機器でもサイトを完全に復旧できる」と広げてはいけない。本稿では復元演習を再実行していない。
ツールは助けになる。引き継ぎは照合できる形で残す
再構築では、考えること、整理すること、実行することを、異なるAIセッションに分担させた。多くのエンジニアリング作業を助けてくれた一方、版、権限、報告が一致しない問題も生まれた。
引き継ぎには実際の版と確認結果を残し、「完了」だけを残してはいけない。
すべての日常的な結果を、人が一件ずつやり直す必要があるという意味ではない。再現できる確認は自動化し、例外、影響の大きい変更、復元の判断には、担当者と判断を引き上げる条件を定めればよい。すべての手順を人が個別に操作しないことと、責任者がいないことは、別の設計だ。
Skillsを、環境によって異なる働きをするタンパク質にたとえたのは、同じツールでも仕事の流れが違えば、データ、権限、タスク、受け入れ条件を確認する必要があると、自分に思い出させるためだった。これは比喩であって、生物学の仕組みをそのままソフトウェアへ適用できるという証明ではない。他の人にも同じ二週間や同じ分担が必ず必要だとも言えない。
この事故から残った、判断への責任
私がレジリエンスに求めているのは、一部が故障しても、使える代替経路と、照合できる復旧手順があることだ。どの能力を試し、どれがまだ仮定なのかを知る必要がある。どのサービスが消えても影響を受けないという保証ではない。
代替手段は引き継げる必要がある。そして、引き継いだあと、どこまで確認したかも説明できなければならない。
元の記事では、大きな事故や理論を使って複雑なシステムのリスクを説明していた。今回、確認できていない事故の仕組み、正確な対応時間、調査者の立場についての記述は残さない。サイトの中断と原子力災害を同じ程度のリスクとしても扱わない。このサイトについては、依存関係の図と実際の確認だけでも、対応すべき問いを見つけられる。
「判断力経済」は、協働の中で感じたことからの仮説だ。実行が速くなるほど、何をするか、いつ止めるか、どう確認するかに、より注意が必要になるかもしれない。市場の賃金動向を測った結果でも、人が永久にツールより優れているという宣言でもない。
二週間の再構築で最も価値があった変化は、それまで暗黙にしていた依存と判断を書き出し始めたことだった。これから「代替手段がある」と言うなら、何を守り、どう引き継ぎ、どこにはまだ根拠がないのかを答える必要がある。

💬 コメント
読み込み中...