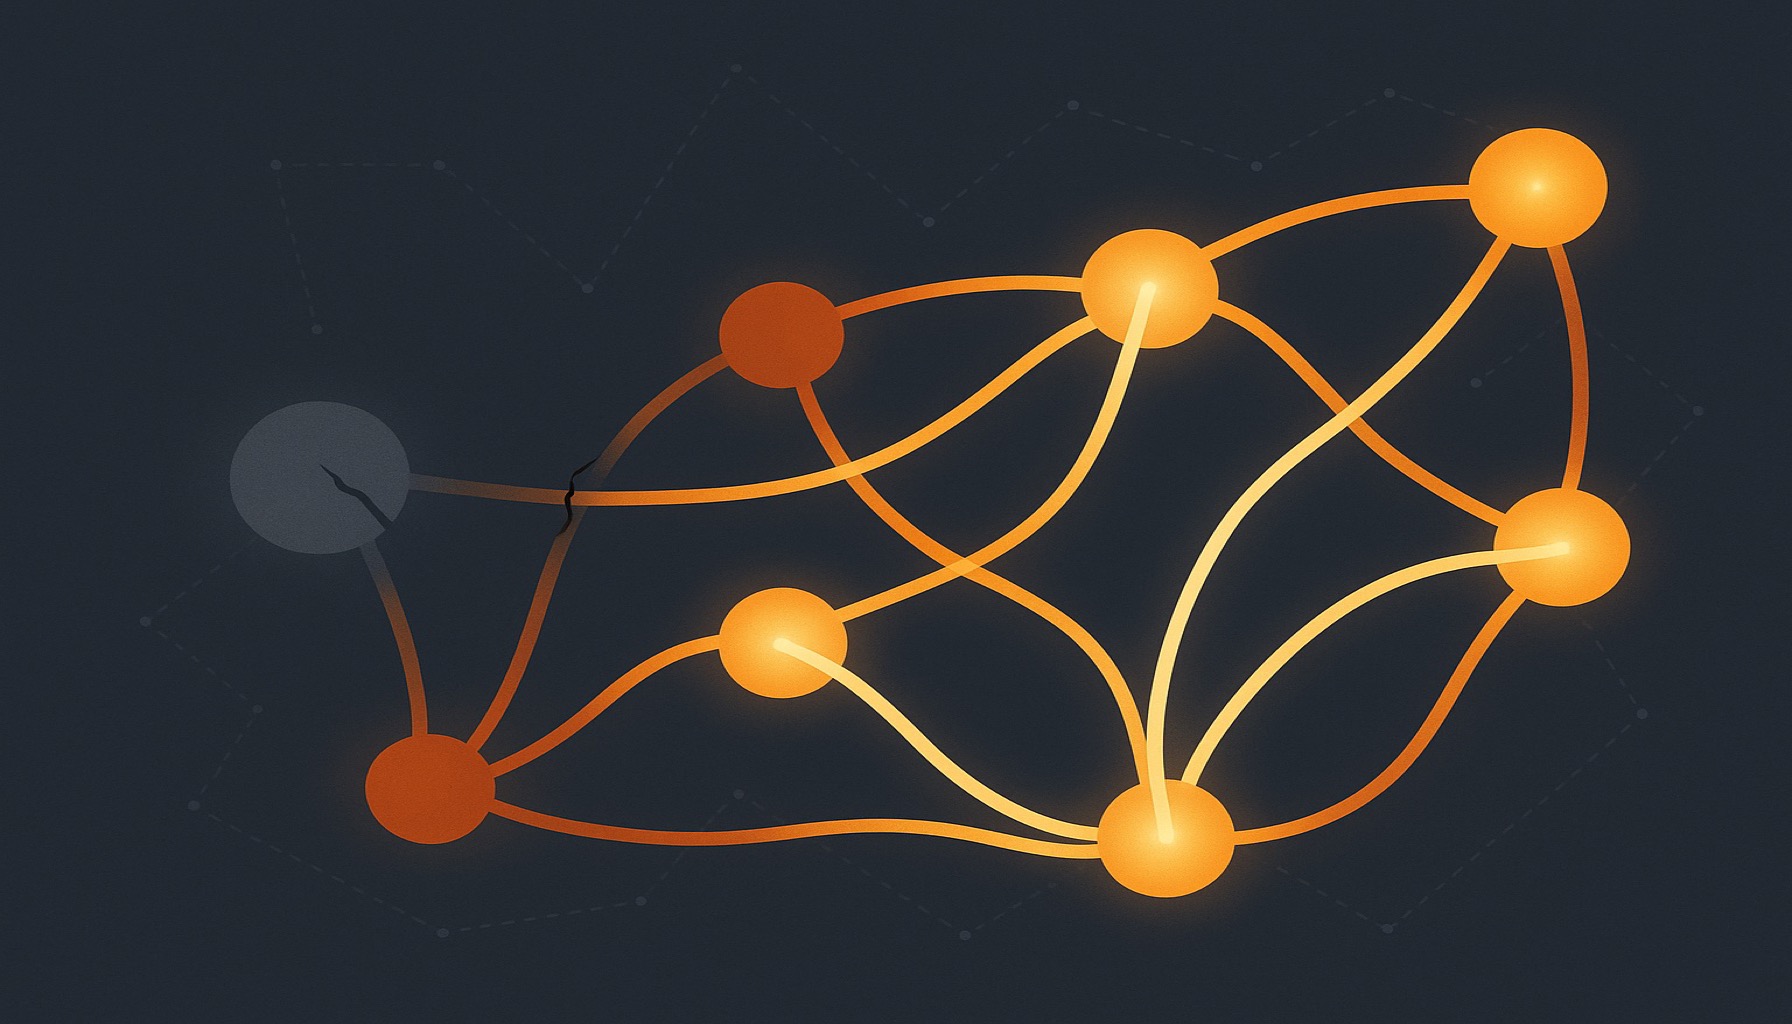
TL;DR: 2026 年 4 月 29 日的 GitHub 帐号停权,让我重新拆解写作、保存与发布的依赖。两周的重建重点,是保留一个明确主本,增加镜像与备份,另验收发布及复原流程。多几份副本有帮助,但不能直接算成完整复原能力。
那天我准备把修改推到 paulkuo.tw 的 repo,却一直失败。后来打开 GitHub,看到帐号因违反服务条款而被停权的画面。依我截至 2026 年 5 月 15 日的纪录,事前没有收到预警,当时也还没收到具体处置理由或申诉回复。这是我的个别经验,不是 GitHub 对所有使用者的处理方式,也不代表帐号现在的状态。
GitHub 的公开政策提供申诉与复权程序,但那份政策不能替我证明这个帐号的处置原因、回信或恢复时间。
停权之后,我才认真问:原稿还在,为什么文章却发不出去?
先把中断的工作链画出来
原纪录中的工作链是:写作、GitHub repo、GitHub Actions、自动部署到 Cloudflare Pages,再到网站发布。程式码保存、协作与部署触发,都集中依赖 GitHub 的服务与帐号。
本地档案没有因此消失,但远端服务受限,使原有发布流程无法照常完成。资料还在与服务恢复,是两个验收问题。
我用大约两周逐步拆开依赖,原纪录把 5 月 12 日列为恢复文章发布的验收点。其他笔记提到较早恢复 Git 保存与同步,不能因此说整条工作流当时已完全恢复。
这次事故让我开始逐段检查:哪里只有一条路、哪个备援真的能接手,以及接手后要如何确认结果。
一个主本,配上镜像与备份
原文把本地 Mac、Codeberg、GitLab 写成「三点 SSoT」,容易让人误以为三处都能各自决定哪一版有效。更清楚的安排是:指定一个核准版本作主本,其余作受控副本。
主本决定哪一版有效,镜像与备份增加保存和取回的机会。
这是不同的责任。治理资料的主本,也不等于所有现实事实的唯一来源;线上服务与外部事件仍要另外核对。
我当时把可掌握的原稿与治理资料留在本地,让 Git 主机保存远端副本,Notion 提供查阅。这是我的架构选择,不是本地设备天然可靠的证明。Mac、帐号、金钥或储存装置也会出问题,仍需要可取回、可验证的备份。
重建的五层,各自处理什么问题
创作层先保留可用的本地原稿,查阅载体与正式修改入口分开,减少同一份规则出现多个互相冲突的正本。
保存层增加 Codeberg、GitLab 等 Git 副本,另外以 Cloudflare R2 保存备份物件。这能降低只依赖 GitHub 的风险,但 R2 是线上的云端物件储存,不能叫作离线备份。
部署层改为让发布流程能在不依赖 GitHub Actions 的情况下执行。这里记录的是当时的重建方向,不提供绕过目前网站检查的操作捷径。Git 同步与正式发布仍要各自验收。
监测层规划契约测试、漂移扫描、复原演练与告警。测试名称或排程存在,不代表每次都成功执行,更不代表通知一定送达。原文的精确端点数、每日完整验证与 SMS 送达保证,本次未重新核对,不拿来证明目前的监测能力。
协同层则安排 Chat、Cowork、Code 的工作,透过交接与待办纪录接续。角色名称只是当时的分工;真正要留下的是修改范围、判定依据、未完成事项与谁能决定下一步。
这五层仍有共同依赖,例如 Pages 和 R2 都属于 Cloudflare。增加供应商与副本,只能针对特定失效风险提供替代路径,不能宣称已消除所有共因失效。
备份存在以后,还要验到哪一步
一份备份可以成功上传,却因为金钥不在、内容不完整或环境缺漏而无法派上用场。上传、取回、解密、解压、Git clone、重建执行环境、恢复正式服务,需要分开验收。
上传成功,只能回答备份有没有送到;完整复原还要另外验收。
R2 的物件生命周期可以设定保留与删除;bucket locks则能在启用规则后限制覆写与删除。产品具备这些功能,不表示我的备份已采用相应设定,也不能把它当成离线副本的证据。
我现在会把演练结果写成有范围的句子:用了哪份备份、在哪个环境、验到哪一步、哪些还没验。档案数相符或解压成功,都不该被扩写成「换一台机器也能完整恢复网站」。本篇没有重新执行复原演练。
工具可以帮忙,交接仍要能被核对
重建时,我把思考、整理与执行分给不同 AI 工作阶段。它们帮我处理了很多工程工作,但也带来版本、权限与回报不一致的问题。
交接要留下实际版本与检查结果,不能只留下「已完成」。
这不要求每一笔例行结果都由人重新做一次。可重现的检查可以自动化,对例外、高影响变更与复原决策,再指定负责人及升级条件。人不在每个步骤逐笔操作,和没有人负责,是不同的安排。
我把 Skills 比作会随环境发挥不同作用的蛋白质,是想提醒自己:同一工具放进不同工作流,需要核对资料、权限、任务与验收条件。这是比喻,不是生物学机制可以直接套到软体上的证明,也不能据此说别人一定需要相同的两周或相同分工。
这次事故留下的判断责任
我对韧性的期待,是一部分出问题时,仍有可使用的替代路径与可核对的复原程序。这需要知道哪些能力已测过、哪些仍是假设,而不是保证任何服务消失都不受影响。
备援要能接手,也要说得清楚接手后验到了哪里。
原文用大型事故与理论说明复杂系统的风险。本次不保留未核实的事故机理、精确反应时间或调查者身分,也不把网站中断和核灾当成相同程度的风险。对这个网站,依赖图与实际验收已能帮我提出需要处理的问题。
至于「判断力经济」,是我从协作感受到的一个推测:执行变快后,选择做什么、何时停下与如何验收,可能更需要注意。它不是市场薪资趋势的测量,也不是人类永远优于工具的宣告。
两周重建最有价值的改变,是我开始把原先默认的依赖与判断写出来。以后再说「有备援」,就需要回答它保住什么、怎么接手,以及哪一部分还没有证据。

💬 留言讨论
加载中...