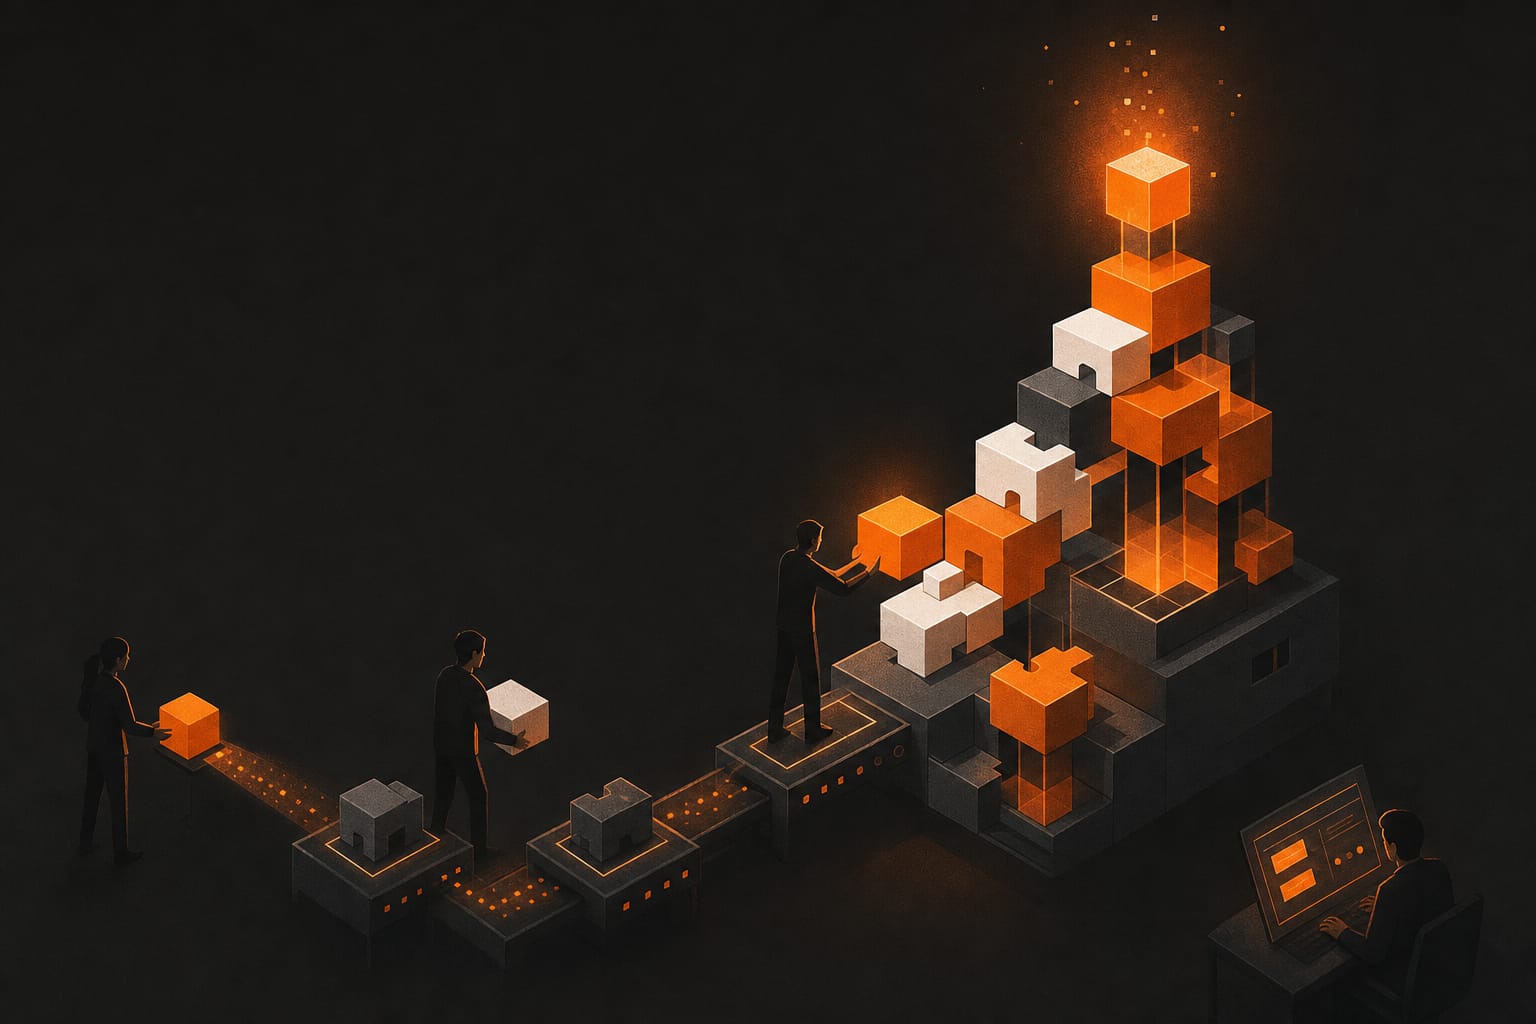
TL;DR:项目讨论散在好几个 LINE 群组,手动导出容易漏、容易忘。我做了一个记事机器人:入群时只发一句自我介绍,之后在群组里只收不回;云端只当中继,本机脚本定时把消息与附件拉回来,写成跟手动导出同格式的文字文件,放进项目文件夹。设计重点有四个:本机是唯一长期副本、写入验证后才通知云端删除、先收消息后分类、用心跳分辨「没人说话」和「机器人坏了」。它做不到的事也要先说:进不了一对一对话、拿不到加入前的历史,而且它存的是全文加附件,不是摘要。另外要老实说:我自己就遇到过文件夹放在云端同步位置、写入持续失败的情形,细节在最后一节。
项目讨论散在 LINE 群组里,要怎么留下来?
我同时待在好几个项目群组。工作的决定、待办、对方丢来的文件,大多是在 LINE 里发生的。
LINE 有手动导出,能把一段对话存成文字文件。但每次都要有人记得执行,还要确认各个群组的记录有没有更新。工作一忙,就可能少导出一个群组,或漏掉一段时间的记录。之后要找那段期间的一句话,还得回到 LINE 里一路往上翻。
我要的结果很单纯:每个群组的对话,自动变成项目文件夹里一份文字文件,格式跟手动导出一样,这样旧文件和新文件可以接在一起。
一句话讲完做法,加一张图
做法一句话:用一个 LINE 官方账号当收消息员,它入群那一句自我介绍之后,在群组里就只收不说;消息与附件先经云端中继暂存,再由我电脑上的脚本定时拉回,写进项目文件夹。
它只有一个例外会开口:我在一对一对话里用「传送聊天记录」分享给它时,它会回一则收据。它不回答问题,也不聊天。
flowchart LR
  A["LINE 群组"] --> B["官方账号 webhook"]
  B -->|"验签、写入、回 200"| C["云端中继(暂存)"]
  C -->|"定时拉取"| D["本机同步脚本"]
  D --> E["项目文件夹 LINE记录/群组名.txt"]
  D -->|"写入并验证后才通知删除"| C
几个名词。webhook 是 LINE 把群组里的每个事件即时推给你指定网址的机制,LINE 官方文档要求在处理事件之前先验证签章,文档说明在此。我的云端这端是一支小函数,加一个暂存用的数据库、放附件的对象存储、记群组名称的缓存。本机这端是一支只用 Python 标准库写的同步脚本,我让它每三小时跑一次。
这个架构里,云端不是文件库。它只是转运站,文件库是我电脑上的文件夹。
想自己做,先从哪里开始?
LINE 端的设置,可以先按这个顺序读官方文档。以下是官方英文说明,操作画面与字段以文档为准。
| 想完成的事 | 官方说明与阅读重点 |
|---|---|
| 建立官方账号、启用收消息功能 | Get started with the Messaging API:先建立 LINE 官方账号,再从 Official Account Manager 启用 Messaging API,之后到 Developers Console 管理通道。 |
| 准备凭证、设置与测试 webhook | Build a bot:说明 channel access token、HTTPS webhook 网址、Verify 与 Use webhook,也有欢迎消息和自动回复的设置。只想记录的用途,要特别看这些回复设置。 |
| 让机器人加入群组 | Group chats and multi-person chats:说明 Allow bot to join group chats 开关,以及群组事件如何送到机器人。 |
| 确认收到的事件来自 LINE | Verify webhook signature:说明用 channel secret 验证签章;验证前不能先改写或重新组合请求内容。 |
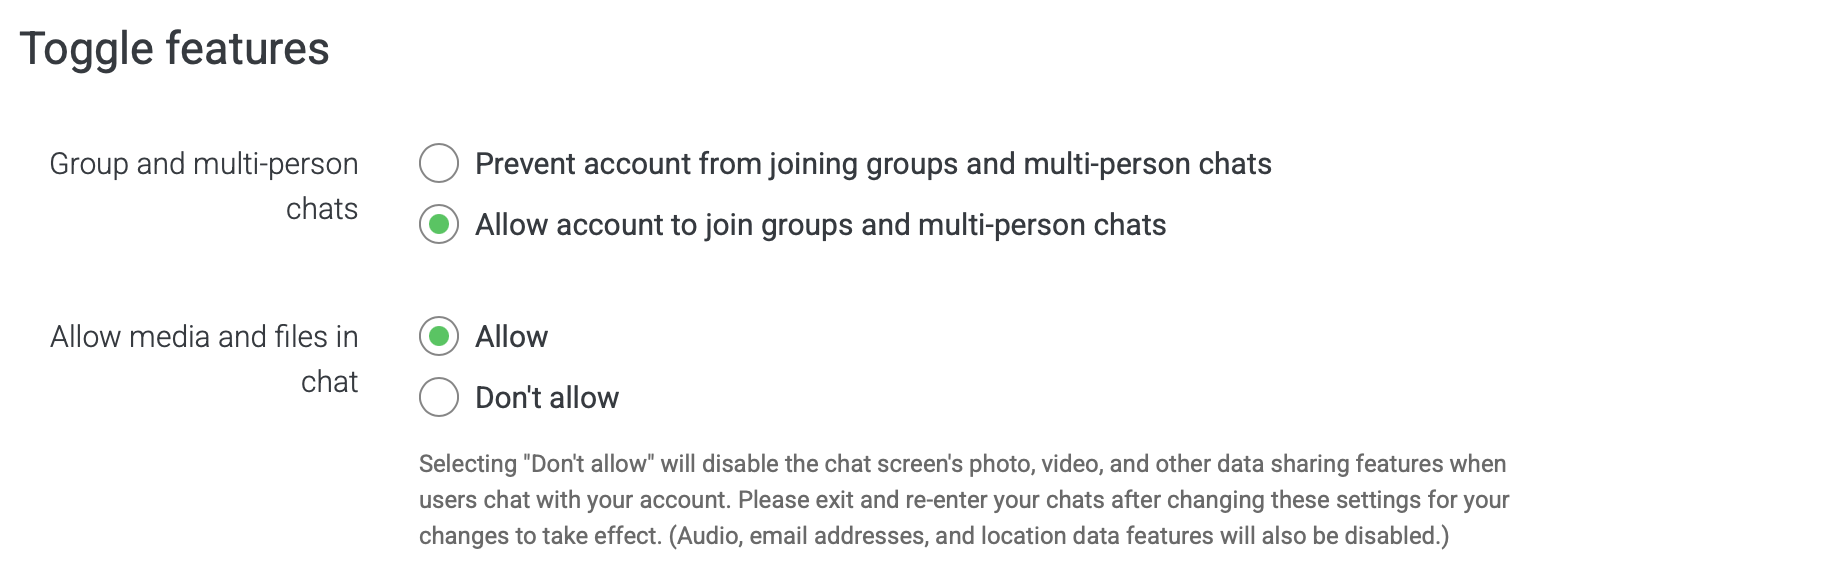
这些文档介绍的是 LINE 平台设置;要做出本文的记事流程,仍需要自己的收消息与同步程序。
云端与本机的安装,下面提供一般建议。我这套的实际完成状态与未解问题,写在文末。
云端先分清楚接收、暂存与同步三个工作。 如果采用 Cloudflare,可以从 Workers 入门读部署方式,以 D1暂存消息、R2暂存附件。建议先用独立项目测试,权限只开到这个项目所需的资源。收 LINE 事件的 webhook 必须让 LINE 连得到,并在处理事件前验签;让本机拉取数据、确认写入的同步端则要另外验证身分。网址难猜不能取代这两种验证。
凭证与附件都要有自己的存放方式。 LINE 的 channel secret、access token 和本机同步凭证分开保管,云端敏感值使用 Workers Secrets,不要直接写进代码或公开配置文件。本机只保留同步所需的凭证,限制能读取它的账号。附件存储保持私有,避免开启公开下载;R2 的公开访问说明列出哪些设置会把内容暴露到网络。消息和附件的保存、清除规则要一起核对,避免一边还在等待同步,另一边已先到期。
本机先手动跑通,再交给排程。 选一个不同步到云端、也不进版本库的普通文件夹当写入位置,确认执行脚本的账号能读写。用系统排程定期执行时,要把同步或确认失败写进可检查的日志。备份另做一份、限制访问并加密,再实际试一次能否还原;让文件夹避开云端同步,只解决写入位置的问题,不会自动产生备份。
测试要走到文件真的落地。 先在测试群组传一则不含个人信息的文字与一个测试附件,确认云端收得到、本机写得进去,内容也对得上。再测重复事件、暂时无法写入、重新执行与确认失败,检查是否会漏、会重复,或太早清掉云端数据。本机写入结果与云端收消息状态分开检查,不能只看 webhook 测试成功或心跳正常。
如果要把安装笔记公开,网址、账号、群组与存储资源名称都用示意值,画面也改用测试环境;不要附上真实凭证、完整配置文件或含对话内容的日志。读者需要的是如何设置与验证,不需要照抄我的实际部署信息。
该怎么向群组成员交代这个机器人?
这一节要先讲原则,再讲我的做法。
机器人加进群组的那一刻,会自动发一句话。我刻意只发一句:
I’m Paul’s note-taking assistant, responsible for summarizing work activities. I do not participate in conversations.
中文大意是:我是 Paul 的记事助理,负责汇整工作动态,不参与对话。
有一次把它加进群组,两分钟后,我补充了一句:
这是帮我做工作记录的AI只会记录不会发文。各位请放心。
一位成员回了「好强大」,接着直接标记机器人,用英文问它能如何协助整理信息、链接想法,以及把洞见变成可执行的成果。他也问我:「他会回答吗」。我回答:「有下了 咒术禁制。所以不会回答。」意思就是:它在群组里负责记录,不会回应提问。
不过,英文的「summarizing」容易让人以为它只留下摘要,「做工作记录」也还没有完整说明保存的内容。机器人实际存下的是对话全文,群组里传送的附件也会一并存下来;汇整成工作报告,是后续把记录交给 AI 整理的另一个步骤。这段入群说明交代了用途与角色,但保存位置、谁能读取、保存多久,以及后续如何交给 AI 整理,都还需要另行向成员说明。
官方账号发出去的消息,没有办法事后改或收回:Messaging API 参考文档列出的消息端点只有送出与统计这几类,没有修改或收回已发出消息的端点;文档里的 unsend 事件是用户收回自己的消息时通知机器人,不是机器人收回自己的消息(API 参考文档)。所以自动说明的文字,要在机器人第一次进群组之前就定好。
LINE 开发者的用户数据政策对这类数据的处理另有规定,政策原文在此。这篇文章不对合规与否下结论,也不替任何人的情况背书。要做的人请自己读完,再决定怎么告知。
四个设计决策与理由
一、云端只当中继,本机是唯一长期副本。 我不想让另一份完整对话长期留在云端。代价是备份变成我自己的工作:文件夹坏了,就没有第二份。这个取舍我在设计时就接受了,所以文件夹要照备份习惯处理。
二、同步顺序固定,失败整批留着。 脚本的顺序是:从云端拉取(只读)、写入文件、验证写入、更新本机记录,最后才通知云端删除。拉取与通知删除是两个分开的请求。任何一步失败,云端那批就不删,下一轮重拉;本机另有一份已写入编号清单,挡掉重复写入。原则是宁可重复,不会遗失。这是我设计出来的行为,不是对结果的保证,所以才需要第一点的备份。
三、先收消息,后分类。 还没登记的群组,消息一律先落进 _未分类 文件夹,之后再登记路由:依群组编号对应项目,或依文件名片段对应项目。这样新群组不必先设置才能收消息,忘了设置也不会漏消息,只是文件暂时躺在未分类。输出文件名由群组名称决定,如果跟手动导出时的文件名不同,同一场对话就会被拆成两个文件。遇到这种情形要合并,不要并存。
四、用心跳分辨「没人说话」和「机器人坏了」。 机器人被移出群组,或凭证失效,从外面看起来都只是「这个群组很安静」。所以脚本每轮都会报告最后一笔事件是几小时前,超过三天没有任何事件就发出警告。另外它会列出近七天的加入与移出事件,以及还没同步的笔数;LINE 不会告诉你是谁把机器人移出去,这一点要有心理准备。心跳有一个范围要讲清楚:它量的是云端有没有收到事件,本机这一段的写文件失败,它看不到,那一段只会留在同步日志里,要有人去读。这个做法和我之前写过的巡检的那一支自己坏掉是同一个问题:没有事件,要能分辨是真的没事,还是看不见。
五个最反直觉的坑
一、名称要让不同语言的伙伴看得懂。 我第一个账号用了纯中文名称。账号加进有外国伙伴的群组后,对方看不懂这是什么账号,我后来换了新账号。现在的建议是名称取英文或中英并列,一看就知道用途。更名规则要另外看账号类型:依 LINE 台湾官方说明,未认证的一般账号可以自行更名,改完七天内不能再改;认证账号若需要更名,则要向 LINE 审核团队提出申请。
二、粘贴密钥时用 echo,会得到难以理解的 401。 echo 会在尾端多带一个换行,送进 HTTP 标头后变成非法字符,症状只是验证失败。我为此排查过很久。要用交互式输入,或 printf %s 把值送进去。
三、403 和 401 是两回事。 没带自定义 User-Agent 的请求,有时会在到达自己的函数之前,就被云端平台层的机器人规则挡成 403。自己的函数只会回 401,所以看到 403,先怀疑平台层,不是密钥。同步脚本里已经处理了。
四、日志放在桌面,后台排程会启动失败。 我踩过:排程的日志文件放在桌面,系统因为权限标记,让排程根本起不来。日志要放在 ~/Library/Logs/ 底下,不要放在桌面或受云端同步的文件夹。
五、一个群组同一时间只能有一个 LINE 官方账号。 这是平台限制,不是我踩到的。官方文档写的是「At any time, only one LINE Official Account can be in a group chat or multi-person chat」(Group chats and multi-person chats)。群组里已经有别家官方账号时,你的机器人是加不进去、还是加入后被移出,会不会有提示,文档那一段没有写,我也没有实测,这一点待确认。邀请之前,先看一眼成员名单。
存下来的记录怎么用:以每周工作报告为例
我在一个非营利组织担任职务,每周要交一份工作报告。进度与待办的主要来源,就是各个 LINE 群组的记录。记事机器人存下来的文件夹,就是这份报告的原料。
流程大致是这样:每周让 AI 读整个 LINE记录 文件夹,扫的是整个文件夹,不是写死几个群组名,所以新增的群组会自动纳入。AI 产出一份草稿,包含 Markdown 版、PDF 版,以及一则准备贴回群组的消息草稿。草稿由我审过才送,这是我给自己定的规矩。
把记录交给 AI 之前,有两条纪律是踩过才补上的。
第一,先检查每份导出文件的更新状态。 取材前先看文件最后更新时间,再看文件里最后一则消息的日期。若记录停在报告区间的前几天,要标出待确认的范围,核对同步日志或 LINE 里的原始对话。群组可能真的没有新消息,也可能是导出或同步落后;还没确认前,不能让 AI 把这段空白写成「没有进度」。
第二,仪表板空白不等于没有进度,以本机文件为准。 有一次,我的草稿只读了线上仪表板,写出「本区间无新增交付」,但本机文件夹当时有大量变动。仪表板只反映有人记得去填的部分,文件反映实际发生的事。
另外一个小坑:如果文件夹放在会自动同步到云端的位置,文件可能处于还没下载的占位状态,读取会失败,错误消息是 Resource deadlock avoided。读之前要先用 brctl download 把文件拉下来。同一个原因也会让机器人写文件失败,我自己的状况见下一节。
它做不到什么?哪些情境不该用?
先讲平台限制,这几条没有绕法:
- 进不了两个真人的一对一对话。 只能由我本人在 LINE 里用「传送聊天记录」分享给机器人。机器人只会下载我本人分享的
.txt;如果分享进来的文件比电脑上现有的文件小,脚本不会覆盖原文件,而是另存一份.incoming.txt让我自己比对。 - 拿不到加入之前的历史。 加入前先手动导出一次当基线。
- 成员没同意提供个人资料时,名字会显示成「未知成员(xxxxxxxx)」。 这是常态,不是故障,也不要去猜是谁。
- LINE 上的文件有保存期限。
再讲设计上的限制:本机是唯一长期副本,没有备份习惯的人,这个架构等于把风险放在自己身上。如果文件夹放在云端同步位置、文件处于占位状态,写入会失败;脚本的行为是不通知云端、下一轮再拉,不是当场补救。
这一条我自己踩到了,10/2 当天才修。 以下先是我修之前查本机同步日志与文件夹的结果,修法与结果写在最后。
- 失败从 8/20 就出现,8/27 起明显变多。 日志里的错误是
Resource deadlock avoided。我用「每轮有几个文件写不进去」来看,因为每天跑的轮数不固定(2 到 12 轮)。8/20 到 8/26,平均每轮约 0.3 到 3 个;8/27 起多半是每轮 4 到 13 个,10/1 是 13 个,10/2 是 12 个。只有 9/13 那一天,跑了 7 轮,一个失败都没有。 - 原因我判断是桌面被同步到云端。 我的项目文件夹放在桌面,桌面有开云端同步。10/2 那一轮写不进去的 12 个文件,全部都是还没下载的占位文件;
LINE记录底下 33 个文字文件里,有 22 个是占位文件。失败的不只是_未分类,项目文件夹底下的文件也有。 - 它是部分失败,不是全停。 9/28 跑了 8 轮,其中 5 轮有写进记录。但 10/2 上午 11:20 那一轮,从云端拉到 687 则,12 个文件都写入失败,本次写入 0 则。10/1 到 10/2 我看的几轮,每轮也都拉到六百多则,全部标成「新的」,符合同一批没有被确认、一直留在云端的行为。
- 心跳全程显示正常。 我查了 8/19 到 10/2 的全部日志,258 行心跳,没有任何一行不是「正常」。心跳只量云端有没有收到事件,云端一直在收,它就一直正常;本机写不进去,只会出现在同步日志里。
消息有没有遗失,我的判断分两层。照 Worker 代码,云端暂存的数据只有在本机确认写入后才会删,我没看到到期清除的代码;所以设计上,那批消息应该还在云端。但云端附件存储库有没有另外设置的保存期限,我没有查,也还没逐笔核对过。所以我只能说设计是这样,不能说没有遗失。
修法是把两类记录文件夹(群组文字记录、群组附件)搬出有云端同步的桌面,改放不同步、也不进版本库的普通文件夹,脚本本身只改了一个路径设置。搬之前我先把 572 个文件逐一复制,核对每个文件的大小相符,才切换。切换后我当场跑一轮:从云端拉到 722 则,全部写入,其中 89 个附件也存下来,写入失败 0 个,云端确认并清空 722 笔;紧接着再跑一轮,没有再拉到任何东西。这只证明积压的那一批已经落到本机,不等于「没有遗失」:修之前那几周,有没有消息在保存期限到期前就没了,我没有逐笔核对。
截至 2026 年 10 月 3 日,还有两件事没解决:新位置的记录还没有另行安排备份;心跳仍只看云端有没有收到事件,本机写入失败依然要查同步日志。10/3 凌晨 02:46、05:51 的两轮排程都没有出现同步错误,但两轮都没有新消息,因此这只能证明排程有跑,还不能据此判定有新数据时会持续正常写入。云端附件存储库的生命周期规则也仍未查证,所以我还不能把这次修复写成「没有遗失」。
最后讲不适合的情境。以下是我的判断,不是测试结论:如果你没办法向群组成员讲清楚存什么、存在哪、谁看得到,这个机器人就不该进那个群组。如果你需要的是多人共用、即时全文检索的团队知识库,一份放在个人电脑上的文字文件不是对的形状。
代码不公开,想要的人可以找我。更多一人公司的实作记录,在创业与实作主题页。
💬 留言讨论
加载中...