10 月 1 日,Google 发表了新模型 Gemini 4 Argon。Demis Hassabis 在 X 上贴出一张比较表,Argon 那一栏大半涂成蓝色,代表那些项目领先。如果你那天刚好滑到这则消息,心里可能闪过一个念头:我每天用 AI 写信、做简报,要不要换?
我自己维护一个追踪 AI 模型的页面,叫 /ai/models,用来比较几个前沿模型的实力。那天上午的例行更新其实漏掉了 Argon,是我后来问起 Gemini 的最新进展才发现,同一天上午补进页面。补进去的是说明文字,比较卡片上没有它。
一个号称多项第一的新模型,为什么在我的页面上只拿到几行字?这个决定背后,其实是三个任何人都用得上的问题。
看到新 AI 模型发表,上班族该先问哪三件事?
我现在用得到吗?这个分数是谁量的?它换了、它错了,我看得出来吗?
这三题听起来平常,但新模型发表时的消息,很少替你回答。下面用 Argon 一题一题走。
第一问:Gemini 4 Argon 现在用得到吗?
用不到。依 Google 的博客,Argon 目前只开放给 Fairwind 计划的成员,也就是政府单位和受信任的资安防御方,他们拿到的是不带资安护栏的版本。之后开给其他人的,会不会是同一个版本,我手上的资料没有写。下一批是付费 API 客户和 Google AI Ultra 订阅者,时程没写。一般人什么时候轮得到,文章没有提。
所以 10 月 1 日那张表再漂亮,对大部分上班族来说都还只是预告。发表和能用,在 Argon 身上已经是两个日期。
第二问:新模型的分数是谁量的?
先看 Hassabis 贴出的那张表。
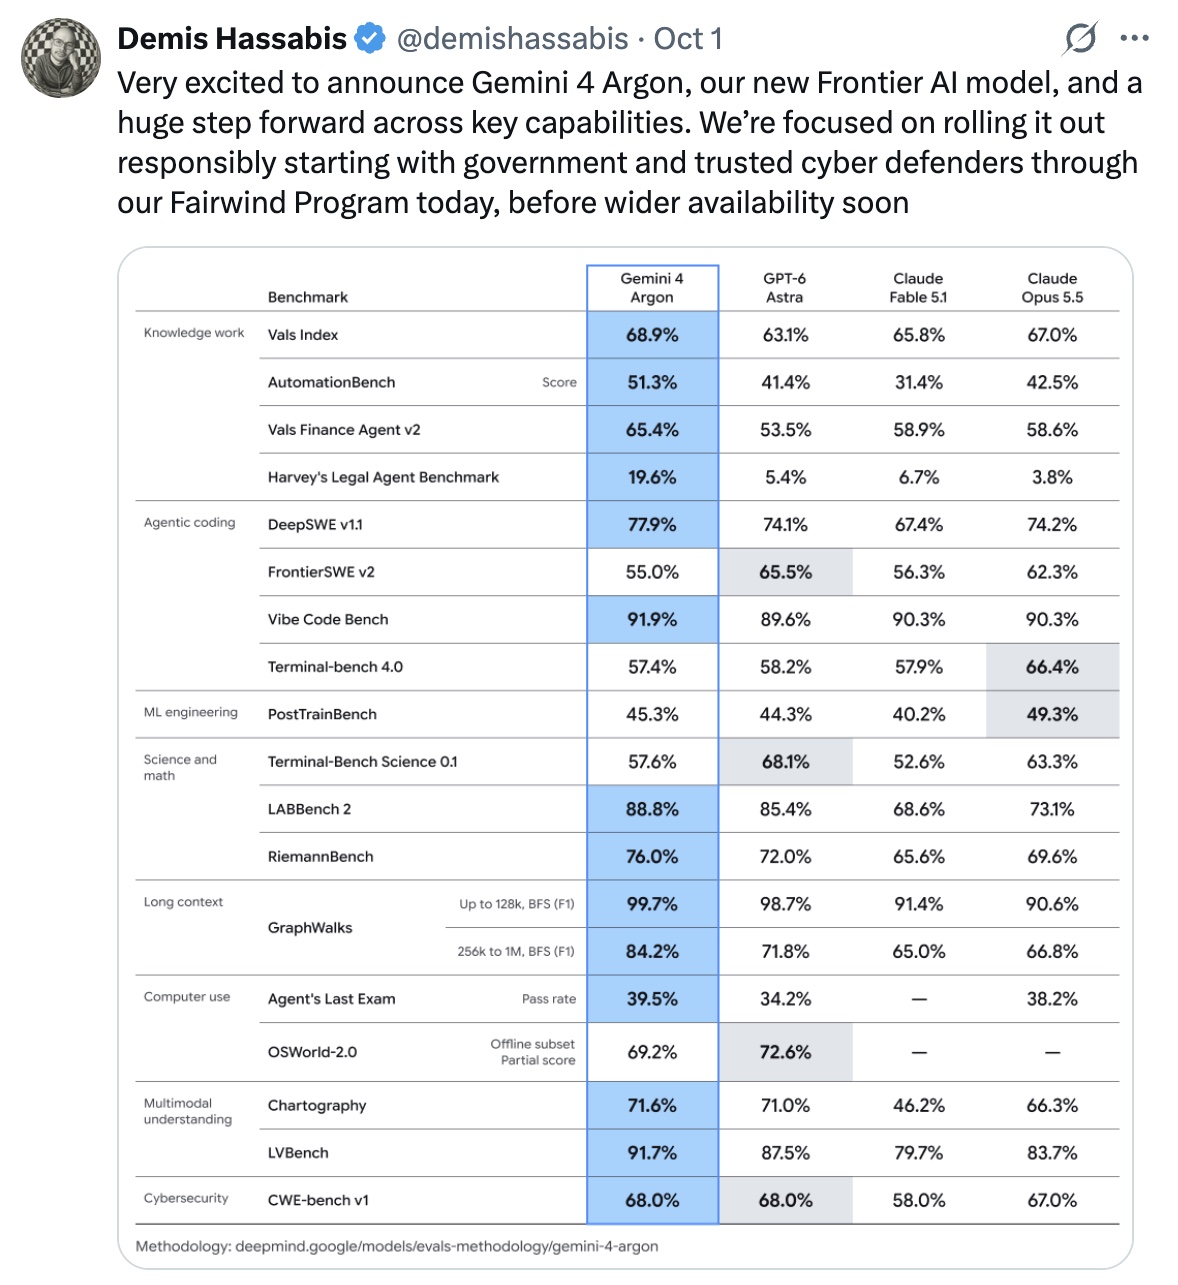 Demis Hassabis 的 X 贴文截图(2026-10-01)。表格由 Google 提供。
这张表值得多看两眼。蓝底是 Argon 领先,灰底是别家领先。19 列分数里,有 5 列是别家赢,资安那列平手。就算是厂商自己挑项目、自己排版的表,Argon 也不是全赢。
再挑一列来对。表上写 Argon 在 DeepSWE(一套测 AI 写代码能力的测验)拿 77.9%,比第二名高出快 4 个百分点。DeepSWE 自己有公开的成绩资料档,我拿表上这一列四个数字去比,只有 GPT-6 Astra 的 74.1% 查得到。Argon 不在里面,表上的 Fable 5.1 和 Opus 5.5 也不在,资料档里只有它们的上一代。资料档是 9 月 22 日产生的,早于发表,查不到并不奇怪,但也代表这一列的四个数字,有三个目前没有公开资料可以对照。
同一个模型交给第三方 Artificial Analysis(AA)用自己的方法量,出来的是另一张图。AA 的综合指数(这是指数,不是答对率),Argon 拿 53,跟 Fable 5.1、GPT-6 Astra 同分;Opus 5.5 是 58。Argon 真正突出的是幻觉率,也就是会不会一本正经地编出答案。它约 15%,明显低于另外三个前沿模型。
对写信、做简报的人,这一点比任何编程分数都要紧。报告里错一个数字,信里多一个不存在的出处,丢脸的是你,不是 AI。挑工具时,先想清楚你最怕哪一种错,再去找量那种错的数字。
第三问:AI 换了模型、出了错,你看得出来吗?
9 月 28 日,我在自己写代码用的 AI 工具里测了一件小事:平常叫的那个模型名字,现在实际用的是哪一版。结果已经换成新版的 Opus 5.5。名字没变,里面换了,事前没有任何通知。
这件事对我不是小事。这半年模型进步得太快,我的工作流程几乎都跟着模型的演化绑在一起:用哪个模型,会影响工作流程怎么设置,也影响提示词怎么写。模型换了,流程和提示词可能就得重新调整。所以「现在跑的到底是哪一个」,我必须知道。
上班族其实也一样。你习惯的问法,做简报大纲的那套提示词,都是在某个模型上摸出来的。工具背后的模型一换,结果可能变好,也可能让原本顺手的用法出现你没预期的变化。如果你用的工具有显示模型名称,哪天觉得回答方式怪怪的,先看一眼是不是换了,再怀疑自己的提示词。
错了怎么看,比换了怎么看更实际。不管模型新旧、排名高低,信和简报里查得到的东西,像数字和出处,送出去之前自己查一次。幻觉率低的模型也还是会编,只是比较少。
Argon 发表后,我也回头查了自己有没有要跟着换。我平常会请 Google 的 AI 工具帮我做第二轮检查,查下来,能选的模型清单里根本没有 Argon,想换也换不到。就算哪天它出现了,我也会先在自己的工作上试过再说。幻觉率低听起来很吸引人,但那量的是会不会乱编,跟能不能帮我抓出问题是两件事。
我的模型页怎么决定收不收新模型?
我的模型页有几条收录规则,说穿了就是把上面三题写成固定流程。
第一条是能不能用。一般人用不到的模型,分数再好也不放进卡片,只在说明里记下读数。Argon 就卡在这一关,跟先前同样只开放给少数单位的模型一样处理。反过来,新模型只要开放了、有第三方量过,就算目前只有 AA 一份数字,也可以先放进相关的卡片。
第二条是分数从哪里来。每个分数都标明是厂商自己跑的,还是第三方用同一套方法量的,两种不放进同一张表比高低。Google 自报的 DeepSWE 77.9% 就属于前者,DeepSWE 的公开资料档里还没有它,所以不采计。DeepSWE 的分数一律从公开资料档取,不用网络上的转述。这条是踩过坑才加的:以前用转述,曾经把一个已经有成绩的模型,错列成「尚未送测」。
第三条是主动找缺口:每次更新都要搜索这段时间有没有还没上榜的新模型。Argon 这次还是被漏掉,原因是那天上午只照第三方榜的新进者去找,没有对几家大厂各查一次最近有没有发表。
发表会给的分数,能直接拿来比吗?
发表会给的是宣称。能拿来比较的,只有同一把尺量过的数字。
这不代表 Google 的 77.9% 是假的,只是在它出现在公开资料之前,我没办法拿它跟别人的分数放在同一列。上面三个问题,其实都在帮你分辨宣称和量过的差别:宣布是厂商在发表会上做的事;能不能用,要看你的账号在不在开放名单里;量过了,得等第三方用同一套方法跑完。三件事常常落在不同的日子,有时隔好几周。
企业选 AI 也是同一个道理,AI 剧场落幕那篇写过:要的是经得起验证的价值。换到每天用 AI 的上班族身上,差别只在你验证的是自己的信和简报。会问这三个问题的人,跟只看发表会的人,能力落差会慢慢拉开。
页面上的那几行字
Argon 现在在我的页面上,只有几行字。等它真的开放给一般人用,再看它该进哪张卡片。
想看更多 AI 治理的讨论:AI 与人类秩序 → AI 治理
💬 留言讨论
加载中...