先講結論:錄音卡整天開著錄,整理分兩次。重要的會一結束,當場從 App 匯出 md 檔整理;其他的晚上回家透過 API 同步,隔天早上讓 AI 把「昨天」整理成重點和待追事項。哪一場要細看,再按時段把逐字稿叫出來。網路上常見的用法,像 MARK 標記和小步日記,也都放得進這條線。不想碰技術的朋友,只用 App 也能做到一大半;想接 AI 的,得到大腦開放平台有三條路可以走。
最近常有朋友問我錄音卡怎麼用。問的人多了,我想說乾脆寫成一篇,直接把連結分享給朋友。
我從 2026 年 2 月底開始用得到的 GetSeed 錄音卡,到 11 月初累積了約八百段錄音。前八個月是有事才按:開會、談事、聽線上直播時錄。11 月初起,我改成整天開著錄,整理分兩次:重要的會當場整理,其他的晚上同步、隔天早上收摘要。
整天錄的好處有兩個:不用再判斷「這場要不要錄」;回頭整理時,哪一場都能按時段叫出來。
錄音卡是什麼?GetSeed 和得到大腦
GetSeed 是得到(北京思維造物)推出的 AI 錄音卡,負責把聲音錄下來;轉逐字稿、做摘要交給手機上的 App。這個 App 原本叫「Get筆記」,現在改名「得到大腦」,App Store 上的名字是「得到大脑(原Get笔记)」(App Store)。
我 2 月 26 日拿到錄音卡時,還一度以為是林明樟 MJ 老師送來的禮物:設計感、細膩感都有,配件包也很豐富(臉書貼文)。
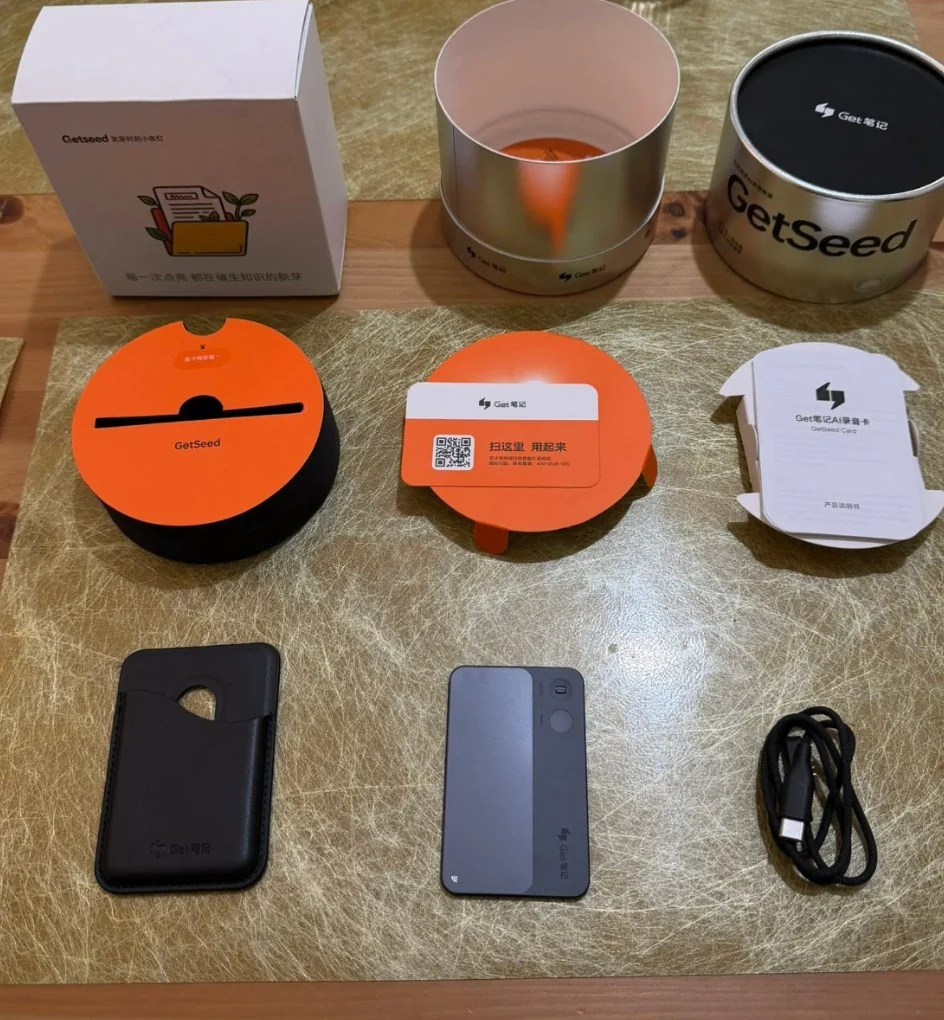
我開箱時拍的,盒子裡的東西全攤開:下排中間那張就是錄音卡,左邊是卡套,右邊是充電線(2026 年 2 月)。
錄音卡是一張卡片,厚 3.1 毫米,可以吸在手機背面。跟整天錄有關的規格(官方說明、產品整理):
- 實體按鍵撥一下就開錄,不用解鎖手機;手機來電也不會中斷錄音。
- 最長連續錄 35 小時、待機 60 天,內建 64GB,沒網路也能先錄、之後再同步。
- 三支麥克風,標示 8 公尺內可收音;轉逐字稿時會區分不同的說話人。
- 轉逐字稿的額度:付費會員同步錄音卡後不限時數,免費版每月 600 分鐘(少數派,2026 年 3 月)。現在付費方案叫「得到大腦會員」,額度以 App 內為準。
錄音要同步到 App,才會轉成逐字稿和摘要。所以重要的會一結束,我會先同步,把那一場匯出成 md 檔;其他的留到晚上一起同步。
中間那一步會把錄音上傳到得到大腦的雲端,這件事後面「錄音之前要知道的事」會再談。
網路上的用法,各自落在哪一步?
中文圈的評測和心得看下來,大家的用法可以排成一條線:錄 → 標記 → 會後整理 → 每天回顧 → 要用再撈,最後接上 AI。我的做法也走這條線,只是把整理拆成兩次。表裡第二欄是網路上常見的做法,第三欄是它放進「整天錄,整理分兩次」之後的樣子。
| 步驟 | 網路上常見的做法 | 放進這套流程 |
|---|---|---|
| 錄 | 開會、上課、聽講座時錄;電話和多種線上會議的聲音也錄得到(產品整理) | 整天開著錄,不再判斷哪場要錄 |
| 標記 | 聽到關鍵處短按 MARK,會後 AI 針對標記整理重點;長按 MARK 直接講,放開就存成一則靈感筆記(人人都是產品經理) | 標記跟著筆記同步,開放 API 也讀得到;回頭整理時,可以先找標記的地方 |
| 會後整理 | 看 App 的摘要;錄音卡、會議、課堂的錄音能自動產生資訊圖(App Store 更新說明) | 重要的會一結束就匯出 md 檔當場整理,這是第一次整理 |
| 每天回顧 | 晚上讓 App 的 AI 助理「小步」把當天整理成一篇日記(App Store 更新說明;早期叫「AI 柳比歇夫」,見少數派) | 晚上透過 API 同步,隔天早上收 AI 摘要,這是第二次整理 |
| 要用再撈 | 直接問 App 的 AI,它會根據筆記回答(App Store);複製逐字稿時選「原文版」再貼給 AI(人人都是產品經理);讓 AI 幫想法「發芽」,整理成可以直接發的貼文(App 介紹) | 按時段把逐字稿撈出來,再整理成會議紀錄 |
| 接上 AI | 裝官方 Skill,在 Claude Code 這類工具裡一句話查「上次那場會講了什麼」(少數派) | 開放平台有三條路可以接,我用 API,後面細講 |
評測裡也有人潑冷水。有篇分析提到,兩小時的會議錄音,人會怕到不想重聽,最後成了沒人碰的死資料(人人都是產品經理)。整理分兩次之後,重要的會當場就整理完,其他的每天早上有一份摘要,用不著整段重聽。
我的用法:整天錄,整理分兩次
錄音卡整天開著,整理分兩次:重要的會當場整理,其他的晚上回家再透過 API 一起同步。
上面那條是第一次整理,重要的會當場做完;下面那條是第二次整理,一整天的錄音晚上同步,隔天早上看摘要。
整天錄。 白天錄音卡一直開著,開會、洽談、聚餐,還有電腦上播的公開直播,全都在裡面。我不再判斷哪一場值得錄,反正隔天早上會有摘要。
會後先整理。 重要的會一結束,我會先把錄音卡同步到 App,再用手機或電腦上的得到大腦 App,把那一場匯出成 Markdown(md)檔,單獨存到電腦整理。這是第一次整理,那一場不用等到晚上。匯出的路徑是:打開那一場的筆記,從右上角的選單點「导出」,再選「导出 Markdown」(App 介面是簡體字);會員還能打開「去水印导出」,匯出的檔案就不會有得到大腦的 logo。
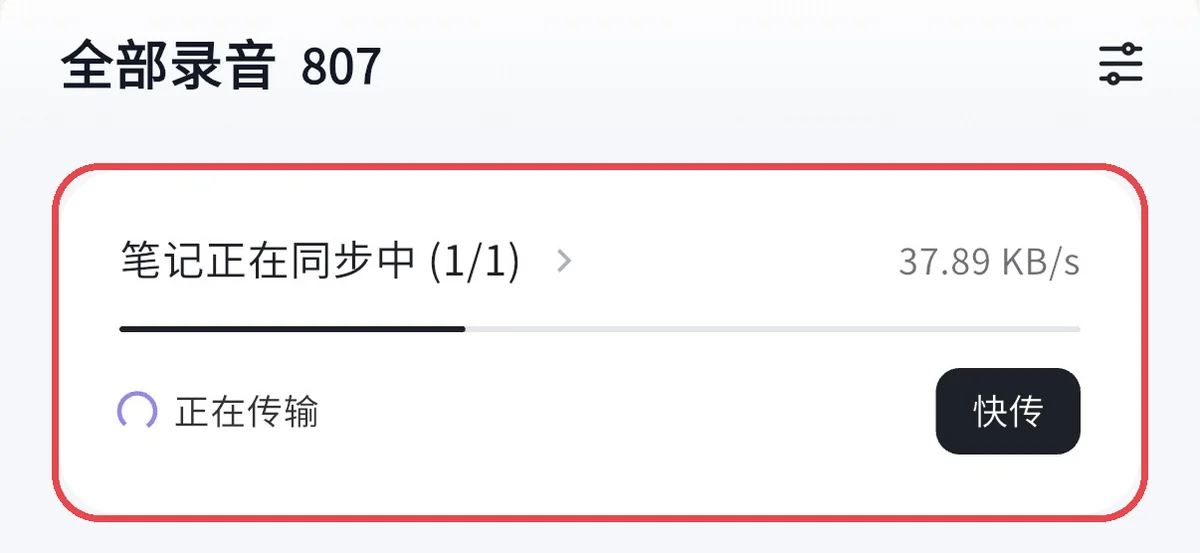
錄音卡同步到 App 時,「全部录音」上方會出現同步進度(截圖節錄)。
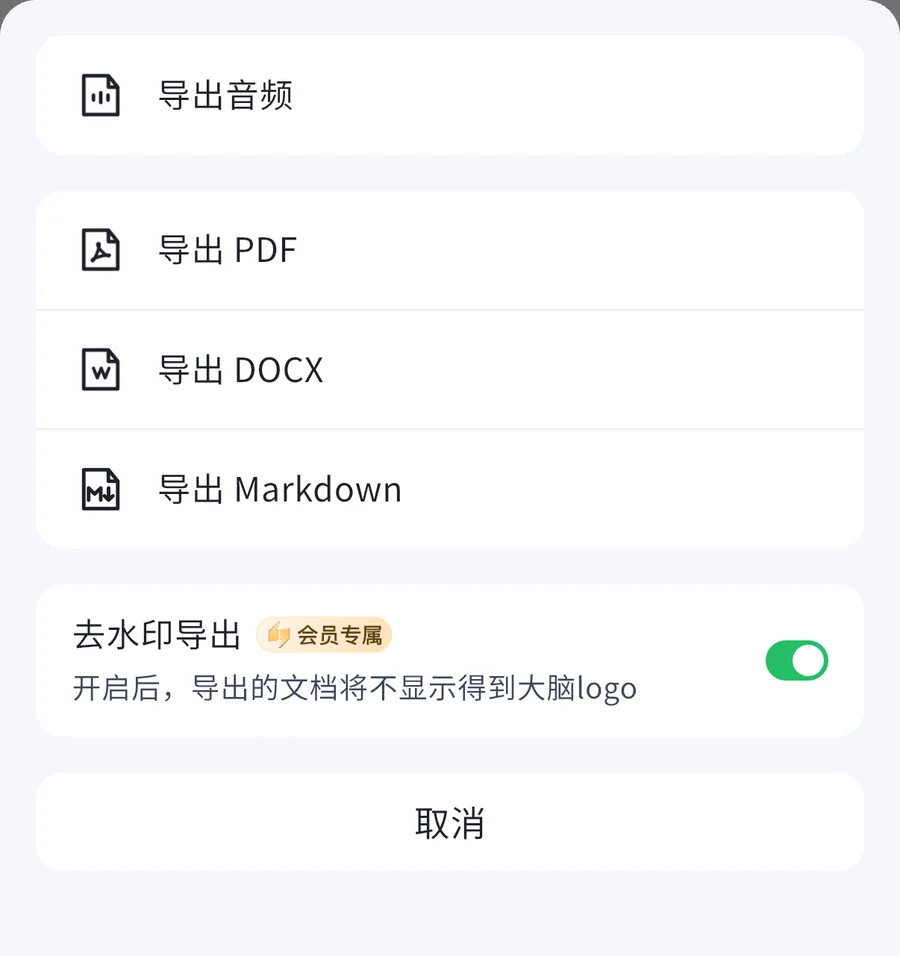
得到大腦 App 的匯出選單(截圖節錄)。
晚上再同步。 晚上回家,把錄音卡同步到 App,再透過得到大腦的 API,把一整天的筆記拉回電腦,這是第二次整理。我的電腦晚上 8 點會自動抓一次錄音卡的筆記,想早一點也可以手動叫它同步。API 怎麼接,後面「得到大腦開放平台的三條路」那一節有細節。
早上看。 隔天早上 6 點 53 分,AI 先補一次同步,再把「昨天」整理成一份摘要:一共幾段、各段幾點到幾點、主題和對象,每段 3 到 6 個重點,最後列出要追的事。手機會跳一行通知,全文留在排程的對話視窗裡,資料夾也另存一份。
要用再撈。 摘要裡哪一場要正式紀錄,我就跟 AI 說「把昨天下午三點那場整理成會議紀錄」,它會按時段把那段逐字稿切出來,再整理成紀錄。
這套節奏是 11 月初才定下來的。我看了 11 月 5 日那天的摘要,覺得準確可靠,就決定每天都要收到一份。
怎麼按時段叫出某一場的逐字稿?
一場會常分成好幾段錄音。像我 11 月初有一場下午的會,錄成 15:04–15:33 和 15:33–17:13 兩段;我只要說「15:00 到 17:15」,工具就得先找出這兩段,再把中間接起來。
虛線框是你說的時段,工具把框內兩段錄音的逐字稿挑出來,接成一份。
每段錄音都記了開始時間,逐字稿每句前面有時間碼,例如 [00:42:10] 代表開錄後 42 分 10 秒,兩者相加就是那句話實際說出口的時刻。我請 Claude 寫了一支小工具,給它日期和時段,它就把那段時間內每段錄音的逐字稿挑出來、接成一份。這支工具只讀我電腦裡的檔案,不連網,也不改原始筆記。
沒有這支工具也做得到:在 App 裡找出那個時段的幾段錄音,把逐字稿複製出來,每段註明幾點開錄,再一起交給 AI,跟它說你要的是幾點到幾點。少了開錄時刻,AI 只看得到時間碼,算不出實際是幾點。
裝了官方命令列工具的話,也可以用 getnote note transcript <筆記 ID> 直接印出某一則錄音的逐字稿(官方說明)。
AI 摘要最常錯在哪?我踩過的三個坑
AI 摘要最容易錯的是「誰說的」,再來是專有名詞和時間。下面三個坑我都踩過:
- 「錄音者」不一定是你。 App 的 AI 摘要會寫「錄音者」和「我的發言回顧」,但它抓的是講最多話的人。我就遇過一場會,摘要裡的「錄音者」其實是對方。看摘要前,先確認誰是誰。
- 說話人只有編號,名字要自己對。 逐字稿只標「說話人 1」「說話人 2」。我會先告訴 AI 常見對象是誰、什麼身分,請它從稱呼和內容判斷,推斷的地方標明「推斷」。大家常叫我「郎哥」,轉成文字卻常變「南哥」「狼哥」,所以我直接告訴 AI:聽到這幾個稱呼,被叫的就是我。
- 專有名詞和時間會寫錯。 台灣口音 n、l 不分,專有名詞特別容易錯;摘要也可能把「12 點」寫成「12 月」。有疑問的地方,回頭對逐字稿。
官方命令列工具的說明也提醒同一件事:要逐字稿,就用讀逐字稿的指令,別把 AI 摘要當成原文(官方說明)。
App 也有聲紋識別,可以讓 AI 記住特定人的聲音,之後自動認出來(2026 年 4 月的版本寫可以記住 5 個人的聲音,App Store 更新說明)。常見對象可以試著設定,設定前先問過對方。
設定位置在「我的账号」頁的「常用操作」→「声纹识别」:先打開「启用声纹标记」(會員專屬),再錄自己和常見對象的聲音;在錄音筆記裡點說話人,也能直接加聲紋。
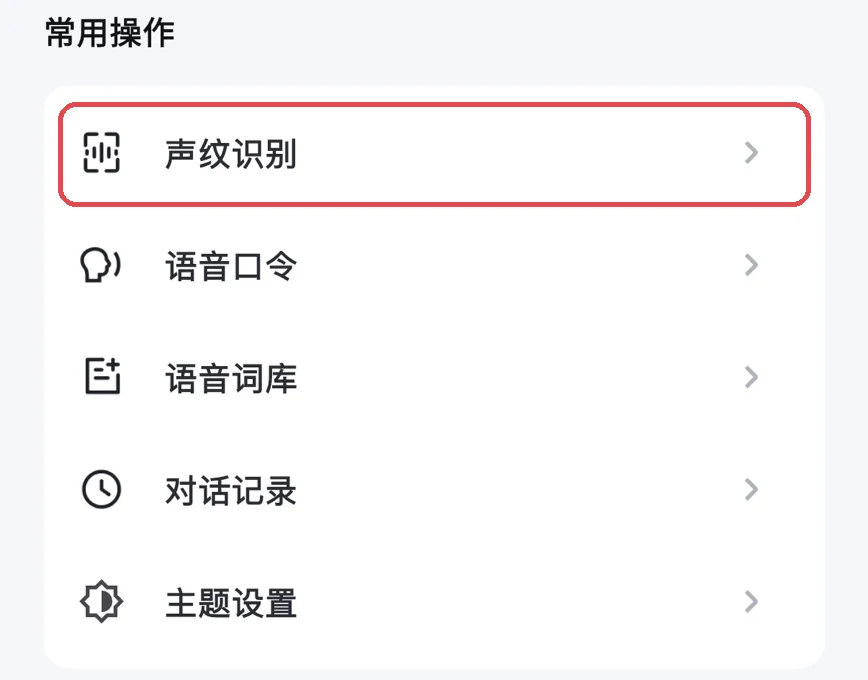
「我的账号」頁的「常用操作」(截圖節錄)。
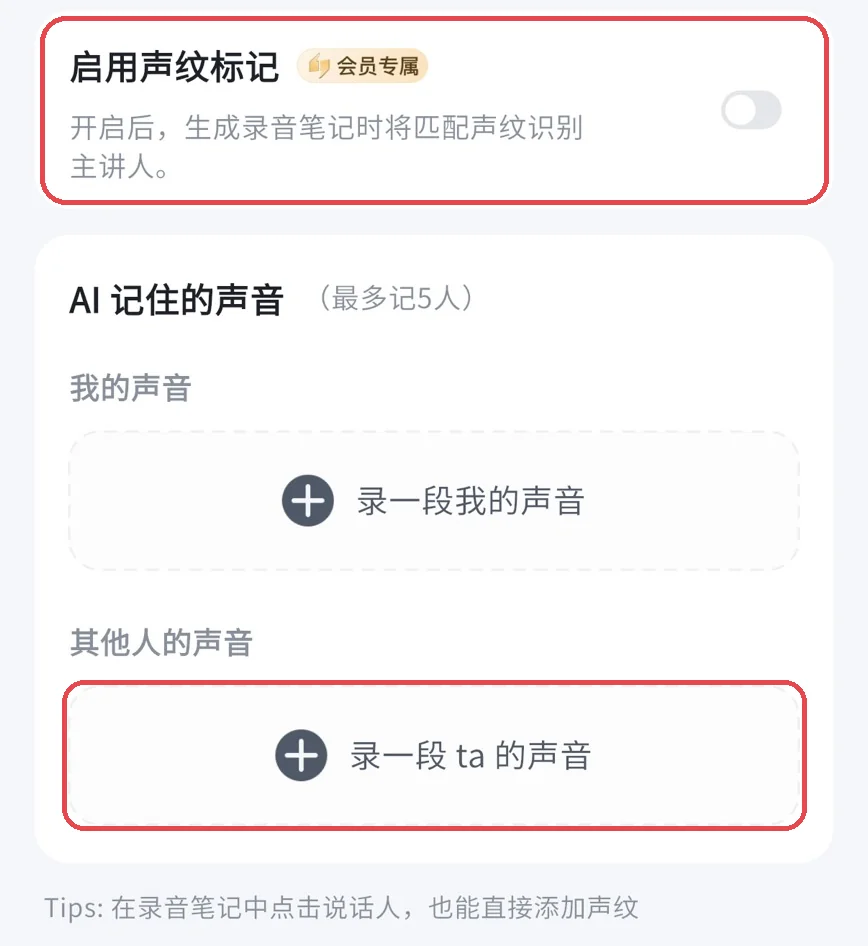
「声纹识别」頁:先打開「启用声纹标记」,再錄對方的聲音(截圖節錄)。
想把錄音接到自己的 AI?得到大腦開放平台的三條路
我晚上那次同步,走的是得到大腦的開放平台。平台給了三種接法:裝進 AI 工具的 Skill 和命令列工具(CLI)、給 AI 應用用的 MCP 連接器,還有自己寫程式呼叫的 OpenAPI。三種都要得到大腦會員,個人帳號沒開會員就呼叫不了(官方說明)。
三條路讀的是同一個帳號的資料,差在由誰來呼叫:AI 工具、AI 應用,或你自己的腳本。
| 接法 | 適合誰 | 怎麼開始 |
|---|---|---|
| Skill/CLI | 已經在用 Claude Code、Codex、Cursor 這類能執行指令的 AI 工具 | 到開放平台的「AI Agent」頁,把安裝指令交給你的 AI;自己裝就跑 npm install -g @getnote/cli@latest && getnote setup,再用瀏覽器登入授權 |
| MCP 連接器 | 用的 AI 應用有「自訂 MCP」或「連接器」入口 | 到「我的授權」複製服務地址,貼進應用的連接器設定,再登入授權,不用裝程式 |
| OpenAPI | 想自己寫腳本、做排程 | 到「應用管理」建立應用拿 Client ID,再到「API Key」頁建立 Key,兩個都放進請求標頭 |
MCP 這條路我用 Claude 實測過(2026 年 11 月)。在 Claude 加自訂連接器、貼上地址之後,Claude 預設的「自動註冊」會連線失敗。改成先向得到大腦註冊一個用戶端,再到 Claude 的連接器設定選「使用您自己的 OAuth 用戶端」,填入拿到的用戶端 ID、密鑰留空,就能登入授權,Claude 也讀得到筆記。註冊用戶端的指令:
curl -X POST https://openapi.biji.com/oauth/register \
  -H 'Content-Type: application/json' \
  -d '{"client_name":"Claude","redirect_uris":["https://claude.ai/api/mcp/auth_callback"],"grant_types":["authorization_code","refresh_token"],"response_types":["code"],"token_endpoint_auth_method":"none"}'
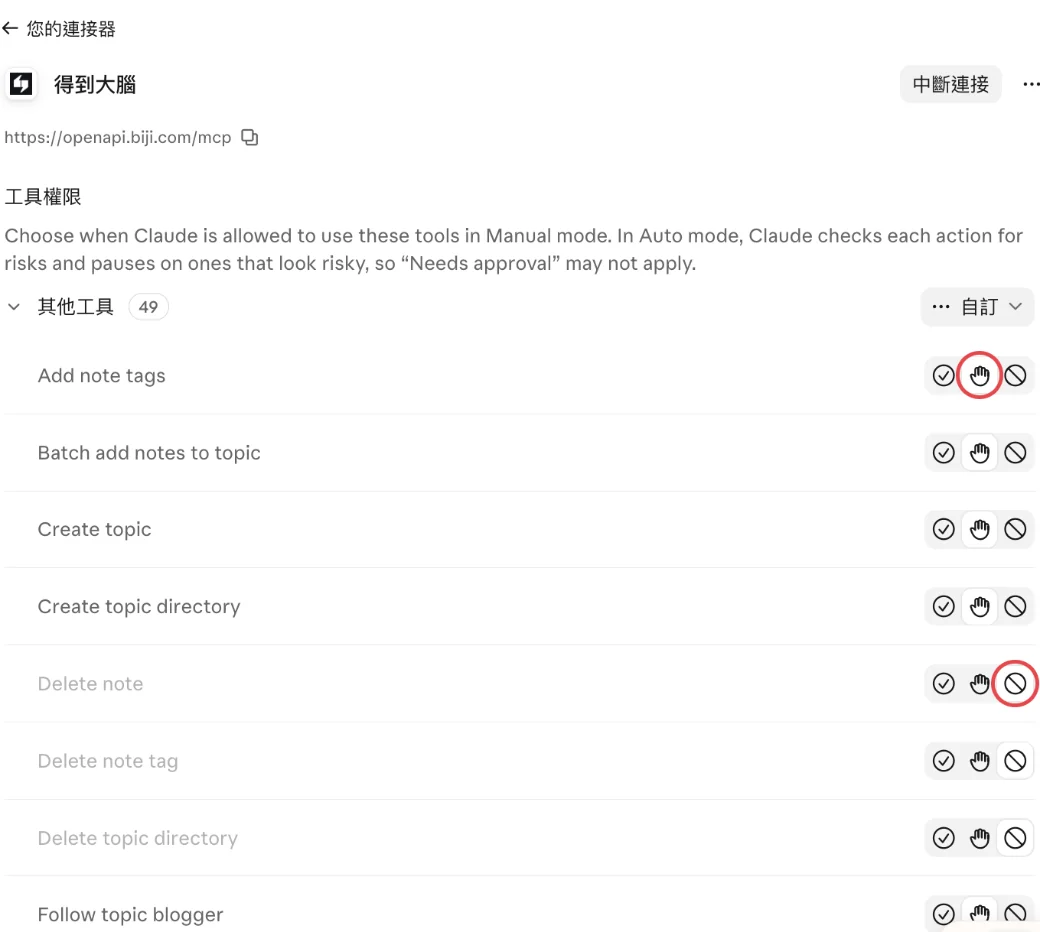
回傳裡的 client_id 就是要填的用戶端 ID。接上之後,Claude 的連接器設定頁會列出 49 個工具,可以逐一設定要不要先問你;刪除筆記這類工具不放心的話,可以直接設成封鎖。
我自己是這樣設的:讀取類 33 個永遠允許;刪除筆記、刪除標籤、刪除知識庫目錄、分享筆記這 4 個封鎖;其他 12 個會寫入的,要先問我。設定頁也寫明,自動模式下 Claude 會自己判斷風險,「需要核准」不一定會跳出來問你。真的不想讓它做的,就選封鎖。
我自己走第三條。每天晚上 8 點,電腦上的腳本用 API 把錄音卡的筆記拉回來,AI 摘要和逐字稿一起存成 md 檔;隔天早上的摘要和按時段撈逐字稿,讀的都是這些檔案。用 Get筆記 搭知識管線的來龍去脈,我在〈知識管理的管線〉寫過。不寫程式也有現成的做法:Obsidian 的外掛 GetBiji 用的就是官方 API,填上 Client ID 和 API Key,就能把還沒同步過的筆記抓進來。
官方快速開始給的第一個請求長這樣,拉得到筆記列表就代表接通了。API Key 直接放在 Authorization,不加 Bearer:
curl 'https://openapi.biji.com/open/api/v1/resource/note/list' \
  -H 'X-Client-ID: cli_xxx' \
  -H 'Authorization: gk_live_xxx'
跟錄音最相關的幾支 API:
- 筆記列表、筆記詳情:錄音卡的筆記也在這裡。詳情裡有 AI 摘要,也有標了說話人和時間碼的逐字稿。
- 讀取錄音標記:錄音時留下的標記。
- 語意搜尋(官方叫「語義召回」):用一句話在全部筆記或某個知識庫裡找相關內容。找不到不代表沒有,換個說法再問。
- 查詢額度:讀取和寫入各有每天、每月的上限,北京時間換日。
幾件要先知道的事:
- API Key 只完整顯示一次:建立當下就要存好。它等同帳號憑證,別寫進網頁前端,也別推上 Git。
- 權限可以只開需要的:主控台的「应用管理」能自建應用,16 項權限自己勾,Key 綁在應用上;官方內建的應用則是全部開放。我的同步只用一把唯讀 Key,實測要寫入會被擋;另一支要寫入的排程另用一把,能新增筆記,不能刪除和分享。
- Key 有自己的到期日:跟會員到期日是兩回事,到期前要在主控台續期。
- 錄音卡專用的那幾支 API,個人帳號用不到:文件裡的「錄音卡筆記」API 和事件推送,要企業代授權才能用;我用個人 Key 呼叫,回的是權限不足。好在錄音卡錄的筆記本來就在一般筆記裡,逐字稿照樣讀得到。
- 額度整個帳號共用:同一個帳號開幾支 Key、接幾個工具,額度都算在一起。我的會員帳號在主控台看到的讀取額度是每天兩萬次。
- 授權前想清楚:透過 MCP 或 Skill 授權出去的權限,能讀、改、刪、分享筆記,只交給信任的應用(官方說明)。能操作筆記的 AI 也別拉進群組聊天,免得別人問得到你的筆記(官方 Skill 說明)。
接上 Claude、建唯讀 Key 的做法,就在下面兩段操作示範。
操作示範:把得到大腦接上 Claude
以下是 Claude 網頁版個人方案(Pro、Max)的畫面,2026 年 11 月截圖。開始前,先用前面那行註冊指令拿到 client_id。
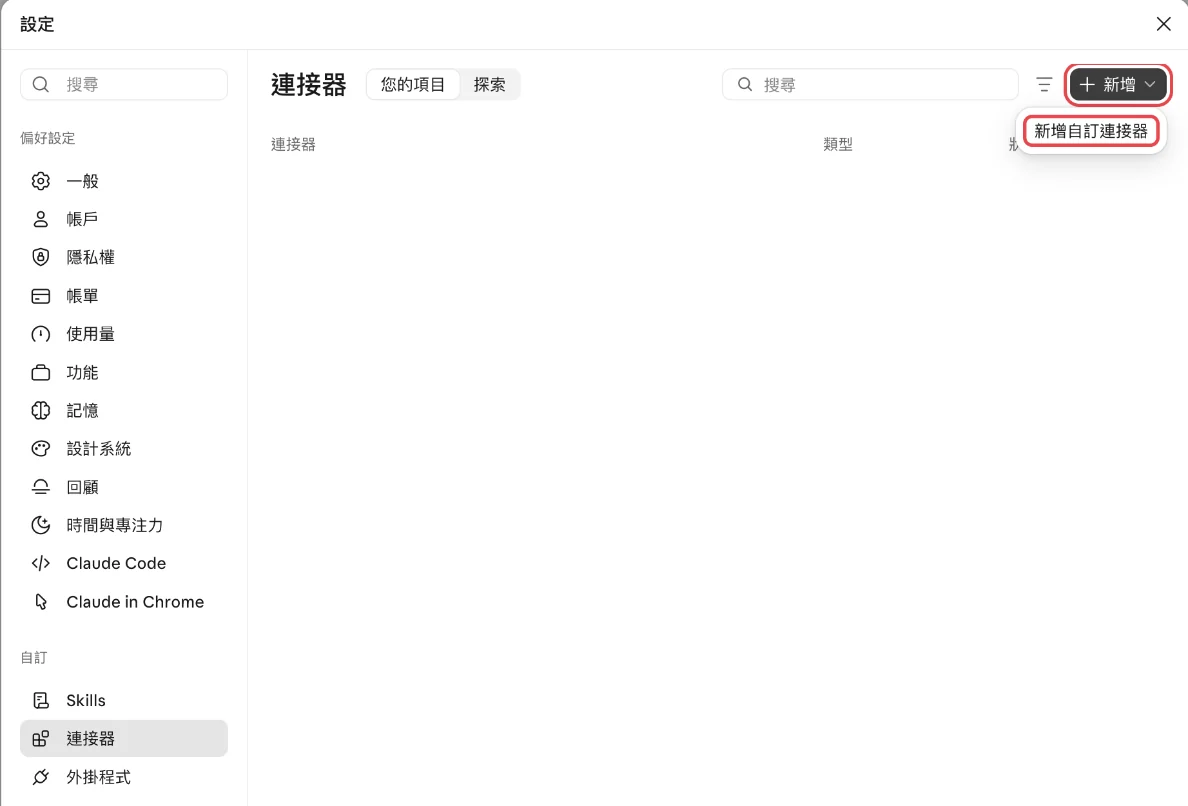
第 1 步:打開連接器設定。 到 Claude 的「設定」,點左邊「自訂」底下的「連接器」,再按右上角「新增」→「新增自訂連接器」。
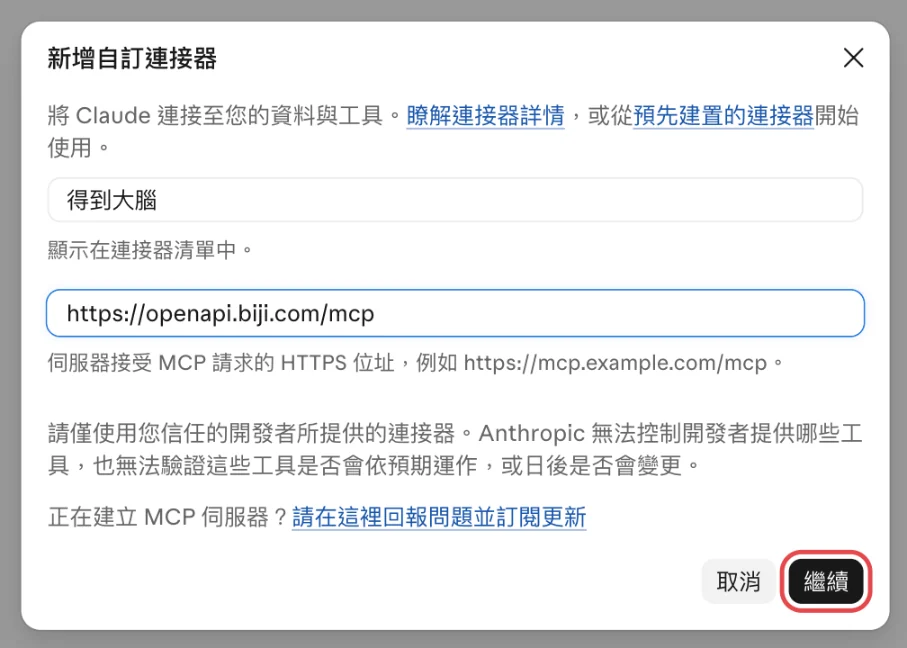
第 2 步:填名稱和網址。 名稱自己取,例如「得到大腦」;網址填 https://openapi.biji.com/mcp,按「繼續」。
第 3 步:改用自己的 OAuth 用戶端。 下一個畫面是驗證設定。不要用預設的自動註冊,改選「使用您自己的 OAuth 用戶端」,用戶端 ID 貼上 client_id,密鑰留空,再按繼續。這個畫面在我的帳號接好之後就叫不出來了,所以沒有截圖;Claude 說明中心也提到可以在這一步自己填 OAuth 用戶端 ID(官方說明)。
第 4 步:在得到大腦授權。 瀏覽器會跳到得到大腦的授權頁,按「授权」,再按「确认授权」。回到 Claude,連接器清單就會出現得到大腦。
第 5 步:設定工具權限。 在連接器清單點「得到大腦」,往下看「工具權限」。每個工具右邊有三個圖示:打勾是永遠允許,手掌是需要核准,禁止符號是封鎖。工具照英文字母排,Get、List、Recall 開頭的都是讀取。
操作示範:建一把只能讀的 API Key
以下是得到大腦開放平台的畫面,2026 年 11 月截圖,Client ID 已遮住。只需要讀筆記的程式,例如每天同步,用這種 Key 就夠。
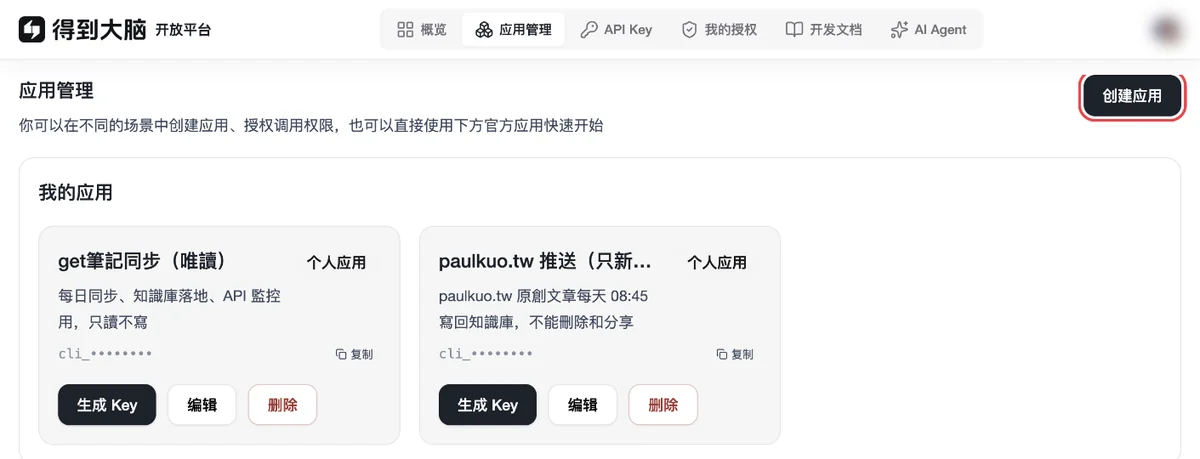
第 1 步:新增應用。 登入開放平台,點上方「应用管理」,按右上角「创建应用」。
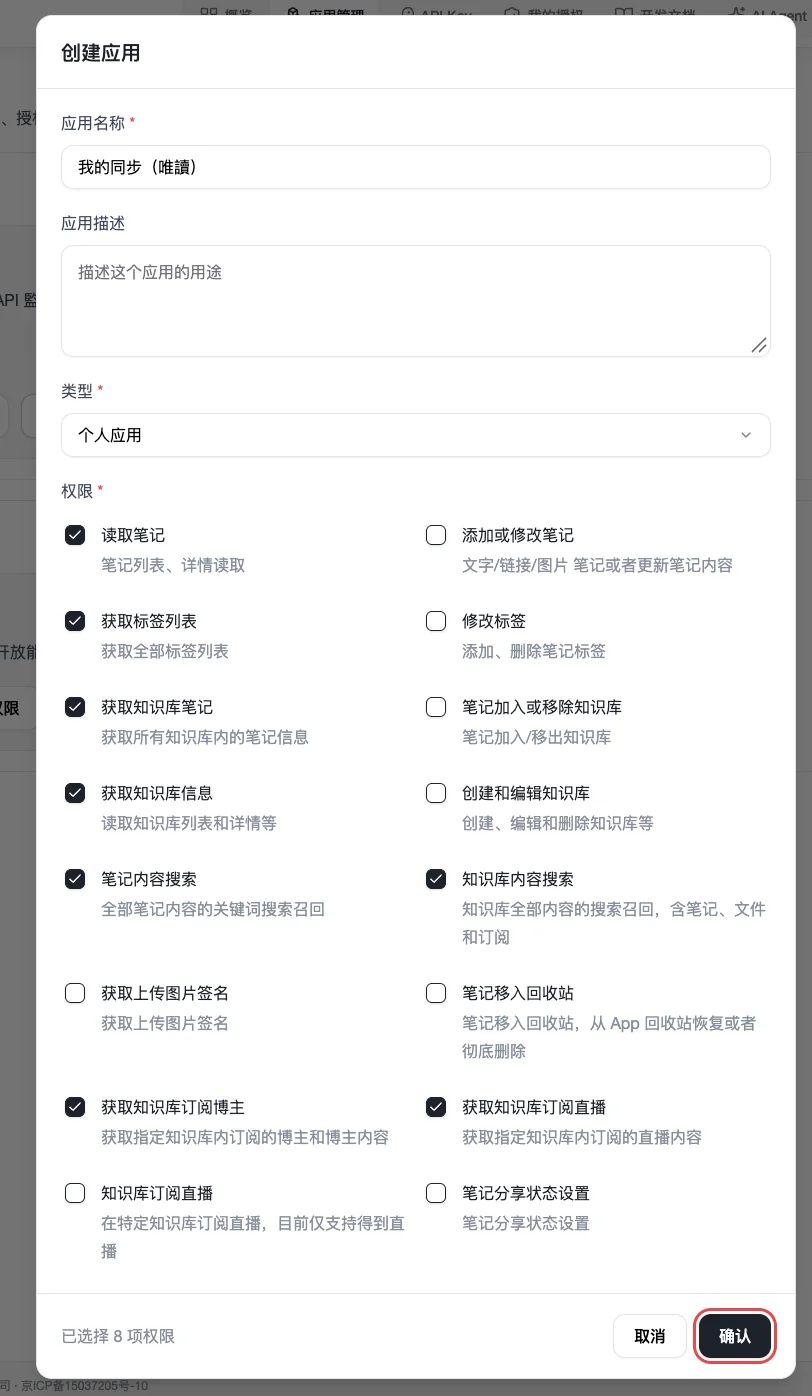
第 2 步:只勾讀取的權限。 取個名稱,類型留「个人应用」,權限只勾讀取的 8 項,就是截圖裡打勾的那些。底下顯示「已选择 8 项权限」,再按「确认」。
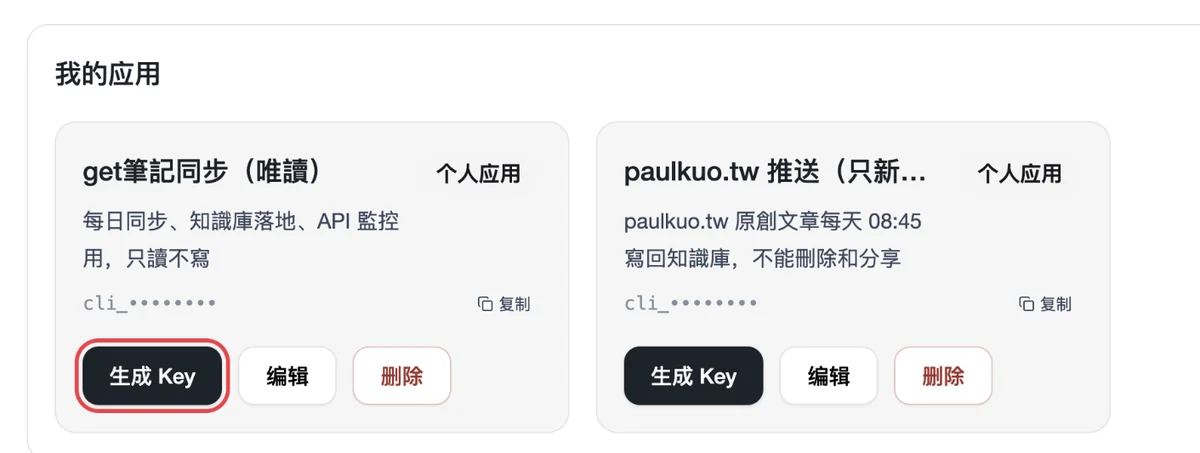
第 3 步:產生 Key。 回到「我的应用」,在剛建的應用卡片上按「生成 Key」。
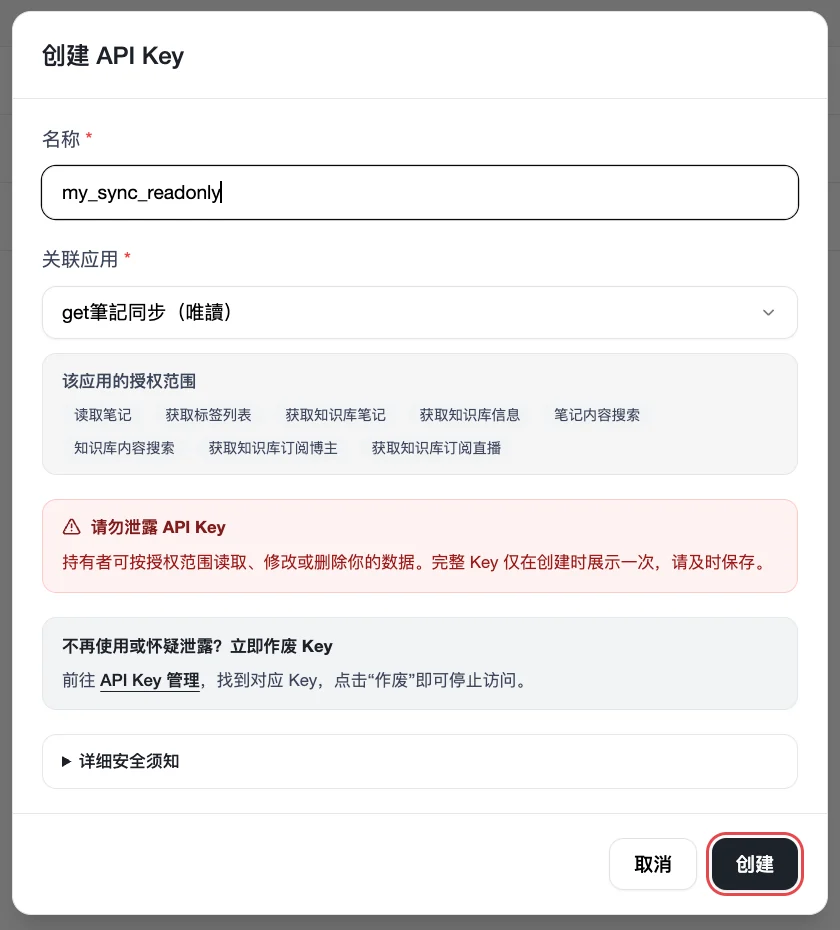
第 4 步:確認範圍再建立。 填一個 Key 名稱,看一下「该应用的授权范围」只有讀取的項目,按「创建」。
第 5 步:馬上存好 Key。 下一個視窗會顯示 API Key 和 Client ID,只出現這一次。按「一键复制」,存到密碼管理器或程式的 .env 檔。這個視窗裡是真的 Key,所以不放截圖。
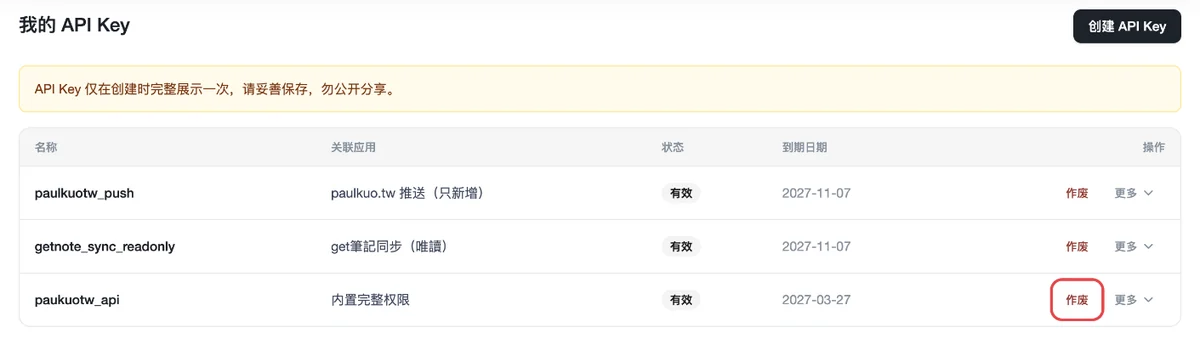
第 6 步:舊的 Key 作廢。 換上新 Key、確定程式正常之後,到「API Key」頁把不用的那把按「作废」。作廢後就不能再用,按之前先確定沒有程式還在用它。
你該用到哪一級?三種程度的用法
不用照抄我的做法,先看你願意花多少力氣,從第一級開始。一個月只錄一兩次,或完全不能接受錄音上傳雲端的話,評測直說買這類錄音卡不太划算(ToolNavs)。
先從第一級開始;想用自己的摘要格式再加第二級,想每天早上自動收到摘要,才需要第三級。
第一級:只用 App
適合大多數人,什麼都不用裝。
- 白天開著錄;不想整天錄,至少開會、上課時開。
- 重要時刻短按 MARK 做記號,有靈感就長按 MARK 直接講。
- 重要的會一結束,先把錄音卡同步到 App,看那一場的摘要;要留檔,就從右上角選單的「导出」存成 Markdown、PDF 或 DOCX。
- 晚上回家,再把一整天的錄音同步到 App。
- 隔天看 App 的摘要;想回顧一整天,看 AI 助理「小步」晚上整理的日記。
- 找以前講過的內容,直接問 App 的 AI,它會根據你的筆記回答。
第二級:App 加一個 AI 助理
適合已經在用 ChatGPT、Claude 這類 AI 助理的人。
- 在那一場筆記右上角的選單點「复制文字记录」,選「原文版」,比較接近現場講的話(2026 年 3 月起可選「原文版」或「AI 優化版」,人人都是產品經理)。每段註明幾點開錄,再貼給 AI,用下面這段提示詞。
- 貼之前先看那個 AI 服務的資料設定,例如會不會拿對話去訓練模型;敏感內容先刪掉人名再貼。
- 已經在用 Claude Code、Codex 這類工具的人,可以到開放平台的「AI Agent」頁,把安裝指令交給你的 AI,它會裝好官方 Skill 和命令列工具;登入授權後,一句話就能查筆記、讀錄音逐字稿。用的 AI 應用有自訂連接器的話,也可以走 MCP,不用裝程式。兩種都要得到大腦會員,細節見前面「得到大腦開放平台的三條路」那一節。
以下是我的錄音逐字稿,日期__,我要的時段是__到__。每段開頭我註明了開錄時刻,逐字稿的時間碼加上開錄時刻,就是實際時刻。請整理成摘要:
1. 第一行寫:一共幾段、幾點到幾點。
2. 每段寫「HH:MM–HH:MM|主題(跟誰)」,下面列 3 到 6 個重點。
3. 逐字稿只有「說話人 1、2」,請從稱呼和內容判斷是誰,推斷的地方標「推斷」。我是__,大家常叫我__。
4. 聽不清楚或破碎的段落直接寫出來,不要自己補完。
5. 最後列「待追」2 到 5 點。
第三級:全自動(我現在的做法)
適合不怕設定,或身邊有人能幫忙接的人;我是請 AI 一步步幫我接起來的。
- 重要的會一結束,用手機或電腦的得到大腦 App 匯出成 md 檔,單獨存到電腦。
- 晚上透過得到大腦的開放 API,把一整天的筆記同步成自己電腦裡的檔案。
- 排程讓 AI 每天早上整理前一天的錄音,手機收通知。
- 要細看時,按時段把逐字稿切出來。
- 會議錄音按專案分資料夾,只留在自己電腦。
要準備的東西:得到大腦會員、開放平台的 Client ID 和 API Key、一台固定開著的電腦,還有一個能排程的 AI 工具。我用 Claude 桌面版,排程跑的時候 Mac 要醒著、Claude 要開著。
錄音之前要知道的事
台灣法律。 你自己就在對話裡、錄音目的正當,依通訊保障及監察法第 29 條一般不罰;但錄下你沒參與的別人非公開談話,可能觸犯刑法妨害秘密罪和通保法(法律百科、104 職場力)。所以錄音卡別放在會議室、人卻離開。整天錄還要多注意旁人:收音範圍內你沒參與的私下談話,不在「你是對話一方」的範圍內;旁人私下談話時先把錄音關掉,錄到的別留用、別轉傳。我不是律師,個案以法院判斷為準。
禮貌。 合法不等於對方舒服。正式場合開頭說一聲「我有開錄音做紀錄」,對方知情,之後拿紀錄出來對也比較自然。簽過保密協議的場合,先看約定怎麼寫。
資料放哪。 這類錄音卡的錄音和轉逐字稿都要經過廠商的雲端,內容會離開你的手機(ToolNavs);得到大腦也是同步上傳後才轉逐字稿,開發商在北京(App Store)。很多公司本來就不准在客戶或敏感會議用這類個人裝置,買之前先問清楚(同一篇 ToolNavs)。得到大腦的隱私政策寫了哪些,我整理在文末附錄。
分場合錄。 對資料放在中國雲端有顧慮的話,可以照內容分三種處理:
- 直接錄:公開演講、課程、讀書心得、自己的想法。
- 處理過再錄:一般商務會議。談到價格、合約條件、個資或健康狀況時先暫停;重要的匯出 md 存到自己電腦,再把雲端那份刪掉。App 會提醒刪了就找不回來,不過依隱私政策,備份要等系統更新才會刪。
- 不錄:簽了保密協議的案子、客戶機密、價格談判、人事、看診,還有公部門人員在場的公務會議。真的需要逐字稿,就用在自己電腦上跑的轉寫工具,例如開源的 Whisper。
越往下,留在雲端的越少;最下面那種從頭到尾都不上雲端。
刪除筆記時,App 會跳出確認,提醒刪了就找不回來(截圖節錄)。
公務機關和公立學校的公務,依規定本來就不能用大陸廠牌的軟體和服務(工商時報)。行政院 2023 年訂的生成式 AI 參考指引也規定,公務上要保密的資訊和個資不能交給生成式 AI;封閉式、地端部署的模型,要先確認系統環境安全,才能依機密等級分級使用(行政院、數位時代)。
國安局 2025 年 7 月抽驗小紅書、微博、抖音、微信、百度雲盤五款中國 App,五款都有過度蒐集個資和權限濫用的問題。國安局也提醒,依中國的網路安全法和國家情報法,政府可以要求企業把用戶資料交給國安、公安和情報部門(NOWnews)。這次抽驗沒有包括得到大腦,我也沒查到國安局公開檢測過它。
國安局 2025 年 11 月又抽驗了 DeepSeek、豆包、文心一言、通義千問、騰訊元寶五款中國生成式 AI App,五款都要求位置資訊、蒐集截圖、強迫同意不合理的隱私條款,也蒐集設備參數,生成的內容還有嚴重偏頗和不實資訊(聯合新聞網)。豆包和通義千問也在得到大腦隱私政策列的 AI 服務裡(火山引擎的豆包、阿里雲的通義千問),不過國安局測的是它們自己的 App,不是得到大腦。
哪些能分享。 我的規矩是看內容,不看工具。會議、洽談錄到的,一律只留給自己;用錄音卡錄下電腦播的公開直播或講座,用自己的話整理後可以分享。像我 5 月參加 Claude Taipei 的國防 AI 分享會,就是用錄音卡錄下來,請 App 的 AI 和 Claude 幫忙整理成筆記,再公開貼到臉書(臉書貼文)。
額度和費用。 免費版每月 600 分鐘等於 10 小時,整天錄差不多一兩天就用完,想整天錄等於要開會員。評測也提醒,這類產品硬體一次付清、AI 功能要一直付,停掉訂閱,核心功能就去掉大半(同一篇 ToolNavs)。
先錄,再決定什麼重要
整天錄,讓「這場要不要錄」不再是當下的問題。重要的會當場整理,其他的交給晚上那一次。
想試的朋友從第一級開始:明天整天開著錄,重要的會一結束先同步、看那一場的摘要,晚上再把一整天同步,隔天早上看一次摘要。連續一週,你就知道自己需不需要往下一級走。要往下走,先試開放平台的 Skill 或 MCP;需要排程和自動化,再碰 API。
這篇放在「智能與秩序」的人機協作底下。
附錄:得到大腦的隱私政策寫了什麼
得到大腦的隱私政策寫明,個資存在中國境內,AI 功能交給三家中國廠商處理。下表是我 2026 年 11 月 7 日讀隱私政策原文整理的,版本是 2026 年 5 月 20 日發布、5 月 27 日生效。
手機上也看得到全文:得到大腦 App 的「关于我们」頁有「隐私政策」,點開就是。
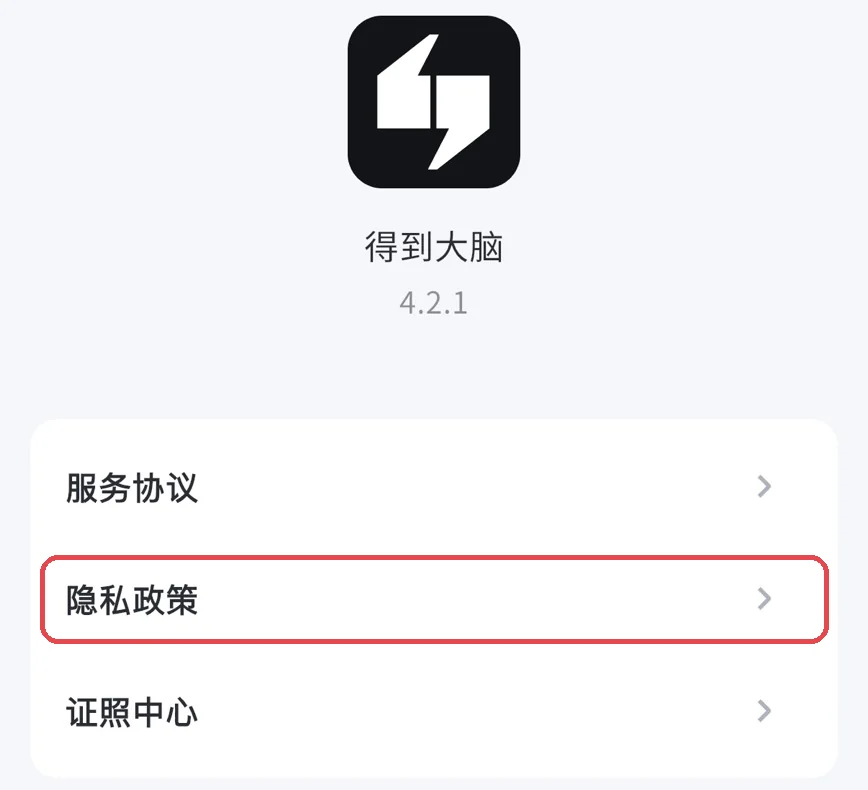
得到大腦 App 的「关于我们」頁(截圖節錄,App 版本 4.2.1)。
| 項目 | 政策怎麼寫 |
|---|---|
| 資料存哪裡 | 在中國營運時收集和產生的個資,存在中國境內;除非法律有規定或你明確同意,不傳到境外 |
| 收集什麼 | 你輸入的文字、圖片、語音,用來同步、整理和搜尋筆記 |
| AI 功能 | 火山引擎(豆包)、阿里雲(通義千問)、智譜(GLM)處理你輸入的文字和上傳的圖片 |
| 語音轉文字 | 列了騰訊雲的即時語音辨識。整份沒提到錄音卡,錄音卡的音檔交給誰轉寫,看不出來 |
| 分享給第三方 | 上傳內容裡的個資,沒經你同意不會分享給其他公司。為了改進服務,可能把匿名化或去識別化的資訊給合作夥伴 |
| 不用你同意的情形 | 跟國家安全、國防安全、公共安全、刑事偵查和審判等有關時,收集、使用、揭露都不用你同意 |
| 拿去訓練模型 | 整份沒提到 |
| 聲紋 | 整份沒提到。敏感個資列的是特定身分和未滿十四歲者的資料,沒列生物辨識 |
| 手機權限 | 定位、相機、麥克風、相簿預設不開,你同意才授權;剪貼簿在手機上讀,不上傳 |
| 微信登入和分享 | 走騰訊的 SDK,會收裝置識別資訊,包括 MAC 位址 |
| 刪除 | 你刪掉的資料,備份系統要等更新時才刪 |
| 註銷帳號 | 要找人工客服申請,審核通過後刪除或匿名化,註銷後不能恢復 |
| 個性化推薦 | 可以關,路徑是 App「我的 → 设置 → 隐私设置」(這是政策寫的位置;App 4.2.1 的「设置」頁沒有這一項) |
對照 App 的「设置」頁(2026 年 11 月):「自动读取剪切板链接」是一個開關,可以關掉。「本地录音与音频」顯示手機上也留著錄音,包括錄音卡的檔案;按「整理」會清掉手機上的那份,還沒同步的也會一起刪掉、救不回來,雲端已同步的不受影響。最下面是「注销账号」。
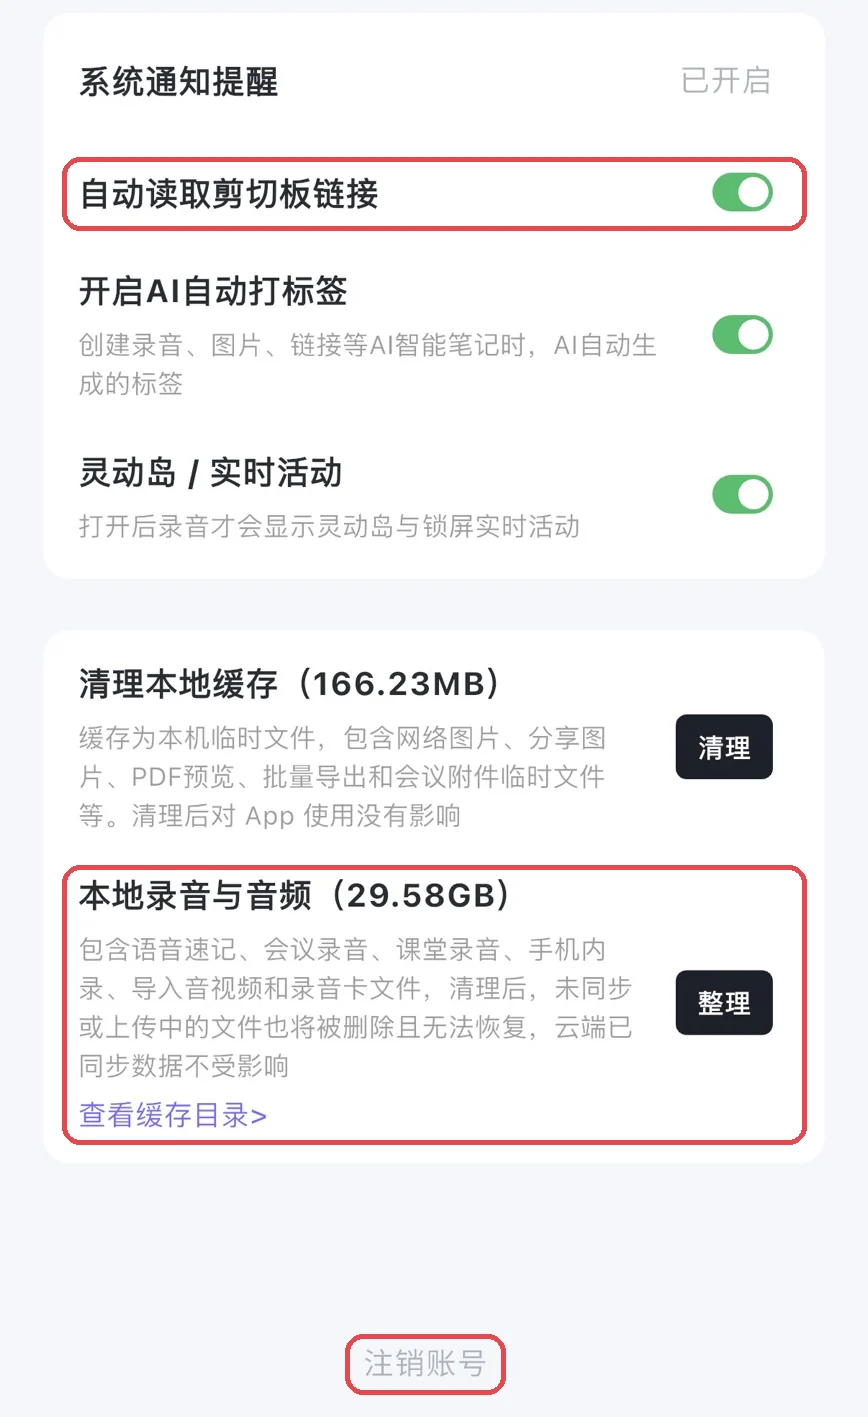
得到大腦 App「设置」頁的下半部(截圖節錄)。
條文會改,以官方最新版為準。表裡「整份沒提到」的項目,是我在原文裡找不到的內容。
參考資料
- 少數派,玉樹芝蘭:Get 筆記為什麼又回到了我的知識工作流?(2026-03-25)
- 人人都是產品經理,AI星球:Get筆記測評:這款 AI 筆記工具憑什麼脫穎而出?(2026-03-24)
- 人人都是產品經理,亨亨:微信發布第一款 AI 硬體,由此引發 3 點思考(2026-07-11)
- ToolNavs:AI 錄音卡值不值得買?(2026-10-04)
- 得到大腦說明文件:得到 AI 錄音卡(GetSeed AI 錄音卡)
- AI 工具集:GetSeed AI 錄音卡是什麼(2026-01-02)
- 得到大腦(原 Get筆記)App Store 頁面與版本紀錄
- 應用寶:得到大腦 App 介紹
- 得到大腦開放平台:快速開始、MCP 接入、額度說明與 AI Agent 頁
- 得到大腦命令列工具 @getnote/cli 說明(pkg.go.dev)
- 得到大腦官方 Skill 說明(termo.ai 轉載)
- Obsidian 外掛:GetBiji
- 法律百科:錄音是否違法的法律問答(2020-09-02)
- 104 職場力,蘇宏文律師:職場密錄的法律分析(2019-12-04)

💬 留言討論
載入中...