TL;DR:Felix Riesebergが書いたAI野心のチュートリアルは、モデルにソフトウェアをインストールできるマシンと関連データが必要だと説明し、外部検証の徹底も特に強調している。この記事では、3社のAIにClaudeを審査させた経験をもとに、別のモデルを審査員にするときの外部検証の組み方と、それが「どこまで任せられるか」という感覚をどう変えるかを補足する。
Felix RiesebergはAnthropicのエンジニアリングマネージャーで、Claude.ai、Cowork、Claude Codeのデスクトップ版のエンジニアリングを担当してきた。10月13日、彼は個人サイトに〈How to be more ambitious: A tutorial for humans with models〉を公開し、自身の経験を語った。彼はかつてClaudeに一度に一つのクラッシュを修正させていたが、やがてチームのアプリをクラッシュしない状態に保つことをそのままClaudeに任せるようになった。
そのためにまず、Claudeがクラッシュレポートを読み取れるよう設定し、バージョンとコードの対応関係も参照できるようにした。3種類のOSのマシンも与え、問題を自分で再現して修正を確認できるようにした。
「AIをもっと野心的に使う」がなぜ実行しにくいか
Felixは、自分を含むAI関係者が「もっと野心的に」という言葉を繰り返し、印象的な成果を見ては転載し、まだ野心が足りないとコメントすることに触れている。ただ彼自身、このアドバイスがそのままでは実行しづらいとわかっていて、野心を4種類に整理した。
| 野心 | 意味 | Felixが挙げた例 |
|---|---|---|
| 速度 | 同じ作業をより短い時間で終える | コードを書くとき、Claudeを使えば速くなる。この手法はすでに成熟しているとして彼は割愛している |
| 高度 | 依頼のレベルを上げ、個別タスクから最終的に欲しい結果へ切り替える | 一度に一つのクラッシュを修正させていたのを、チームのアプリをクラッシュしない状態に保つよう直接依頼するようにした |
| 深度 | その分野のトップ専門家と同じやり方で、生のデータ・専門ツール・問題の根本に直接当たる | データベースや統計モデルなどトップ専門家が使うツールにこだわる。生データを渡して自分の仮定を逆に検証させる。外部の審判を立て、モデル自身に評価させない |
| 広度 | タスクの表面上必要な領域だけでなく、普段は使わない知識・ツール・手法を他の領域から持ち込む | 名詞を動詞に換えて使える領域を探す。タスクのために分野横断のチームを編成する |
後ろの3種類については、具体的な手法が列挙されており、一部にはプロンプトも添えられている。
記事の末尾では心理学の自己効力感を取り上げ、人は自分が可能だと信じる範囲に行動を縛られると論じている。それより前に、彼は前提を明記している。文中で語る野心的な手法はいずれも、モデルがソフトウェアをインストールできるマシンと、関連データへのアクセスが必要だ、と。タスクをより深く掘り下げるための問いの中にも、データ・ツール・外部検証に対応する3項目がある。最も生の素材は何か、どんな手法とツールを使うべきか、そして自分たち以外に結果の正しさを証明できるものは何か、という問いだ。
マシンとデータは彼が明示した前提だ。外部検証は「深度」の節の一手法として登場し、特に徹底するよう強調している。また、モデルが賢くなるほど、より高次の目標をそのまま受け取れるようになる傾向があるとも観察している。ただし2026年時点では、ほとんどの会社でClaudeに「収益を上げて」と言うだけでは通用しないようだとも述べている。彼の記事を読むと、AIを野心的に使うことの一部はインフラの問題だとわかる。冒頭のクラッシュしない状態を保つという例自体、検証パイプラインそのものだ。私が補いたいのは、彼が展開しなかった2点だ。別のモデルを審査員にするときの外部検証の組み方と、それが「どこまで任せられるか」という感覚をどう変えるか、だ。
AIの外部審判はどう組むか
Felixは「深度」の節で外部審判について数行書くにとどめている。「Do not ask the model to judge itself」。外部検証には、モデルが自ら実行してすぐフィードバックを得られるツールを使うのが最善だという考えだ。モデルが賢くなれば最終的には解決するとみているが、2026年10月時点ではぜひ徹底してほしいと読者に訴えている。Huangら2023年の研究は、GPT-3.5やGPT-4などの当時のモデルを用いたテストで、外部フィードバックなしにはモデルが自ら推論を修正することは難しく、修正後にかえって精度が下がることもあると示している。
この数ヶ月で私が加えた別の形の外部検証は、別の会社のモデルに審査させることだ。実行可能なツールのように即座にフィードバックが得られるわけではなく、独立性にも限界がある。この点は後述する。今年7月に米イラン戦争の分析を書いた際は、Grokに情報を収集させてレポートにまとめ、Perplexityが再整理し、Claudeが初稿を書いた。ファクトチェックは別のAgentに任せた。成果物だけを渡し、推論過程は見せず、すべてのリンクを開いて確認するよう指示した。そのAgentはBruegelのPDFとOFACの公告を照合し、初稿の中の3つの誤りを抽出した。振り返ると、3つのモデルいずれもデータをレポートや初稿に整理する段階で誤りを出した。少なくともあのテストでは、検索の精度は当初の予想より高かった。
現時点での私の構成は次のとおりだ。
| 役割 | 担当 | 防衛ライン |
|---|---|---|
| 実行者 | Claude Code | 成果物を3社に渡して誤り抽出 |
| 審査員 | OpenAIのCodex | 読み取り専用。毎回ログを確認し、実際に動いたモデルを把握 |
| 審査員 | xAIのGrok | 3層の読み取り専用:ツールリスト・権限ルール・サンドボックス |
| 審査員 | GoogleのAntigravity | 読み取り専用。Googleのモデル(Gemini)のみ実行 |
| リサーチ担当 | Perplexity | 情報収集と元の情報源の提示、後から照合できるよう記録 |
| 最終判断者 | 私 | 重要な事実は元の情報源に戻って確認 |
この分担表はモデルの世代交代に合わせて見直す。この構成で気づいた4種類の偽安心については〈AIの審査報告でいちばん危ないのは、査読済みに見えることだ〉に書いた。ここでは構成に関わる2つの経験を取り上げる。
自分のMacでGrokを設定したとき、最初はファイルへの書き込みを禁じた。拒否されたGrokはシェルを使い、別のルートから書き込もうとした。最終的にはmacOSのサンドボックスに遮断された。その後、Grokには3層の読み取り専用制限を重ねた。ツールリストは読み取り系のツールのみ許可し、権限ルールで書き込みとコマンドラインをブロックし、最下層でサンドボックスがもう一度止める。1層を突破されても、次の層がある。
Codexはログを確認する習慣を作るきっかけになった。設定が反映されなかったとき、Codexはエラーを出さず、黙ってデフォルトモデルに切り替え、見た目には丁寧な報告書を出してきた。それ以来、毎回ログに戻り、実際にどのモデルが動いたかを確認している。
複数のAIで相互審査しても、なぜ不十分なのか
審査員の独立性には、少なくとも2つの層がある。一つは、成果物を出した側の影響を受けないこと。渡す問いに自分の結論を混ぜてはいけない。具体的なやり方はcodex に Claude の誤りを指摘させた、ただし言いなりにはならないに書いた。7月のファクトチェックでも一つのルールを定めた。審査員は成果物を出した側の推論過程を先に読んではいけない。同じ論理に引きずられるのを防ぐためだ。もう一つの層は出自、つまりどの会社のどのアーキテクチャのモデルかという問題だ。第二意見を求める際、AntigravityのモデルリストにはClaudeも含まれているが、Googleのモデル(Gemini)しか動かさない。ClaudeがClaudeを審査する構図を避けるためだ。
この2層を重ねても、独立性には限界がある。Kimら2025年の研究は、350以上のモデルの2つのベンチマークにおける回答記録を分析した。あるベンチマークの問題で2つのモデルがともに誤答した場合、6割が同じ誤答を出していた。同じ会社のモデルは誤りの相関がさらに高く、会社を変えることには意味がある。しかし大規模で精度の高いモデルは、会社もアーキテクチャも違っても誤りが高度に相関しており、会社を変えるだけでは不十分だ。
この研究は問題への回答を対象としており、論文ではこの相関がモデルを評価者として使う結果にも影響すると指摘している。私なりに一歩進めて言えば、モデル同士で相互確認するときも、同じ誤りを一緒に見逃す可能性がある。7月のファクトチェックで誤りを捕捉できたのは、審査員がBruegelのPDFとOFACの公告を実際に開いたからだ。元の情報源に戻るか、実行可能なツールで検証することで、この種の共通の誤りが浮かび上がりやすくなる。Felixがツールを使うのが理想だと言う方向性と、これは一致している。
自己効力感はどこから来るか
Felixは記事の末尾で自己効力感を取り上げ、意図的に高めることができるという証拠があると述べている。彼がLockeとLathamの目標設定研究35年の振り返り論文から引いた結論は、具体的かつ難しい目標を与えられた人は、ただ頑張れと言われた人より良いパフォーマンスを出す、というものだ。
同じ論文の中でLockeとLathamはこう書いている。目標を有効に機能させるには、自分が目標にどれだけ近いかを知るフィードバックが必要だ。自分の進捗を把握できなければ、力の配分や方法を調整することは難しく、場合によっては不可能になる。
人とAIの協働に当てはめると、エラー検出の仕組みはこの種のフィードバックとみなせると私は考える。Felixがクラッシュしない状態を保つという結果をClaudeに任せられたのは、再現と検証のパイプラインがすでに接続されていたからだ。私が今、3社のAIにClaudeの成果物を安心して審査させられるのは、痛い目を見た後に読み取り専用の制限とログ確認の習慣を加え、重要な事実は元の情報源に戻って確認するようにしたからだ。エラー検出の仕組みが確実なほど、人はより大きな仕事をAIに任せられるようになる。
これは3月に書いた知識管理は自律ではなく、パイプラインに頼ると接続する。ただし7月のファクトチェックで気づいたのは、あの結論は半分しか正しくなかったということだ。パイプラインはデータを運び、情報源を残せる。しかし起動するかどうかは、結局人が決める。野心も同じで、エラー検出の仕組みをどれほど整えても、最後に判断を下すのは人だ。私がよく語るスーパー個人は、一人で組織規模の成果を出す存在だ。2月の記事では采配と判断を論じたが、今振り返ると、そこに一層ずつ重なるエラー検出の仕組みを加える必要がある。
手首に縛りつけた翼
Felixは記事の冒頭で飛行の比喩を使ってAI活用の落差を描き、版画〈飛行の方法〉(Modo de volar)を配置している。Goyaの晩年の連作「Disparates(荒唐)」の一枚で、5人が鳥頭型のヘルメットをかぶり、翼を紐で手首と足に縛りつけている。メトロポリタン美術館の解説によれば、この絵はかつてスペインの保守派が反対した新しい政治・哲学思潮の隠喩として読まれたこともあり、当時マドリードで流行した熱気球の見世物とも結びつけて解釈される。
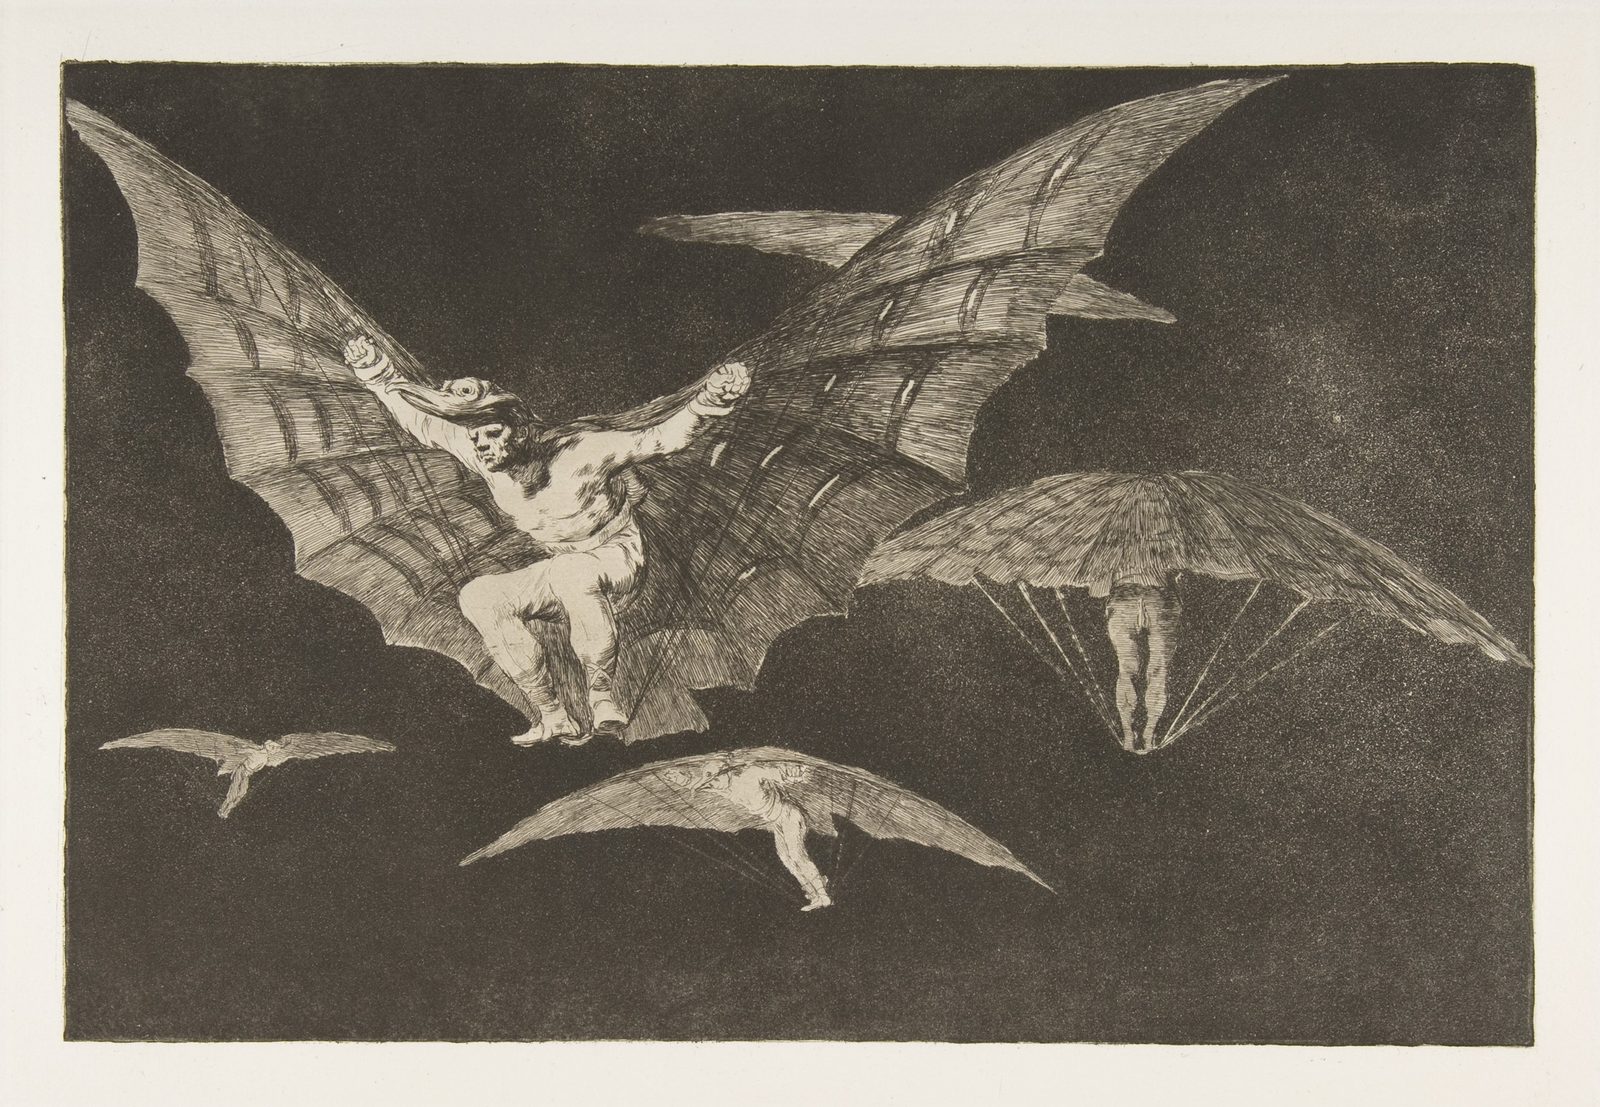 Goya〈飛行の方法〉(Modo de volar)、約1815〜16年制作、1864年出版。画像提供:メトロポリタン美術館、パブリックドメイン。
Goyaがこの人物たちに期待を込めたのか嘲笑を込めたのか、私には判断できない。私が気に留めているのは、翼と体のあいだに、自分の手で結ばなければならない紐がまだ何本かあることだ。
AIを使うのも同じだ。仕事を任せたあとも、間違えたらどこを確かめるのか、ずれたらどう引き戻すのか、最後の判断を誰が引き受けるのかを、私は知っていなければならない。こうしたことが少しずつはっきりするたびに、これまで任せられなかった仕事を、もう一歩先まで任せられるようになる。
だから、AIをもっと野心的に使いたいなら、まず確かめてほしい。検証し、修正し、責任を引き受けるための紐が、ちゃんと結ばれているかどうかを。本当の勇気は、こうした細部に宿る。起こりうる失敗にどう応じるかがわかっていてこそ、まだどこへ飛べるかを考える余裕が生まれる。
知性と秩序のテーマページから、このシリーズの他の記事も読める。
💬 コメント
読み込み中...