TL;DR:Felix Rieseberg 写的 AI 野心教学,已经说明模型需要一台能安装软件的电脑和相关数据,也特别强调要坚持外部验证。这篇文章用我让三家 AI 审查 Claude 的经验,补上用别家模型当审查员时,外部验证可以怎么搭,以及它为什么会改变人敢交办的范围。
Felix Rieseberg 是 Anthropic 的工程经理,至今负责过 Claude.ai、Cowork 和 Claude Code 桌面版的工程。10 月 13 日,他在个人网站发表〈How to be more ambitious: A tutorial for humans with models〉,分享了自己的一段经验:他原本请 Claude 一次修一个闪退,后来干脆交代 Claude,让团队的 app 保持不闪退。
要做到这一点,他先让 Claude 能读取闪退报告、查到版本和代码的对应关系,也给了它三种操作系统的电脑,让它能自己重现问题、确认有没有修好。
「用 AI 要更有野心」为什么这么难照做?
Felix 说,他和其他做 AI 的人常把「更有野心」挂在嘴边,看到厉害的成果就转贴,再补一句大家还不够有野心。但他也明白,这个建议很难照做,所以把野心分成四种:
| 野心 | 意思 | Felix 举的例子 |
|---|---|---|
| 速度 | 同样的事,花更少时间做完 | 要写代码,用 Claude 会写得更快。他认为这种做法已经成熟,所以跳过不谈 |
| 高度 | 把交办的层次往上拉,从单一任务改成最后要的结果 | 他原本请 Claude 一次修一个闪退,后来直接交代它让团队的 app 保持不闪退 |
| 深度 | 像领域顶尖专家那样做,直接碰原始数据、专业工具和问题的根源 | 坚持使用数据库和统计模型这类顶尖专业者会用的工具;给它原始数据,请它反过来检查你的假设;找外部裁判,不让模型评自己 |
| 广度 | 除了任务表面上需要的那个领域,也找来其他领域,用上平常不会用的知识、工具和技巧 | 把名词换成动词,找出哪些领域派得上用场;替任务组一支跨领域的团队 |
他也替后三种野心各列了具体做法,有些还附上提示词。
文章最后,他用心理学的自我效能收尾,谈人会被自己相信的可能性框住。在那之前,他先交代了前提:他在文中谈的这些野心做法,都需要模型有一台能安装软件的电脑,也拿得到相关数据。他那段引导你把任务做得更深入的提问里,也有三项正好对应数据、工具和外部验证:最原始的材料是什么,该用哪些方法和工具,以及除了你我,还有什么能证明结果是对的。
电脑和数据是他明说的前提。至于外部验证,则是「深度」那一节里的一招,他特别强调要坚持。他也观察到,模型越强,似乎越能直接接下层次更高的目标;不过他也说,在 2026 年,光叫 Claude 去赚钱,对多数公司看来还行不通。从他的文章来看,用 AI 的野心有一部分得靠基础建设。开头那个让 app 不闪退的例子,本身就是一套验证管线。我想补上他没有展开的两件事:用别家模型当审查员时,外部验证要怎么搭;以及它为什么会改变人敢交办的范围。
AI 的外部裁判要怎么搭?
Felix 在「深度」那一节谈外部裁判,只写了几行:「Do not ask the model to judge itself」。他认为,最好用模型能自己执行、立刻取得反馈的工具来做外部验证。他的假设是,等模型更聪明,这件事终究会解决;但在 2026 年 10 月,他恳请读者务必坚持外部验证。Huang 等人 2023 年的研究用 GPT-3.5、GPT-4 等当时的模型测试,也发现没有外部反馈时,模型很难自行修正推理,有时改完反而更差。
这几个月来,我补上的另一种外部验证,是让别家的模型来审。它不像能直接执行的工具那样能立刻给反馈,独立性也有限,这点后面再谈。今年七月写美伊战争的分析时,我让 Grok 检索数据并整理成报告,再交给 Perplexity 重新整理,接着请 Claude 写成初稿。查核则另外交给一个 agent,只给它成品,要它把每个链接点开。它拿 Bruegel 的 PDF 和 OFAC 的公告比对,抓出初稿里的三个硬错。回头看,三个模型在把数据整理成报告或初稿时都出过错。至少在那次测试里,检索的质量比我原先预期的好。
我目前这一轮的配置是这样:
| 角色 | 由谁担任 | 防线 |
|---|---|---|
| 执行者 | Claude Code | 产出交给三家挑错 |
| 挑错员 | OpenAI 的 Codex | 只能读;每次查记录,确认实际跑的是哪个模型 |
| 挑错员 | xAI 的 Grok | 三层只读:工具清单、权限规则、沙盒 |
| 挑错员 | Google 的 Antigravity | 只能读;只跑 Google 自己的 Gemini |
| 研究员 | Perplexity | 查数据,附上原始出处,方便回头核对 |
| 拍板的人 | 我 | 重要的事实回到原始来源核对 |
这张分工表会随模型换代重新调整。这一轮看到的四种假象,我写在〈AI 审查报告最危险的地方,是它看起来查过了〉。这里先谈两个跟搭建有关的经验。
一开始在自己的 Mac 上设置 Grok 时,我限制它不能写文件。它被拒绝之后,改用 shell,试着从另一条路写入,最后被 macOS 的沙盒挡下来。后来我替 Grok 叠了三层只读限制:工具清单只开放读取类工具,权限规则封锁写入和命令行,最底层再由沙盒挡一次。一层被绕过,还有下一层。
Codex 则让我养成查记录的习惯。有一次设置没生效,它没有报错,只是默默改用默认模型,交出来的报告看起来一样仔细。从那之后,我每次都会回头查记录,确认它实际用的是哪个模型。
多找几个 AI 互审,为什么还不够?
审查员要独立,至少有两层意思。一层是不受产出者影响:给它的问题不能夹带我的结论,做法写在我让 codex 挑 Claude 的错,但不照它说了算;七月那次查核也定下一条,查核员不能先读产出者的推理过程,免得被同一套说法带着走。另一层是血统,也就是模型出自哪一家、用什么架构。找第二意见时,Antigravity 的模型清单里虽然也有 Claude,我只让它跑 Google 自己的 Gemini,免得变成 Claude 审 Claude。
这两层加起来,独立性仍然有限。Kim 等人 2025 年的研究分析了 350 多个模型在两个排行榜上的作答记录;在其中一个排行榜的题目上,两个模型都答错时,有六成给出同一个错误答案。同一家公司的模型,错误相关性更高,换家有道理;可是越大、越准的模型,就算来自不同公司、架构也不同,错误仍高度相关,只换家并不够。
这项研究测的是答题;论文也提到,这种相关性会影响拿模型当评审的结果。我的延伸是,模型互相核对时,也可能一起错过同一个错。七月那次能抓到错,靠的是查核员打开了 Bruegel 的 PDF 和 OFAC 的公告;回到原始来源,或用能执行的工具验证,这类一起犯的错才比较容易浮出来。这跟 Felix 说最好用工具,方向是一样的。
自我效能从哪里来?
Felix 在文章最后谈到自我效能,也提到有证据显示,自我效能可以刻意提升。他引用 Locke 和 Latham 回顾 35 年目标设定研究的结论:拿到具体又困难目标的人,表现比只被叫去尽力的人更好。
同一篇论文里,Locke 和 Latham 也写到,目标要有效,人需要反馈,知道自己离目标还有多远;不知道自己做得怎么样,就很难,甚至无法调整力气和方法。
我认为,放到人和 AI 的协作里,抓错的机制可以看成这种反馈。Felix 能把顾好不闪退这个结果交给 Claude,前提是重现和验证都接好了;我现在能放心让三家 AI 审查 Claude 的产出,是因为吃过亏之后,补上了只读限制和查记录的习惯,重要的事实也会回到原始来源核对。抓错的机制越可靠,人越敢把更大的事交给 AI。
这跟我三月写的知识管理不靠自律,靠管线接得上。不过七月做事实查核时,我发现那个结论只说对了一半:管线能搬数据、留来源,但要不要启动,最后还是得有人决定。野心也一样,抓错的机制搭得再好,最后拍板的还是人。我常说的超级个体,是一个人产出团队规模的成果;二月那篇谈的是调度和判断,现在回头看,还得加上这些一层层接起来的抓错机制。
绑在手腕上的翅膀
Felix 在文章开头用飞行比喻大家用 AI 的落差,配图也是一张飞行版画〈飞行的方法〉(Modo de volar),出自 Goya 晚年的 Disparates(荒唐)系列:五个人戴着鸟头形状的头盔,翅膀用带子绑在手腕和脚上。大都会博物馆的说明提到,这张画曾被看成一则隐喻,象征当时西班牙保守派反对的新政治与哲学思潮;也可以联想到当年马德里流行的热气球表演。
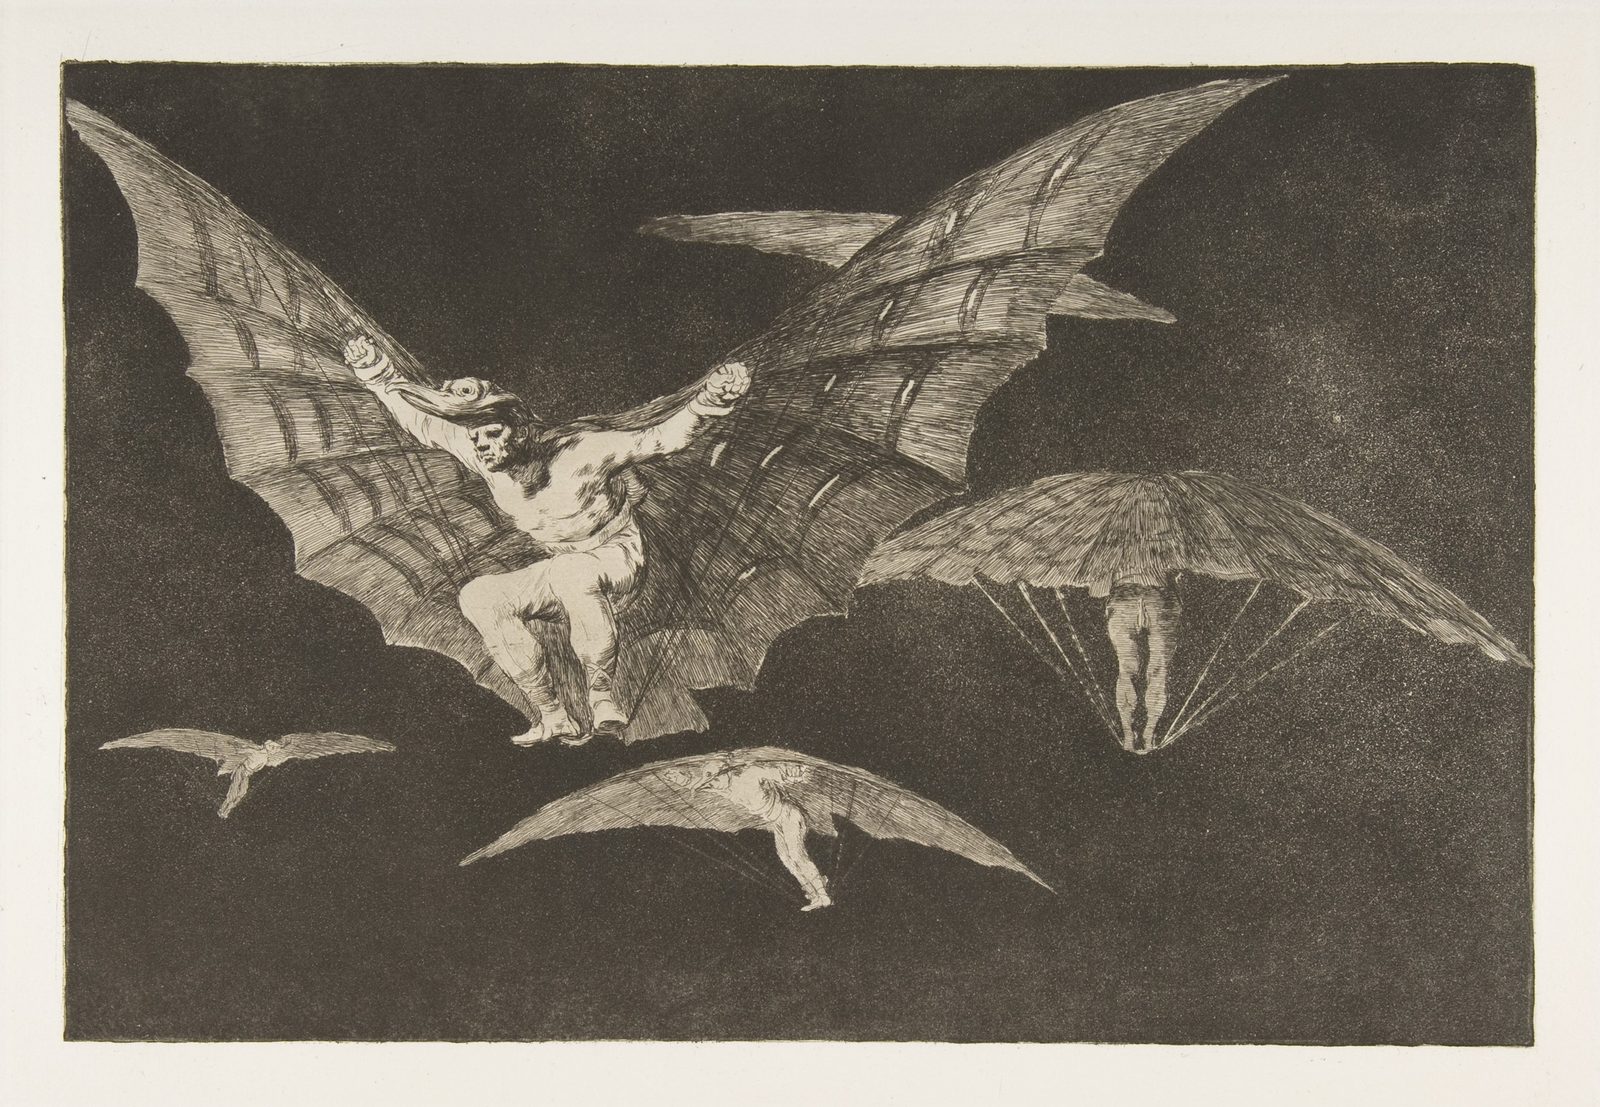 Goya〈飞行的方法〉(Modo de volar),约 1815–16 年作,1864 年出版。图片来源:大都会艺术博物馆,公有领域。
Goya 对这些人是期待还是嘲讽,我说不准。我留意的是,翅膀与身体之间,还有几条需要亲手系好的带子。
用 AI 也是这样。把工作交出去之后,我仍得知道,错了要去哪里查,偏了要怎么拉回来,最后的决定由谁承担。这些事每清楚一点,我就敢把原本不敢交办的事,再往前推一点。
所以,想用 AI 做更有野心的事,先看看,那些能够查证、修正、承担的带子,系好了没有。真正的勇气是长在这些细节里。知道自己如何回应可能的失误,才有余裕去想,还能飞往哪里。
也可以从 智能与秩序 主题页,看这个系列的其他文章。
💬 留言讨论
加载中...