TL;DR:Felix Rieseberg 寫的 AI 野心教學,已經說明模型需要一台能安裝軟體的電腦和相關資料,也特別強調要堅持外部驗證。這篇文章用我讓三家 AI 審查 Claude 的經驗,補上用別家模型當審查員時,外部驗證可以怎麼搭,以及它為什麼會改變人敢交辦的範圍。
Felix Rieseberg 是 Anthropic 的工程經理,至今負責過 Claude.ai、Cowork 和 Claude Code 桌面版的工程。10 月 13 日,他在個人網站發表〈How to be more ambitious: A tutorial for humans with models〉,分享了自己的一段經驗:他原本請 Claude 一次修一個閃退,後來乾脆交代 Claude,讓團隊的 app 保持不閃退。
要做到這一點,他先讓 Claude 能讀取閃退報告、查到版本和程式碼的對應關係,也給了它三種作業系統的電腦,讓它能自己重現問題、確認有沒有修好。
「用 AI 要更有野心」為什麼這麼難照做?
Felix 說,他和其他做 AI 的人常把「更有野心」掛在嘴邊,看到厲害的成果就轉貼,再補一句大家還不夠有野心。但他也明白,這個建議很難照做,所以把野心分成四種:
| 野心 | 意思 | Felix 舉的例子 |
|---|---|---|
| 速度 | 同樣的事,花更少時間做完 | 要寫程式,用 Claude 會寫得更快。他認為這種做法已經成熟,所以跳過不談 |
| 高度 | 把交辦的層次往上拉,從單一任務改成最後要的結果 | 他原本請 Claude 一次修一個閃退,後來直接交代它讓團隊的 app 保持不閃退 |
| 深度 | 像領域頂尖專家那樣做,直接碰原始資料、專業工具和問題的根源 | 堅持使用資料庫和統計模型這類頂尖專業者會用的工具;給它原始資料,請它反過來檢查你的假設;找外部裁判,不讓模型評自己 |
| 廣度 | 除了任務表面上需要的那個領域,也找來其他領域,用上平常不會用的知識、工具和技巧 | 把名詞換成動詞,找出哪些領域派得上用場;替任務組一支跨領域的團隊 |
他也替後三種野心各列了具體做法,有些還附上提示詞。
文章最後,他用心理學的自我效能收尾,談人會被自己相信的可能性框住。在那之前,他先交代了前提:他在文中談的這些野心做法,都需要模型有一台能安裝軟體的電腦,也拿得到相關資料。他那段引導你把任務做得更深入的提問裡,也有三項正好對應資料、工具和外部驗證:最原始的材料是什麼,該用哪些方法和工具,以及除了你我,還有什麼能證明結果是對的。
電腦和資料是他明說的前提。至於外部驗證,則是「深度」那一節裡的一招,他特別強調要堅持。他也觀察到,模型越強,似乎越能直接接下層次更高的目標;不過他也說,在 2026 年,光叫 Claude 去賺錢,對多數公司看來還行不通。從他的文章來看,用 AI 的野心有一部分得靠基礎建設。開頭那個讓 app 不閃退的例子,本身就是一套驗證管線。我想補上他沒有展開的兩件事:用別家模型當審查員時,外部驗證要怎麼搭;以及它為什麼會改變人敢交辦的範圍。
AI 的外部裁判要怎麼搭?
Felix 在「深度」那一節談外部裁判,只寫了幾行:「Do not ask the model to judge itself」。他認為,最好用模型能自己執行、立刻取得回饋的工具來做外部驗證。他的假設是,等模型更聰明,這件事終究會解決;但在 2026 年 10 月,他懇請讀者務必堅持外部驗證。Huang 等人 2023 年的研究用 GPT-3.5、GPT-4 等當時的模型測試,也發現沒有外部回饋時,模型很難自行修正推理,有時改完反而更差。
這幾個月來,我補上的另一種外部驗證,是讓別家的模型來審。它不像能直接執行的工具那樣能立刻給回饋,獨立性也有限,這點後面再談。今年七月寫美伊戰爭的分析時,我讓 Grok 檢索資料並整理成報告,再交給 Perplexity 重新整理,接著請 Claude 寫成初稿。查核則另外交給一個 agent,只給它成品,要它把每個連結點開。它拿 Bruegel 的 PDF 和 OFAC 的公告比對,抓出初稿裡的三個硬錯。回頭看,三個模型在把資料整理成報告或初稿時都出過錯。至少在那次測試裡,檢索的品質比我原先預期的好。
我目前這一輪的配置是這樣:
| 角色 | 由誰擔任 | 防線 |
|---|---|---|
| 執行者 | Claude Code | 產出交給三家挑錯 |
| 挑錯員 | OpenAI 的 Codex | 只能讀;每次查紀錄,確認實際跑的是哪個模型 |
| 挑錯員 | xAI 的 Grok | 三層唯讀:工具清單、權限規則、沙盒 |
| 挑錯員 | Google 的 Antigravity | 只能讀;只跑 Google 自己的 Gemini |
| 研究員 | Perplexity | 查資料,附上原始出處,方便回頭核對 |
| 拍板的人 | 我 | 重要的事實回到原始來源核對 |
這張分工表會隨模型換代重新調整。這一輪看到的四種假象,我寫在〈AI 審查報告最危險的地方,是它看起來查過了〉。這裡先談兩個跟搭建有關的經驗。
一開始在自己的 Mac 上設定 Grok 時,我限制它不能寫檔。它被拒絕之後,改用 shell,試著從另一條路寫入,最後被 macOS 的沙盒擋下來。後來我替 Grok 疊了三層唯讀限制:工具清單只開放讀取類工具,權限規則封鎖寫入和指令列,最底層再由沙盒擋一次。一層被繞過,還有下一層。
Codex 則讓我養成查紀錄的習慣。有一次設定沒生效,它沒有報錯,只是默默改用預設模型,交出來的報告看起來一樣仔細。從那之後,我每次都會回頭查紀錄,確認它實際用的是哪個模型。
多找幾個 AI 互審,為什麼還不夠?
審查員要獨立,至少有兩層意思。一層是不受產出者影響:給它的問題不能夾帶我的結論,做法寫在我讓 codex 挑 Claude 的錯,但不照它說了算;七月那次查核也定下一條,查核員不能先讀產出者的推理過程,免得被同一套說法帶著走。另一層是血統,也就是模型出自哪一家、用什麼架構。找第二意見時,Antigravity 的模型清單裡雖然也有 Claude,我只讓它跑 Google 自己的 Gemini,免得變成 Claude 審 Claude。
這兩層加起來,獨立性仍然有限。Kim 等人 2025 年的研究分析了 350 多個模型在兩個排行榜上的作答紀錄;在其中一個排行榜的題目上,兩個模型都答錯時,有六成給出同一個錯誤答案。同一家公司的模型,錯誤相關性更高,換家有道理;可是越大、越準的模型,就算來自不同公司、架構也不同,錯誤仍高度相關,只換家並不夠。
這項研究測的是答題;論文也提到,這種相關性會影響拿模型當評審的結果。我的延伸是,模型互相核對時,也可能一起錯過同一個錯。七月那次能抓到錯,靠的是查核員打開了 Bruegel 的 PDF 和 OFAC 的公告;回到原始來源,或用能執行的工具驗證,這類一起犯的錯才比較容易浮出來。這跟 Felix 說最好用工具,方向是一樣的。
自我效能從哪裡來?
Felix 在文章最後談到自我效能,也提到有證據顯示,自我效能可以刻意提升。他引用 Locke 和 Latham 回顧 35 年目標設定研究的結論:拿到具體又困難目標的人,表現比只被叫去盡力的人更好。
同一篇論文裡,Locke 和 Latham 也寫到,目標要有效,人需要回饋,知道自己離目標還有多遠;不知道自己做得怎麼樣,就很難,甚至無法調整力氣和方法。
我認為,放到人和 AI 的協作裡,抓錯的機制可以看成這種回饋。Felix 能把顧好不閃退這個結果交給 Claude,前提是重現和驗證都接好了;我現在能放心讓三家 AI 審查 Claude 的產出,是因為吃過虧之後,補上了唯讀限制和查紀錄的習慣,重要的事實也會回到原始來源核對。抓錯的機制越可靠,人越敢把更大的事交給 AI。
這跟我三月寫的知識管理不靠自律,靠管線接得上。不過七月做事實查核時,我發現那個結論只說對了一半:管線能搬資料、留來源,但要不要啟動,最後還是得有人決定。野心也一樣,抓錯的機制搭得再好,最後拍板的還是人。我常說的超級個體,是一個人產出團隊規模的成果;二月那篇談的是調度和判斷,現在回頭看,還得加上這些一層層接起來的抓錯機制。
綁在手腕上的翅膀
Felix 在文章開頭用飛行比喻大家用 AI 的落差,配圖也是一張飛行版畫〈飛行的方法〉(Modo de volar),出自 Goya 晚年的 Disparates(荒唐)系列:五個人戴著鳥頭形狀的頭盔,翅膀用帶子綁在手腕和腳上。大都會博物館的說明提到,這張畫曾被看成一則隱喻,象徵當時西班牙保守派反對的新政治與哲學思潮;也可以聯想到當年馬德里流行的熱氣球表演。
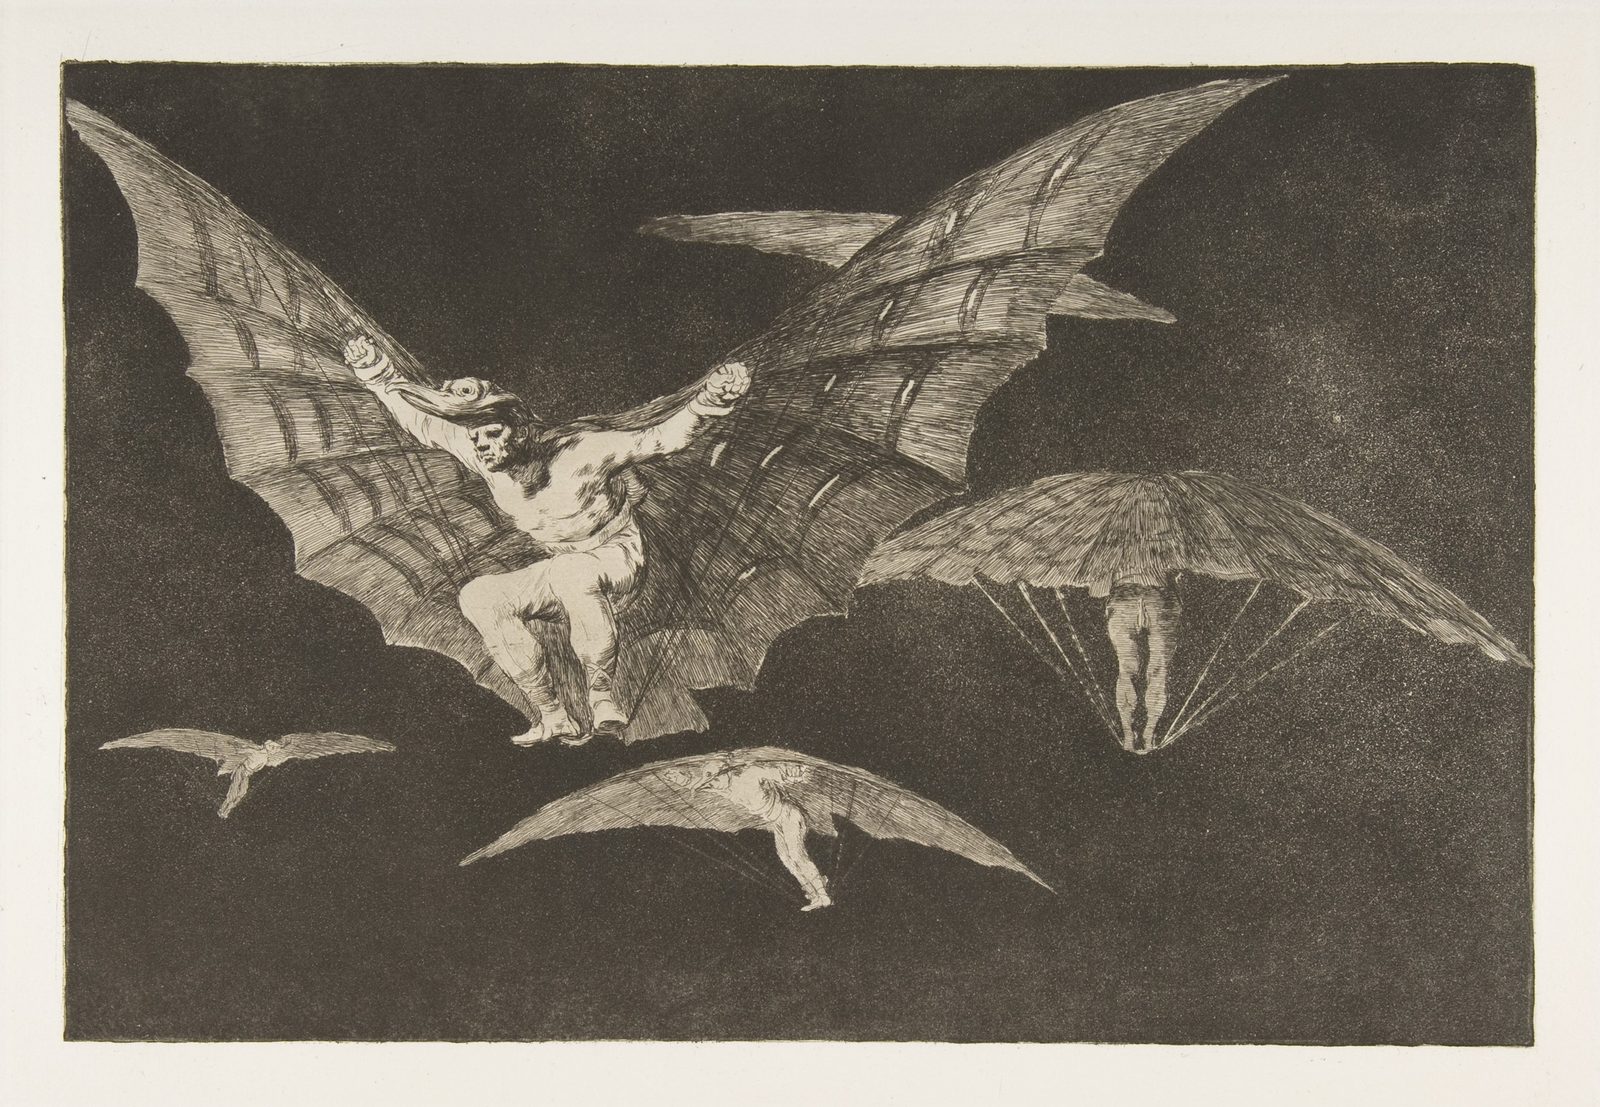 Goya〈飛行的方法〉(Modo de volar),約 1815–16 年作,1864 年出版。圖片來源:大都會藝術博物館,公有領域。
Goya 對這些人是期待還是嘲諷,我說不準。我留意的是,翅膀與身體之間,還有幾條需要親手繫好的帶子。
用 AI 也是這樣。把工作交出去之後,我仍得知道,錯了要去哪裡查,偏了要怎麼拉回來,最後的決定由誰承擔。這些事每清楚一點,我就敢把原本不敢交辦的事,再往前推一點。
所以,想用 AI 做更有野心的事,先看看,那些能夠查證、修正、承擔的帶子,繫好了沒有。真正的勇氣是長在這些細節裡。知道自己如何回應可能的失誤,才有餘裕去想,還能飛往哪裡。
也可以從 智能與秩序 主題頁,看這個系列的其他文章。
💬 留言討論
載入中...