这个计划将本人授权的 Fitbit/Google Health 数据收回本机,经过日期整理、缺值处理与白名单检查,再公开指定的日级摘要。AI 协助设计、实现与复核;日常数据整理与页面摘要由固定程序规则执行。
为什么把自己的生理数据做成网站?
很多年前,我读了《身体调校圣经》(The 4-Hour Body)。从那时起,我就对掌握自己的身体数据有一股热情。对我来说,“没有数据就无法管理”这个想法,也适用于健康维护。
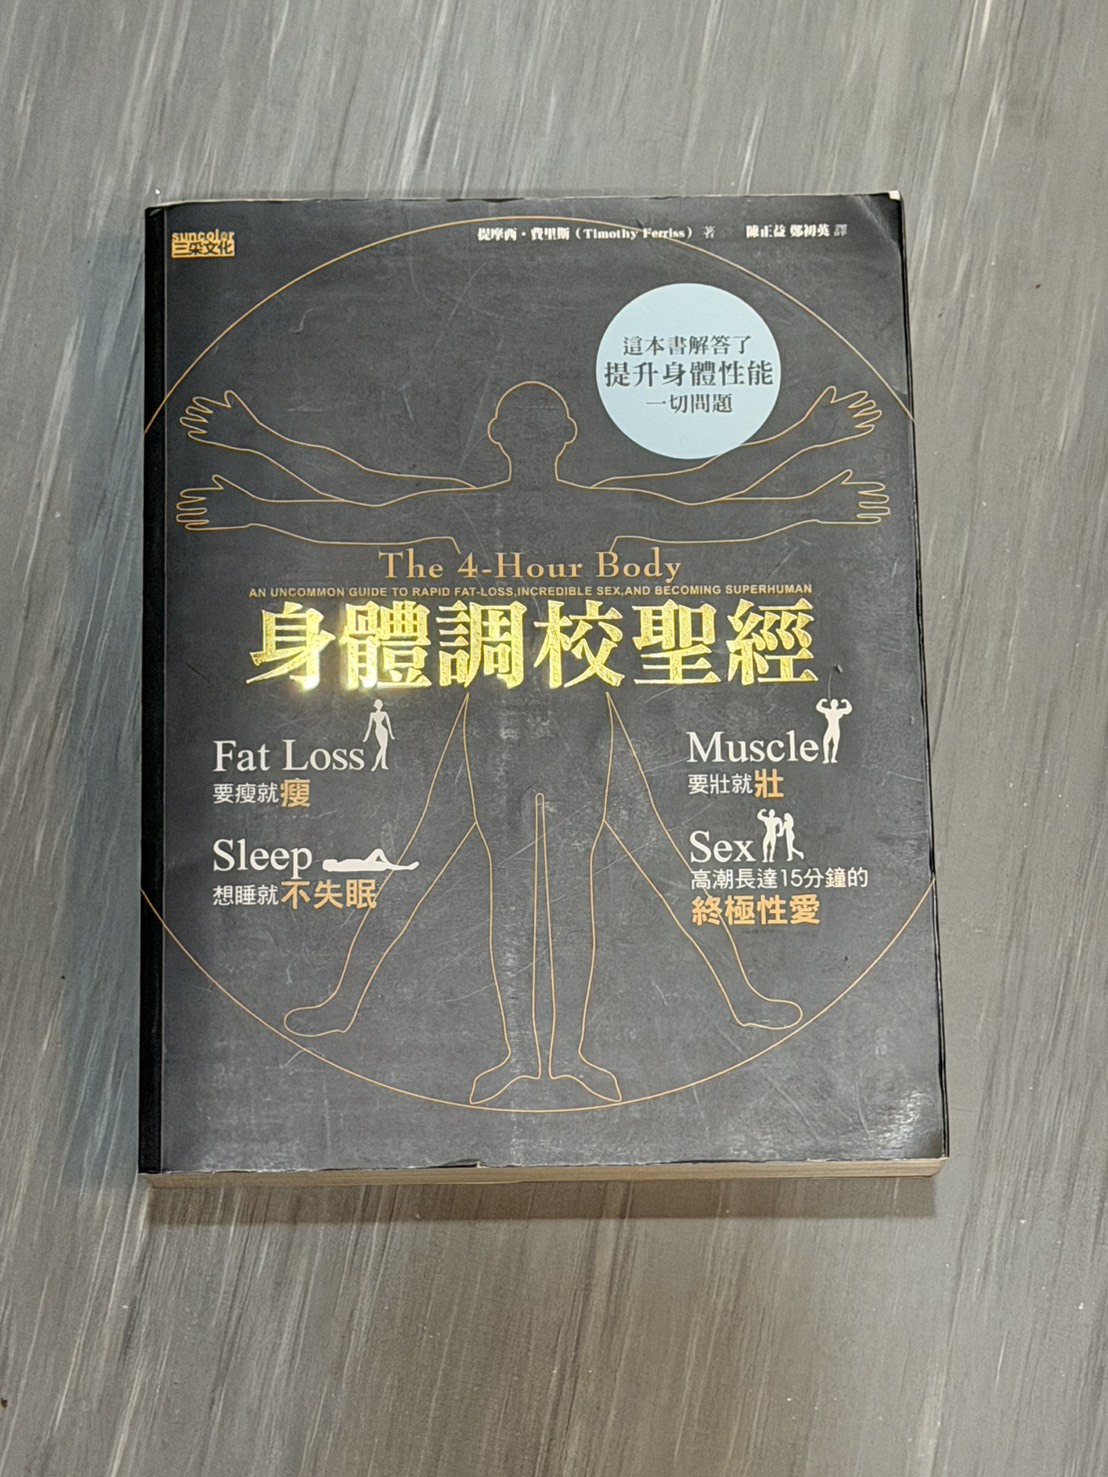
从《身体调校圣经》看数据管理
Tim Ferriss 在书中以自我实验探索饮食、训练与睡眠等议题。与这个网站最有关的,是其中几项测量与追踪观念。
- 先留下起点。 以身体围度、体脂等记录建立基准,别只盯着体重。原书测量章节
- 测量方法要一致。 工具、算法与条件的差异,可能被误认为身体变化。原书测量章节
- 让记录可以持续比较。 书后资源链接到量化自我与自我实验的方法,将日常习惯与身体记录纳入追踪。作者配套资源
- 用“最小有效剂量”思考。 MED 指足以产生目标结果的最小干预量,核心是找出真正有作用的调整。出版社节选
我把这些观念延伸成本站的做法:保留来源与日期,使用一致定义,让记录能长期回看。这是数据架构上的借鉴,不是把书中案例当成本站健康效果的证明。
现在有了 AI,当年的期待更有机会落实。我想把这份热情,逐步做成能持续记录、整理与回看的数据架构。
我把自己的活动、睡眠与部分生理记录放上网站,想介绍的是这套系统如何运作。
网站上的一个数字,背后需要回答几件事:数据从哪里来?是哪一天?是否仍在累积?没有记录时怎么显示?哪些内容可以公开?
这些问题决定了一张图表能不能被正确理解,也决定了自动化流程遇到错误时,会不会继续把不确定的结果送上网站。
本文记录的是 2026 年 10 月这一版:通过 Google Health API、本机 Python 与 SQLite、Cloudflare KV/Worker,以及网站界面,建立持续更新的日级生理日志。它与早期使用 Fitbit MCP、Apple Health 导出及部署脚本的探索,属于不同阶段的架构。这次的重点放在数据来源、公开边界与失败处理。
示意数据 · 非 Paul 实测
- 睡眠
- 心率变异性(HRV)
- 静息心率(RHR)
Google Health、Python 与网站怎么串起来?
整体流程分成采集、整理、发布与呈现四层。
flowchart TD
    A["Fitbit 设备与供应商同步"] --> B["Google Health API"]
    B -->|"本人授权的只读数据权限"| C["本机 Python 采集"]
    C --> D["私人 SQLite 与受限原始响应"]
    D --> E["日期整理、日级汇总、缺值与冲突处理"]
    T["本机 Takeout 一般历史"] --> E
    E --> F["批准公开白名单与 Node 验证"]
    F --> G["Cloudflare KV"]
    G --> H["Worker 只读端点"]
    H --> I["Astro/JavaScript 四语网站"]
    J["AI 协作:设计、程序、文案与复核"] -.-> C
    J -.-> I
图中的实线表示数据流;虚线表示搭建与维护协作,不是每次更新都把生理数据传给模型。Takeout 只用于一般历史指标,不参与 HRV、静息心率的个人参考带运算。
穿戴设备先把数据同步到供应商服务,本机程序再使用已授权的 Google Health 只读数据权限取得记录。程序核对账号与 Health identity,读取查询的所有分页,再将取得的数据写入本机数据库,原始 API 响应保存在受限目录。
这里的「只读」,指的是不写回 Google Health。本机数据整理与已授权的公开摘要发布,另有各自的写入流程。
数据定义也必须先确认。Google Health 区分日级、区间、单点等数据型别,并列出各型别所需权限;看起来相近的指标,不能直接当作相同数据使用。Google Health 数据型别
公开端由另一段程序建立摘要,只接受批准字段。通过 Node 白名单验证后,摘要写入既有 Cloudflare KV,由 Worker 提供读取,网站再呈现图表与说明。一般数据更新走 KV,不需要每次重新部署网站。
每五分钟检查,实际更新哪些数据?
目前的排程设计有两种频率。
窄屏幕可左右滚动表格。
| 流程 | 检查目标 | 更新范围 |
|---|---|---|
| 步行更新 | 每五分钟 | 今日与昨日的步数、距离日级累积值 |
| 完整日同步 | 台北时间每日 09:00 | 回查最近七天,成功后更新其余批准摘要与独立生理区块 |
睡眠、HRV 与静息心率,不会跟着五分钟步行流程重新计算。
两条流程共用锁,避免同时采集与覆写。目前由 Codex 的排程唤起本机固定 Python 程序,数据整理与摘要计算则依程序规则执行。Mac 与 Codex 必须运行,网络和上游同步也会影响实际执行时间。因此,五分钟代表检查目标;设备尚未同步时,增加查询也不会产生新的记录。
公开数据则分成三份契约,端点位于 api.paulkuo.tw:
窄屏幕可左右滚动表格。
| 端点 | 内容 |
|---|---|
/health-journal | 一般日级摘要,以及今日一个固定的平均心率 |
/health-journal/history | 七项一般指标的日级历史,不含平均心率 |
/health-journal/physiology | 最近七天的睡眠、每日 HRV、静息心率与个人参考带 |
七项一般指标包含步数、距离、活动热量、睡着时长、睡眠平均血氧、主要睡眠呼吸频率与皮肤温度偏差。
平均心率与静息心率是不同指标。今日平均心率采截至数据更新时已记录的数据计算,在当日第一次远端发布尝试前固定,同日重试沿用同一值,五分钟步行更新也不重新计算。它不代表完整 24 小时的平均;没有可用的已验证当日值时,就保留空白。静息心率则在另一份已批准的生理摘要中呈现七日记录。
一张图表,怎么保留数据的限制?
我希望读者看到数字时,也能看见它成立的条件。
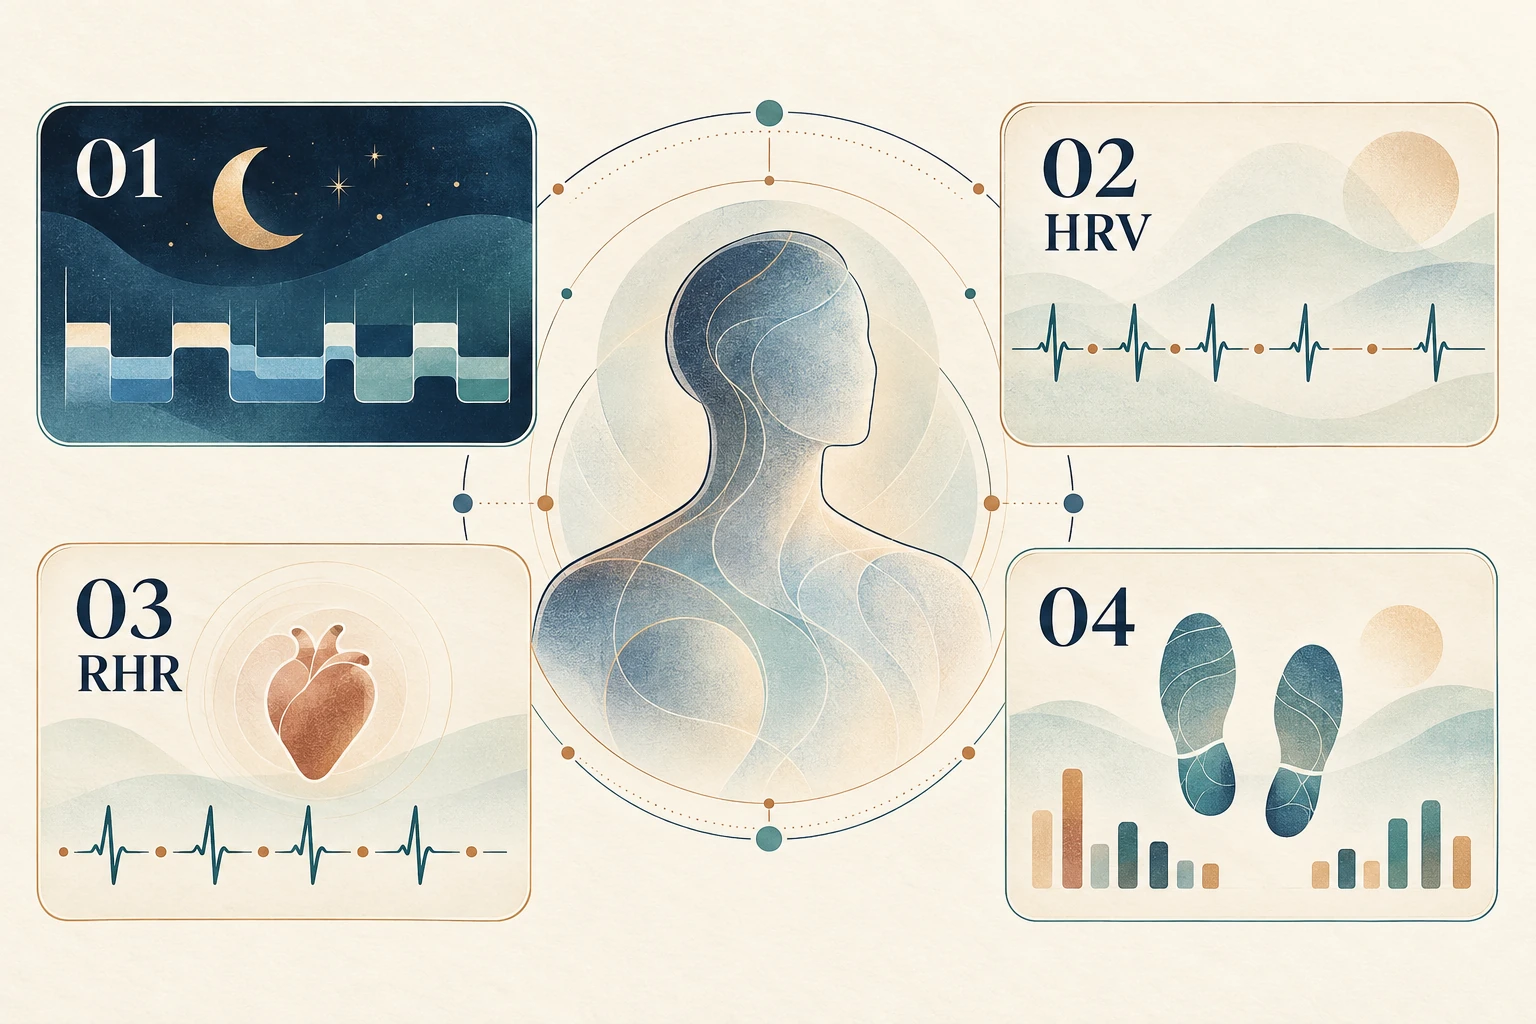
- 睡眠
- 心率变异性(HRV)
- 静息心率(RHR)
- 步行活动
步数与距离依台北日期汇整,今天仍在累积;睡眠归在醒来日,夜间指标保留供应商日期。睡眠在数据储存与 API 层保留分钟,界面则换成小时,让阅读比较直觉。
缺值维持空白或 null,不补成零;来源冲突也保留空白。旧数据保留原日期,不换上今天的标签。历史导出与近期 API 数据依来源规则整并,避免重复加总。
生理区块放在页面前方,用一句话、三项依据与七日图表,呈现睡眠、每日 HRV 与静息心率。HRV 使用每日平均 RMSSD 原值;静息心率使用包含睡眠数据的 WITH_SLEEP 定义。Google Health 数据点定义
个人参考带采用每个评估日前 28 天的同定义 API 数据,至少需要 21 个有效日,计算中位数及第 25 至 75 百分位。评估当天不算进去,也不混入未验证的 Takeout 数据。有效记录不足时,就显示「建立基准中」。
这个参考带描述近期记录的分布。落在带内不代表健康,落在带外也不能用来诊断。页面不估算剩余能量,也不据此判断运动安全。
HRV 与 RHR,怎么与生活经验对照?
HRV 看的是心跳间隔的变化。 它与自主神经对心跳的调节有关,不是每分钟跳几下。日常追踪的用途,是把自己的趋势与睡眠、压力及生活习惯放在一起看,而不是拿单次数值与别人排名。Google Health 的 HRV 说明
RHR 看的是休息时的心跳频率。 体温、情绪、疼痛与药物等因素,都可能影响心率;数值升高不会直接告诉我原因。美国心脏协会的心率说明
我自己有很明显的观察:只要喝酒,HRV 就往下掉;身体不舒服、没睡好或生病时,RHR 则会明显往上升。这是我在自己记录中看到的现象,不代表每个人都会有相同反应。
我的身体小剧场
示意数据,非 Paul 实测
HRV · 对照示意喝酒后的 HRV
间隔的差异变小
RHR · 对照示意没睡好・不舒服时的 RHR
节奏变快
这样的观察也有研究可对照。一项 2026 年、由 WHOOP 资助的穿戴设备回顾性研究,观察到饮酒与夜间 HRV 降低、夜间 RHR 升高有关。这是观察性关联,不能替我某一次的变化确定原因。原始研究
对我来说,这两项数据的价值,是让生活经验多一份可以回看的记录。同一定义、相近测量条件与自己的长期趋势,比追逐单日高低更值得关注。身体的感受与症状,也不能被图表上的数值取代。
AI 在这个计划中做了什么?
我的角色是提出需求、决定公开范围与确认成果。AI 协助拆解数据流程、撰写程序、整理四语文案,并检查日期、缺值与公开字段等规则。独立复核则用来找出原先说明或实现中容易忽略的问题。
目前页面上的一句话摘要,由预先写好的文案与固定判断规则产生。每次更新,不需要把整批生理原始记录交给模型重新解读。
这让数据来源、计算规则与画面结果可以逐一对照,也比较容易重现错误。是否完成,仍须看程序检查与实际读回结果。
数据边界也需要说清楚。在这套管线中,下载的原始 API 响应与本机凭据档保存在受限本机路径,公开层只接收批准摘要。Google/Fitbit 上游仍持有来源数据;Codex 协作中的提示、程序片段与工具输出,则可能进入 AI 服务处理。本机执行不等于整个过程完全离线。
这份成果也让我看见,与 AI 协作时,需求本身需要写得足够具体。「把数据接起来」之外,还必须定义哪些值能公开、失败时停在哪里,以及用什么证据确认完成。这也是我在智能与秩序这个主题里持续关注的人机协作问题。
成果,要连失败时的行为一起看
这套系统已把私人采集、日级摘要与网站呈现接起来,也把发布条件写进程序。查询不完整时,不进入新的摘要发布流程。
步行与独立生理区块在上传结果不明时,会保留固定候选,先读回验证,再决定是否重试。一般日级摘要则固定当日平均心率,发布后核对公开内容。
目前一般摘要的 current 与 history 分别写入两个 KV key,不能宣称原子更新;部分上传成功时,两者可能短暂不同版。这是需要如实交代的工程限制。
发布后的验证会读回公开端点,比对内容哈希与 no-store 响应标头。这是在确认读回内容与 HTTP 缓存政策,不代表全球所有地点同时取得新值。Cloudflare KV 采最终一致性,不同地点仍可能有传播延迟。Cloudflare KV 一致性说明
目前可以确认的成果,是数据流程与呈现方式已经建立,公开范围有明确限制,错误也有停止、验证与通知机制。这些工程成果,不能延伸成健康改善、诊断准确度或节省工时的证明。
我想让这份生理日志上的每个数字,都能回答同一个问题:它怎么来,又有哪些事情还不知道?
💬 留言讨论
加载中...