這個計畫將本人授權的 Fitbit/Google Health 資料收回本機,經過日期整理、缺值處理與白名單檢查,再公開指定的日級摘要。AI 協助設計、實作與複核;日常資料整理與頁面摘要由固定程式規則執行。
為什麼把自己的生理資料做成網站?
很多年前,我讀了《身體調校聖經》(The 4-Hour Body)。從那時起,我就對掌握自己的身體資料有一股熱情。對我來說,「沒有數據就無法管理」這個想法,也適用於健康維護。
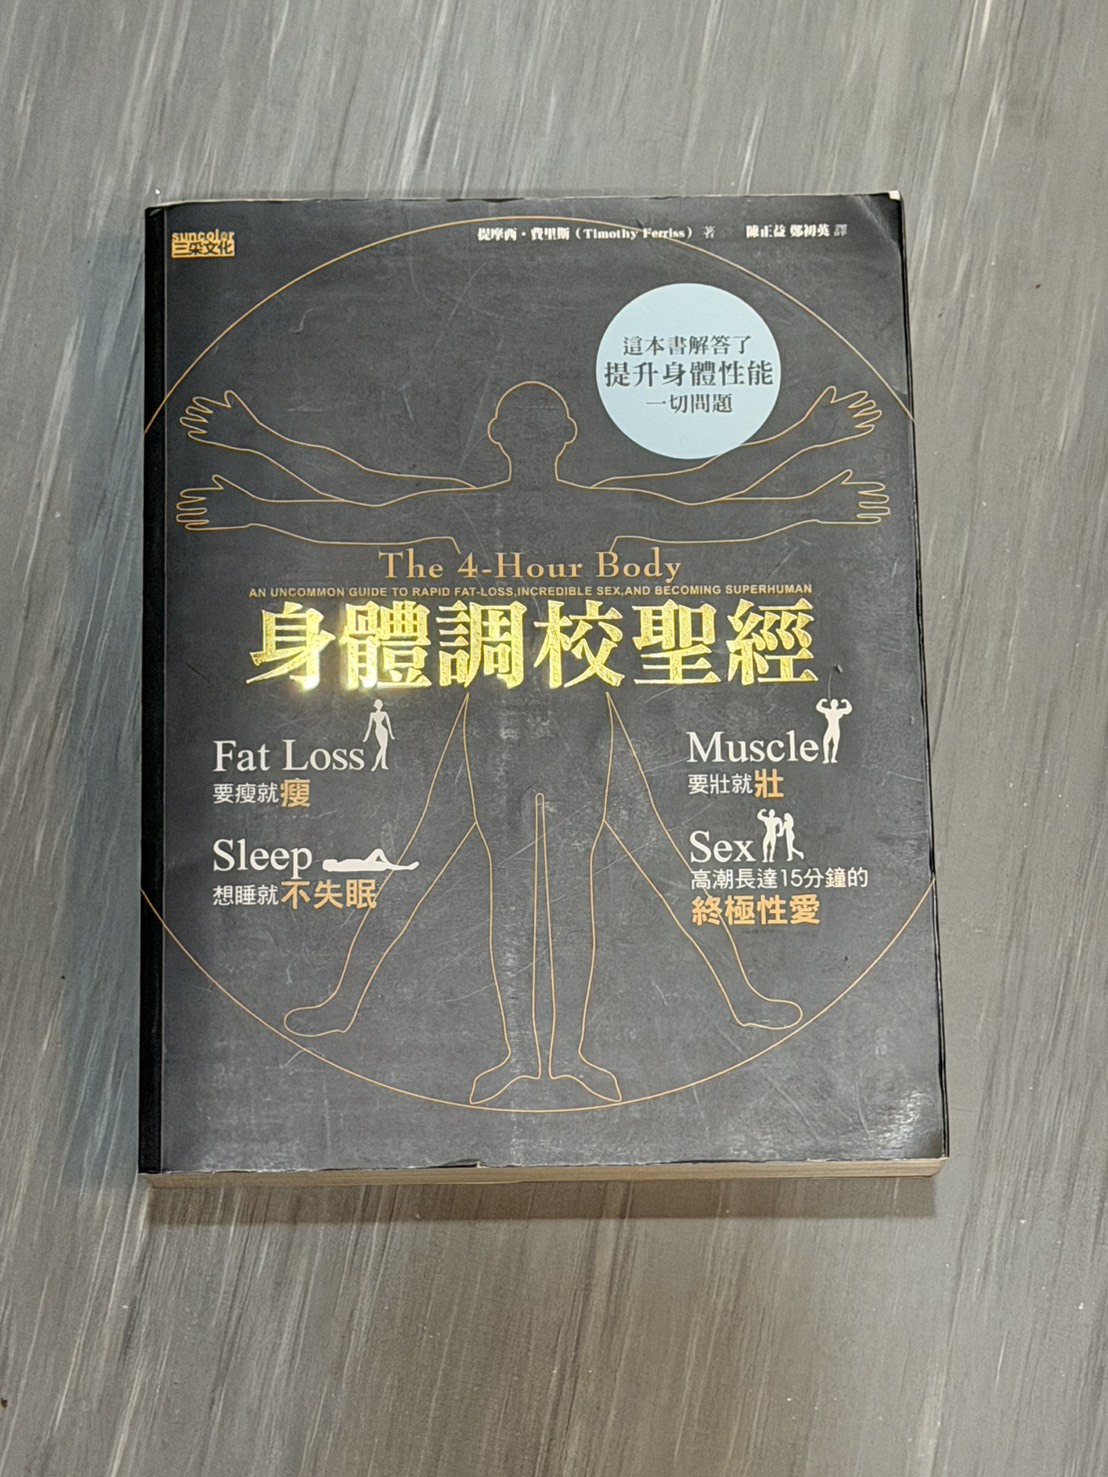
從《身體調校聖經》看資料管理
Tim Ferriss 在書中以自我實驗探索飲食、訓練與睡眠等議題。與這個網站最有關的,是其中幾項量測與追蹤觀念。
- 先留下起點。 以體圍、體脂等紀錄建立基準,別只盯著體重。原書量測章節
- 量測方法要一致。 工具、算法與條件的差異,可能被誤認為身體變化。原書量測章節
- 讓紀錄可以持續比較。 書後資源連到量化自我與自我實驗的方法,將日常習慣與身體紀錄納入追蹤。作者配套資源
- 用「最小有效劑量」思考。 MED 指足以產生目標結果的最小介入量,核心是找出真正有作用的調整。出版社節錄
我把這些觀念延伸成本站的做法:保留來源與日期,使用一致定義,讓紀錄能長期回看。這是資料架構上的借鏡,不是把書中案例當成本站健康成效的證明。
現在有了 AI,當年的期待更有機會落實。我想把這份熱情,逐步做成能持續記錄、整理與回看的資料架構。
我把自己的活動、睡眠與部分生理紀錄放上網站,想介紹的是這套系統如何運作。
網站上的一個數字,背後需要回答幾件事:資料從哪裡來?是哪一天?是否仍在累積?沒有紀錄時怎麼顯示?哪些內容可以公開?
這些問題決定了一張圖表能不能被正確理解,也決定了自動化流程遇到錯誤時,會不會繼續把不確定的結果送上網站。
本文記錄的是 2026 年 10 月這一版:透過 Google Health API、本機 Python 與 SQLite、Cloudflare KV/Worker,以及網站介面,建立持續更新的日級生理日誌。它與早期使用 Fitbit MCP、Apple Health 匯出及部署腳本的探索,屬於不同階段的架構。這次的重點放在資料來源、公開邊界與失敗處理。
示意資料 · 非 Paul 實測
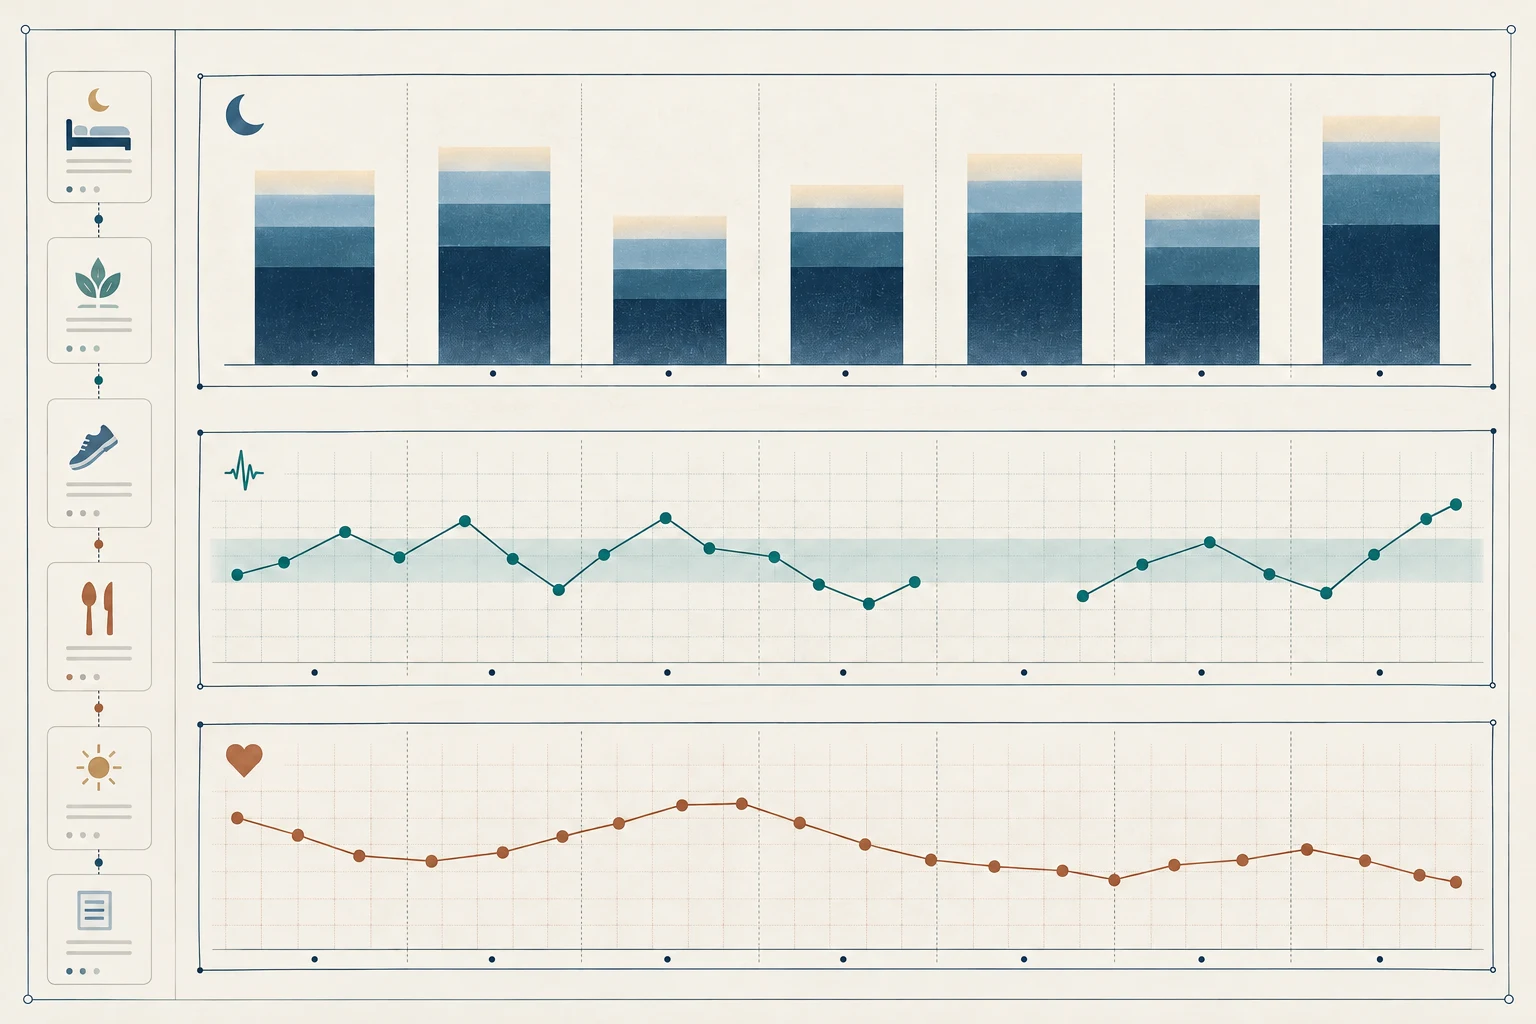
- 睡眠
- 心率變異度(HRV)
- 靜息心率(RHR)
Google Health、Python 與網站怎麼串起來?
整體流程分成採集、整理、發布與呈現四層。
flowchart TD
    A["Fitbit 裝置與供應商同步"] --> B["Google Health API"]
    B -->|"本人授權的唯讀資料權限"| C["本機 Python 採集"]
    C --> D["私人 SQLite 與受限原始回應"]
    D --> E["日期整理、日級彙總、缺值與衝突處理"]
    T["本機 Takeout 一般歷史"] --> E
    E --> F["核准公開白名單與 Node 驗證"]
    F --> G["Cloudflare KV"]
    G --> H["Worker 只讀端點"]
    H --> I["Astro/JavaScript 四語網站"]
    J["AI 協作:設計、程式、文案與複核"] -.-> C
    J -.-> I
圖中的實線表示資料流;虛線表示建置與維護協作,不是每次更新都把生理資料傳給模型。Takeout 只用於一般歷史指標,不參與 HRV、靜息心率的個人參考帶運算。
穿戴裝置先把資料同步到供應商服務,本機程式再使用已授權的 Google Health 唯讀資料權限取得紀錄。程式核對帳號與 Health identity,讀取查詢的所有分頁,再將取得的資料寫入本機資料庫,原始 API 回應保存在受限目錄。
這裡的「唯讀」,指的是不寫回 Google Health。本機資料整理與已授權的公開摘要發布,另有各自的寫入流程。
資料定義也必須先確認。Google Health 區分日級、區間、單點等資料型別,並列出各型別所需權限;看起來相近的指標,不能直接當作相同資料使用。Google Health 資料型別
公開端由另一段程式建立摘要,只接受核准欄位。通過 Node 白名單驗證後,摘要寫入既有 Cloudflare KV,由 Worker 提供讀取,網站再呈現圖表與說明。一般資料更新走 KV,不需要每次重新部署網站。
每五分鐘檢查,實際更新哪些資料?
目前的排程設計有兩種頻率。
窄螢幕可左右捲動表格。
| 流程 | 檢查目標 | 更新範圍 |
|---|---|---|
| 步行更新 | 每五分鐘 | 今日與昨日的步數、距離日級累積值 |
| 完整日同步 | 台北時間每日 09:00 | 回查最近七天,成功後更新其餘核准摘要與獨立生理區塊 |
睡眠、HRV 與靜息心率,不會跟著五分鐘步行流程重新計算。
兩條流程共用鎖,避免同時採集與覆寫。目前由 Codex 的排程喚起本機固定 Python 程式,資料整理與摘要計算則依程式規則執行。Mac 與 Codex 必須運行,網路和上游同步也會影響實際執行時間。因此,五分鐘代表檢查目標;裝置尚未同步時,增加查詢也不會產生新的紀錄。
公開資料則分成三份契約,端點位於 api.paulkuo.tw:
窄螢幕可左右捲動表格。
| 端點 | 內容 |
|---|---|
/health-journal | 一般日級摘要,以及今日一個固定的平均心率 |
/health-journal/history | 七項一般指標的日級歷史,不含平均心率 |
/health-journal/physiology | 最近七天的睡眠、每日 HRV、靜息心率與個人參考帶 |
七項一般指標包含步數、距離、活動熱量、睡著時長、睡眠平均血氧、主要睡眠呼吸頻率與皮膚溫度偏差。
平均心率與靜息心率是不同指標。今日平均心率採截至資料更新時已記錄的資料計算,在當日第一次遠端發布嘗試前固定,同日重試沿用同一值,五分鐘步行更新也不重新計算。它不代表完整 24 小時的平均;沒有可用的已驗證當日值時,就保留空白。靜息心率則在另一份已核准的生理摘要中呈現七日紀錄。
一張圖表,怎麼保留資料的限制?
我希望讀者看到數字時,也能看見它成立的條件。
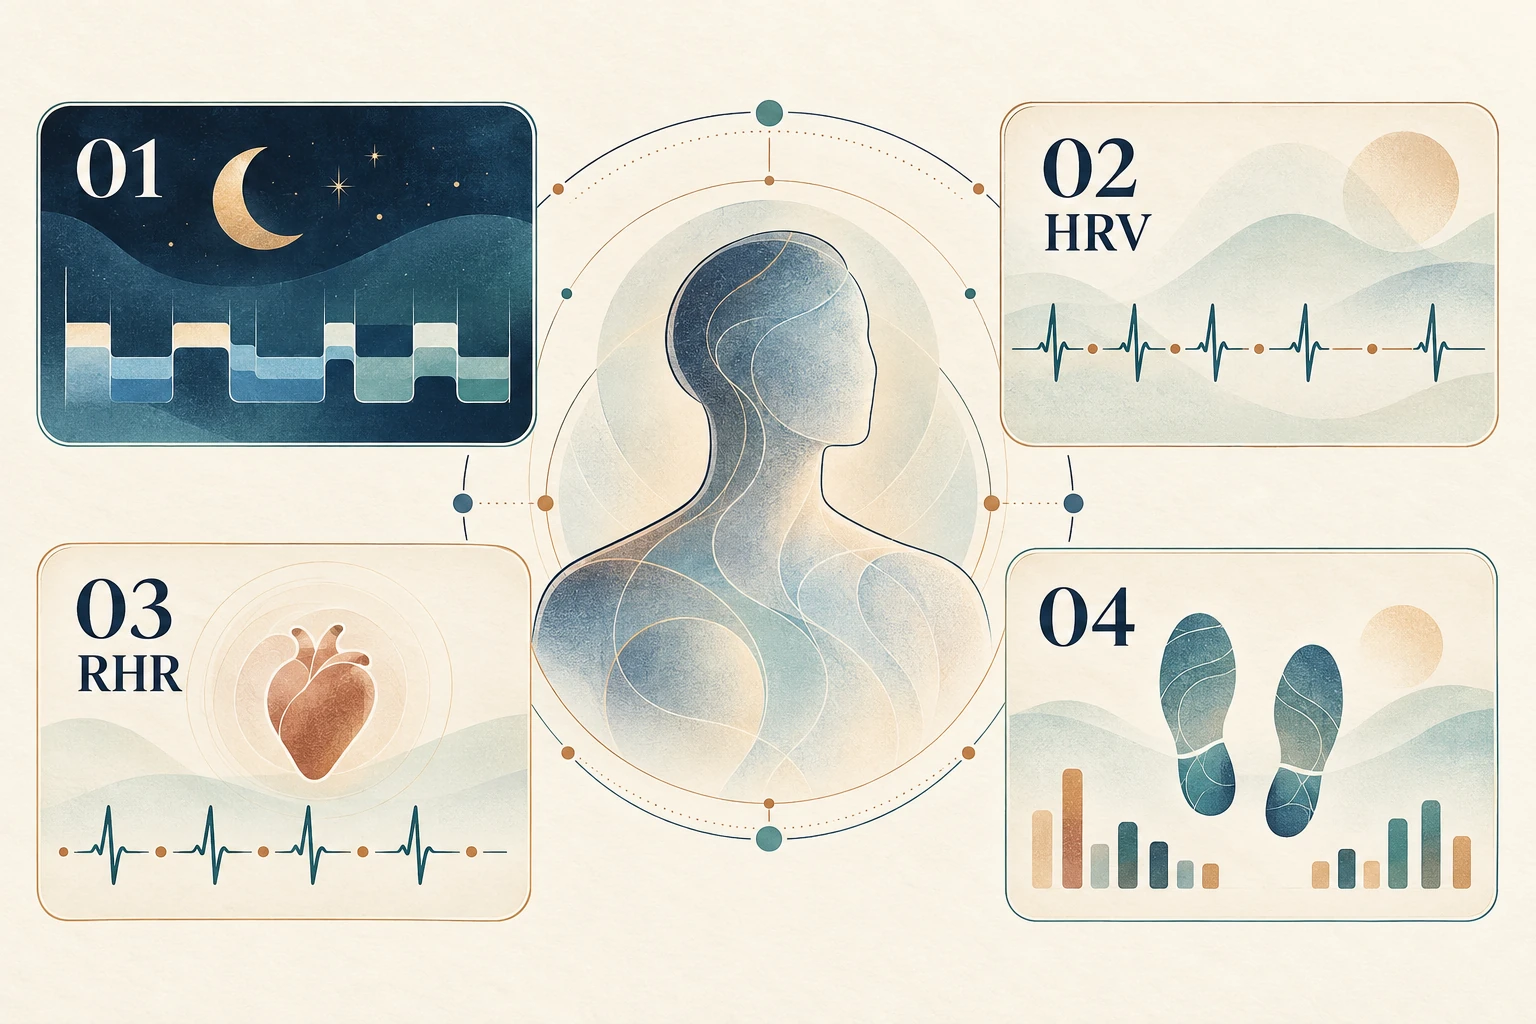
- 睡眠
- 心率變異度(HRV)
- 靜息心率(RHR)
- 步行活動
步數與距離依台北日期彙整,今天仍在累積;睡眠歸在醒來日,夜間指標保留供應商日期。睡眠在資料儲存與 API 層保留分鐘,介面則換成小時,讓閱讀比較直覺。
缺值維持空白或 null,不補成零;來源衝突也保留空白。舊資料保留原日期,不換上今天的標籤。歷史匯出與近期 API 資料依來源規則整併,避免重複加總。
生理區塊放在頁面前方,用一句話、三項依據與七日圖表,呈現睡眠、每日 HRV 與靜息心率。HRV 使用每日平均 RMSSD 原值;靜息心率使用包含睡眠資料的 WITH_SLEEP 定義。Google Health 資料點定義
個人參考帶採每個評估日前 28 天的同定義 API 資料,至少需要 21 個有效日,計算中位數及第 25 至 75 百分位。評估當天不算進去,也不混入未驗證的 Takeout 資料。有效紀錄不足時,就顯示「建立基準中」。
這個參考帶描述近期紀錄的分布。落在帶內不代表健康,落在帶外也不能用來診斷。頁面不估算剩餘能量,也不據此判斷運動安全。
HRV 與 RHR,怎麼與生活經驗對照?
HRV 看的是心跳間隔的變化。 它與自律神經對心跳的調節有關,不是每分鐘跳幾下。日常追蹤的用途,是把自己的趨勢與睡眠、壓力及生活習慣放在一起看,而不是拿單次數字與別人排名。Google Health 的 HRV 說明
RHR 看的是休息時的心跳頻率。 體溫、情緒、疼痛與藥物等因素,都可能影響心率;讀值升高不會直接告訴我原因。美國心臟協會的心率說明
我自己有很明顯的觀察:只要喝酒,HRV 就往下掉;身體不舒服、沒睡好或生病時,RHR 則會明顯往上升。這是我在自己紀錄中看到的現象,不代表每個人都會有相同反應。
我的身體小劇場
示意資料,非 Paul 實測
HRV · 對照示意喝酒後的 HRV
間隔的差異變小
RHR · 對照示意沒睡好・不舒服時的 RHR
節奏變快
這樣的觀察也有研究可對照。一項 2026 年、由 WHOOP 資助的穿戴裝置回溯研究,觀察到飲酒與夜間 HRV 降低、夜間 RHR 升高有關。這是觀察性關聯,不能替我某一次的變化確定原因。原始研究
對我來說,這兩項資料的價值,是讓生活經驗多一份可以回看的紀錄。同一定義、相近量測條件與自己的長期趨勢,比追逐單日高低更值得關注。身體的感受與症狀,也不能被圖表上的數字取代。
AI 在這個計畫中做了什麼?
我的角色是提出需求、決定公開範圍與確認成果。AI 協助拆解資料流程、撰寫程式、整理四語文案,並檢查日期、缺值與公開欄位等規則。獨立複核則用來找出原先說明或實作中容易忽略的問題。
目前頁面上的一句話摘要,由預先寫好的文案與固定判斷規則產生。每次更新,不需要把整批生理原始紀錄交給模型重新解讀。
這讓資料來源、計算規則與畫面結果可以逐一對照,也比較容易重現錯誤。是否完成,仍須看程式檢查與實際讀回結果。
資料邊界也需要說清楚。在這套管線中,下載的原始 API 回應與本機憑證檔保存在受限本機路徑,公開層只接收核准摘要。Google/Fitbit 上游仍持有來源資料;Codex 協作中的提示、程式片段與工具輸出,則可能進入 AI 服務處理。本機執行不等於整個過程完全離線。
這份成果也讓我看見,與 AI 協作時,需求本身需要寫得足夠具體。「把資料接起來」之外,還必須定義哪些值能公開、失敗時停在哪裡,以及用什麼證據確認完成。這也是我在智能與秩序這個主題裡持續關注的人機協作問題。
成果,要連失敗時的行為一起看
這套系統已把私人採集、日級摘要與網站呈現接起來,也把發布條件寫進程式。查詢不完整時,不進入新的摘要發布流程。
步行與獨立生理區塊在上傳結果不明時,會保留固定候選,先讀回驗證,再決定是否重試。一般日級摘要則固定當日平均心率,發布後核對公開內容。
目前一般摘要的 current 與 history 分別寫入兩個 KV key,不能宣稱原子更新;部分上傳成功時,兩者可能短暫不同版。這是需要如實交代的工程限制。
發布後的驗證會讀回公開端點,比對內容雜湊與 no-store 回應標頭。這是在確認讀回內容與 HTTP 快取政策,不代表全球所有地點同時取得新值。Cloudflare KV 採最終一致性,不同地點仍可能有傳播延遲。Cloudflare KV 一致性說明
目前可以確認的成果,是資料流程與呈現方式已經建立,公開範圍有明確限制,錯誤也有停止、驗證與通知機制。這些工程成果,不能延伸成健康改善、診斷準確度或節省工時的證明。
我想讓這份生理日誌上的每個數字,都能回答同一個問題:它怎麼來,又有哪些事情還不知道?
💬 留言討論
載入中...