10月1日、GoogleがGemini 4 Argonを発表した。Demis HassabisがX上に比較表を投稿し、Argonの列の大半が青く塗られている。青はその項目で首位を意味する。その日たまたまこのニュースを目にした人は、こんな考えが頭をよぎったかもしれない。毎日AIでメールを書いたりスライドを作ったりしているが、乗り換えるべきだろうか。
私はAIモデルを追跡する /ai/models というページを自分で管理し、いくつかのフロンティアモデルの実力を比較している。その日の朝の定期更新でArgonを見落としており、後でGeminiの最新動向を確認して初めて気づき、同日中に追記した。追記したのは説明文だけで、比較カードには載せなかった。
「複数項目で首位」を名乗る新モデルが、私のページに数行しか書かれていないのはなぜか。その判断の背後には、誰にでも使える三つの問いがある。
新しいAIモデルの発表を見たら、まず何を問うべきか
「今すぐ使えるか?」「このスコアは誰が計ったか?」「モデルが変わったとき・間違えたとき、自分で気づけるか?」
三つとも地味に聞こえるが、新モデルの発表情報はこれらにほとんど答えてくれない。以下、Argonで一問ずつ確かめていく。
第一問:Gemini 4 Argon、今すぐ使えるか?
使えない。GoogleのブログによるとArgonは現在、Fairwindプログラムのメンバー(つまり政府機関と信頼されたサイバー防御側の組織)にのみ公開されており、彼らが受け取るのはセキュリティの制限を外したバージョンだ。次に一般に開放されるバージョンが同じものかどうか、手元の資料には書かれていない。次のバッチは有料APIクライアントとGoogle AI Ultraサブスクライバーとされているが、時期は未公表。一般ユーザーへの提供がいつになるかは、記事の中に書かれていない。
10月1日の比較表がどれだけ鮮やかでも、大半のユーザーにとってはまだ予告編にすぎない。Argonにおいて、発表日と利用可能日はすでに別の日付になっている。
第二問:新モデルのスコアは誰が計ったか?
まずHassabisが投稿した比較表を見てみよう。
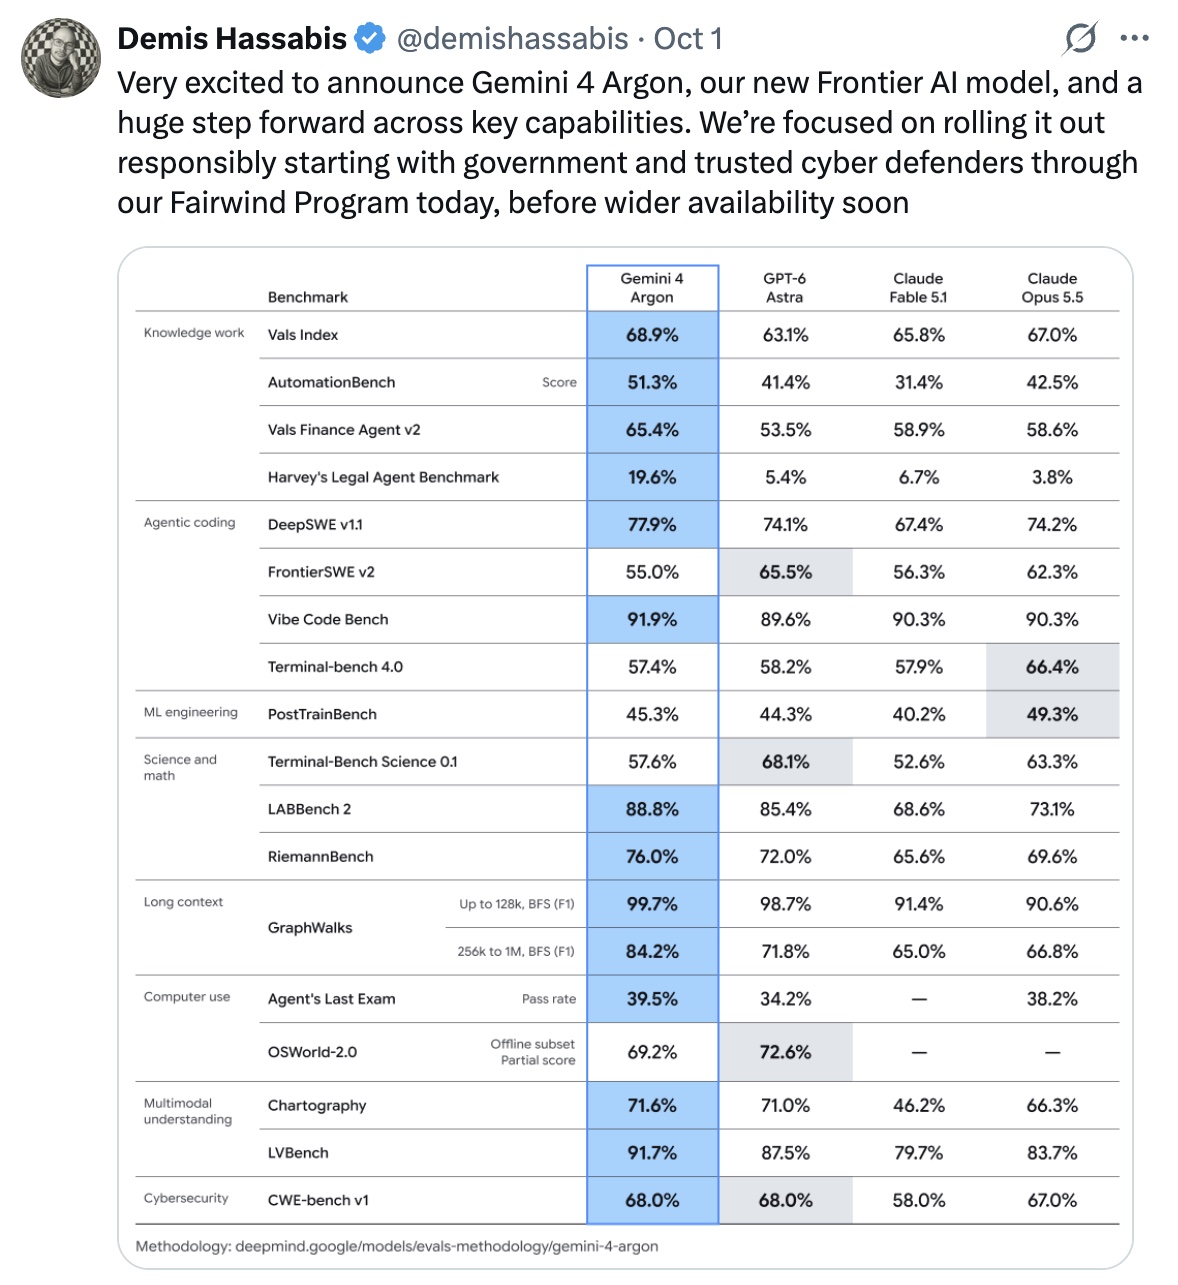 Demis HassabisのX投稿スクリーンショット(2026-10-01)。表はGoogle提供。
この表は少し立ち止まって見る価値がある。青地がArgon首位、灰地が他社首位だ。19行のうち5行は他社が勝っており、セキュリティの行は同点だ。ベンダー自身が項目を選んでレイアウトした表でも、Argonは全勝ではない。
一行、突き合わせてみる。表にはArgonがDeepSWE(AIのコーディング能力を測るベンチマーク)で77.9%を獲得し、2位を約4ポイント上回ると書かれている。DeepSWEには公開の成績データファイルがある。表のこの行にある四つの数字を照合したところ、確認できたのはGPT-6 Astraの74.1%だけだった。Argonは掲載されておらず、表に記載のFable 5.1とOpus 5.5も見当たらない。データファイルは9月22日に生成されており、発表より前だ。掲載されていないこと自体は不思議ではないが、この行の四つの数字のうち三つには、現時点で照合できる公開データが存在しないことになる。
同じモデルを第三者のArtificial Analysis(AA)が独自の手法で計測すると、別の絵が出てくる。AAの総合指数(パーセンテージではなく指数)では、Argonは53を記録し、Fable 5.1・GPT-6 Astraと同点。Opus 5.5は58だ。Argonが実際に際立っているのは幻覚率(つまり自信満々に事実をでっち上げるかどうか)で、約15%と他の三つのフロンティアモデルより明らかに低い。
メールやスライドを作る人にとって、これはどんなコーディングスコアより重要だ。報告書で数字が一つ間違っていたり、メールに存在しない出典が書かれていたりすれば、恥をかくのはあなたであってAIではない。ツールを選ぶとき、自分が最も恐れるエラーの種類を明確にし、それを計測している数字を探す方が、総合ランキングを見るより意味がある。
第三問:モデルが切り替わったとき・間違えたとき、自分で気づけるか?
9月28日、自分のコーディング用AIツールで一つ確認した。普段呼んでいるモデルの名前が、実際にはどのバージョンを指しているか。答えはすでに新しいOpus 5.5に切り替わっていた。名前は変わらず、中身が変わり、事前の告知はなかった。
私にとってこれは小さな話ではない。この半年でモデルの進化が速すぎて、私のワークフローはほぼモデルの変化と連動して設計している。どのモデルを使うかは、ワークフローの設計にも、プロンプトの書き方にも影響する。モデルが切り替わればフローとプロンプトの見直しが必要になる。だから「今動いているのはどれか」は把握しておかなければならない。
これはオフィスワーカーにとっても同じ構造だ。使い慣れた聞き方、スライドのアウトラインを作るときのプロンプトは、特定のモデルで試行錯誤して覚えたものだ。裏のモデルが切り替わると結果が良くなることもあれば、それまで手になじんでいた使い方が思わぬ変化を見せることもある。ツールにモデル名が表示されているなら、回答が「何か変だ」と感じたとき、プロンプトを疑う前にまずモデルを確認してみるといい。
モデルが変わるより実際的なのは、間違えたときにどう気づくかだ。モデルの新旧やランキングを問わず、メールやスライドに含まれる確認可能な情報(数字や出典)は、送る前に自分で調べる。幻覚率の低いモデルでもでっち上げはある、ただ頻度が低いだけだ。
Argon発表後、自分も乗り換えを検討するか確認した。私は普段、GoogleのAIツールにセカンドレビューをさせているが、調べてみると選択可能なモデルの一覧にArgonはそもそも存在しない。乗り換えようにも乗り換えられない。仮にいつか表示されたとしても、自分の業務でまず試してから判断する。幻覺率が低いという話は魅力的だが、でっち上げを減らすことと、問題を見抜いてくれることは別の話だ。
私のモデルページはどう掲載を判断するか
私のモデルページにはいくつかの掲載基準があり、要約すると上の三問を固定フローにしたものだ。
一つ目は「使えるか」だ。一般ユーザーが使えないモデルは、スコアがどれだけ良くてもカードには載せず、説明文に記録するだけにしている。Argonはここで止まっており、以前に同様に限定公開だったモデルと同じ扱いだ。逆に、新モデルが公開されて第三者の計測が一件でも出れば、AAのデータだけであっても関連するカードに先行掲載できる。
二つ目は「スコアの出所」だ。各スコアについて、ベンダー自身が計測したものか、第三者が同一手法で計測したものかを明示し、二種類を同じ表に並べて比較しない。GoogleがDeepSWEで自己申告した77.9%は前者にあたり、DeepSWEの公開データファイルにまだ載っていないので採用しない。DeepSWEのスコアはすべて公開データファイルから取得し、ネット上の転載は使わない。この基準は失敗から学んで追加したものだ。以前は転載を使っていたころ、すでに成績が出ていたモデルを「未受験」と誤って表記してしまったことがある。
三つ目は「能動的に抜けを探す」だ。更新のたびに、まだ掲載していない新しいモデルが出ていないかを検索する。今回Argonを見落としたのは、その朝の更新で第三者のランキングへの新規追加のみを確認し、主要ベンダーのリリースを個別にチェックしなかったからだ。
発表会のスコアはそのまま比較に使えるか
発表会が与えるのは主張だ。比較に使えるのは、同じ尺で計られた数字だけだ。
これはGoogleの77.9%が虚偽だという意味ではない。ただ、公開データに現れるまでは、他社のスコアと同じ行に並べることができない。上の三つの問いは、結局のところ「主張」と「計測済み」を区別するための道具だ。発表はベンダーが発表会で行うこと。使えるかどうかは、自分のアカウントが公開リストに入っているかどうかで決まる。第三者計測は、同一手法で走り終えるまで待たなければならない。この三つはしばしば別々の日に起きる。数週間開くこともある。
企業がAIを選ぶときも構造は同じで、AIシアターの終焉の記事に書いたとおり、求められるのは検証に耐える価値だ。毎日AIを使うオフィスワーカーに置き換えれば、検証するのが自分のメールとスライドになるだけだ。この三つの問いを持つ人と、発表会だけを見ている人の間では、能力の差がじわじわ開いていく。
ページに書いた数行
Argonは今、私のページに数行だけ書かれている。一般ユーザーへの公開が実現し、第三者の計測が揃ってから、どのカードに入れるかを判断する。
AIガバナンスに関するさらなる考察はAI × 人間の秩序 → AIガバナンスから。
💬 コメント
読み込み中...