10 月 1 日,Google 發表了新模型 Gemini 4 Argon。Demis Hassabis 在 X 上貼出一張比較表,Argon 那一欄大半塗成藍色,代表那些項目領先。如果你那天剛好滑到這則消息,心裡可能閃過一個念頭:我每天用 AI 寫信、做簡報,要不要換?
我自己維護一個追蹤 AI 模型的頁面,叫 /ai/models,用來比較幾個前沿模型的實力。那天上午的例行更新其實漏掉了 Argon,是我後來問起 Gemini 的最新進展才發現,同一天上午補進頁面。補進去的是說明文字,比較卡片上沒有它。
一個號稱多項第一的新模型,為什麼在我的頁面上只拿到幾行字?這個決定背後,其實是三個任何人都用得上的問題。
看到新 AI 模型發表,上班族該先問哪三件事?
我現在用得到嗎?這個分數是誰量的?它換了、它錯了,我看得出來嗎?
這三題聽起來平常,但新模型發表時的消息,很少替你回答。下面用 Argon 一題一題走。
第一問:Gemini 4 Argon 現在用得到嗎?
用不到。依 Google 的部落格,Argon 目前只開放給 Fairwind 計畫的成員,也就是政府單位和受信任的資安防禦方,他們拿到的是不帶資安護欄的版本。之後開給其他人的,會不會是同一個版本,我手上的資料沒有寫。下一批是付費 API 客戶和 Google AI Ultra 訂閱者,時程沒寫。一般人什麼時候輪得到,文章沒有提。
所以 10 月 1 日那張表再漂亮,對大部分上班族來說都還只是預告。發表和能用,在 Argon 身上已經是兩個日期。
第二問:新模型的分數是誰量的?
先看 Hassabis 貼出的那張表。
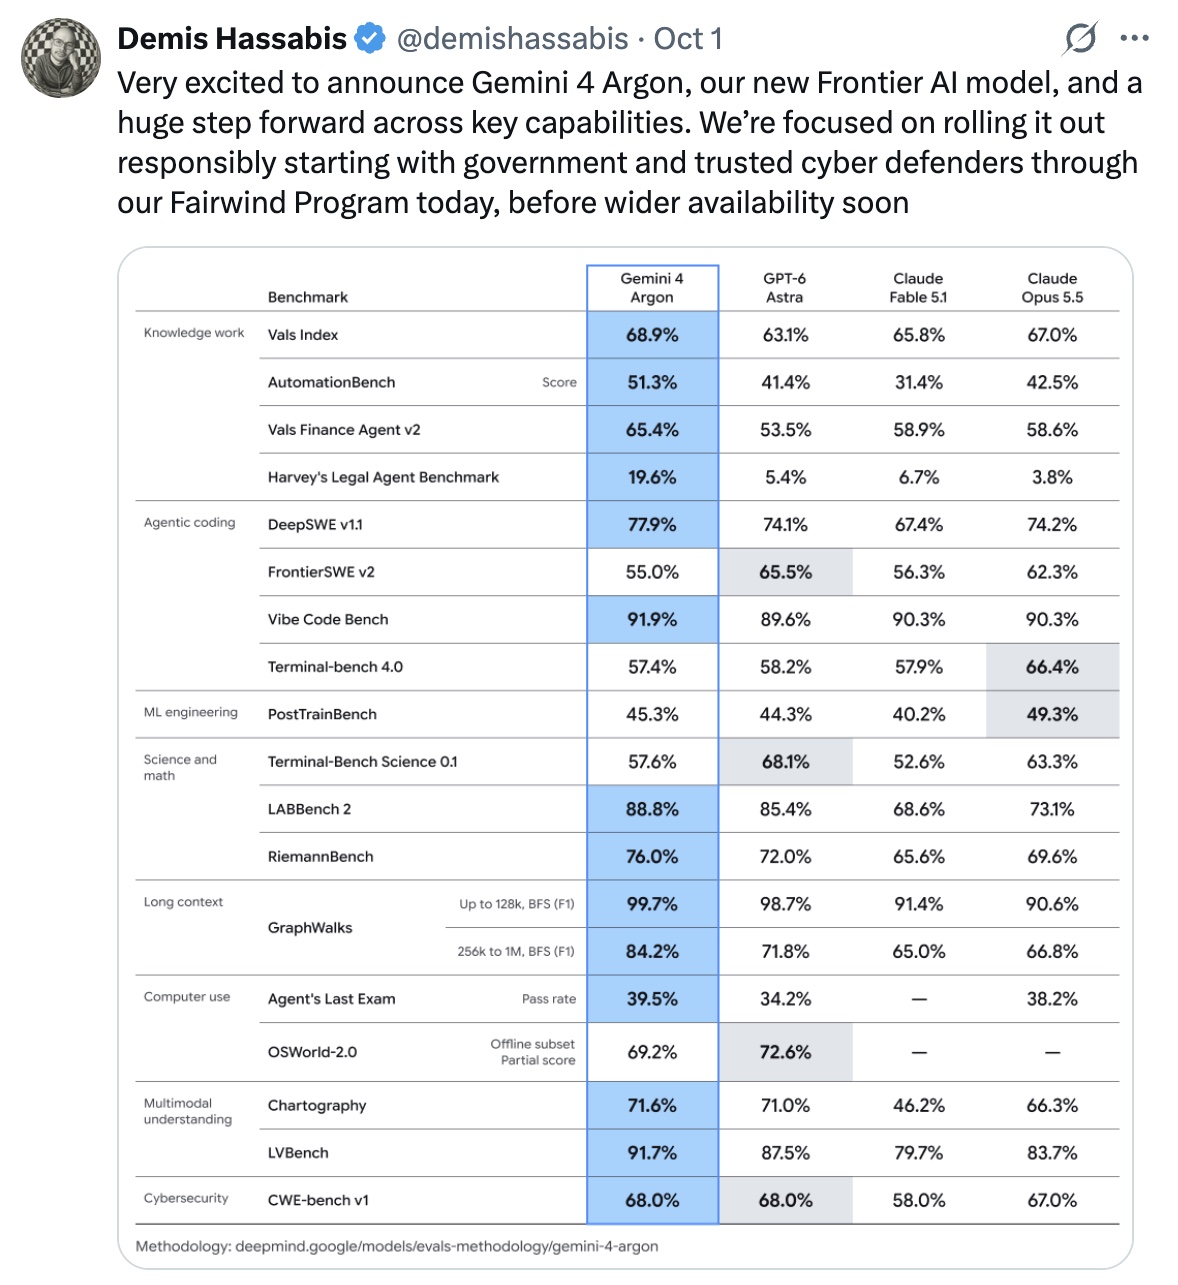 Demis Hassabis 的 X 貼文截圖(2026-10-01)。表格由 Google 提供。
這張表值得多看兩眼。藍底是 Argon 領先,灰底是別家領先。19 列分數裡,有 5 列是別家贏,資安那列平手。就算是廠商自己挑項目、自己排版的表,Argon 也不是全贏。
再挑一列來對。表上寫 Argon 在 DeepSWE(一套測 AI 寫程式能力的測驗)拿 77.9%,比第二名高出快 4 個百分點。DeepSWE 自己有公開的成績資料檔,我拿表上這一列四個數字去比,只有 GPT-6 Astra 的 74.1% 查得到。Argon 不在裡面,表上的 Fable 5.1 和 Opus 5.5 也不在,資料檔裡只有它們的上一代。資料檔是 9 月 22 日產生的,早於發表,查不到並不奇怪,但也代表這一列的四個數字,有三個目前沒有公開資料可以對照。
同一個模型交給第三方 Artificial Analysis(AA)用自己的方法量,出來的是另一張圖。AA 的綜合指數(這是指數,不是答對率),Argon 拿 53,跟 Fable 5.1、GPT-6 Astra 同分;Opus 5.5 是 58。Argon 真正突出的是幻覺率,也就是會不會一本正經地編出答案。它約 15%,明顯低於另外三個前沿模型。
對寫信、做簡報的人,這一點比任何程式分數都要緊。報告裡錯一個數字,信裡多一個不存在的出處,丟臉的是你,不是 AI。挑工具時,先想清楚你最怕哪一種錯,再去找量那種錯的數字。
第三問:AI 換了模型、出了錯,你看得出來嗎?
9 月 28 日,我在自己寫程式用的 AI 工具裡測了一件小事:平常叫的那個模型名字,現在實際用的是哪一版。結果已經換成新版的 Opus 5.5。名字沒變,裡面換了,事前沒有任何通知。
這件事對我不是小事。這半年模型進步得太快,我的工作流程幾乎都跟著模型的演化綁在一起:用哪個模型,會影響工作流程怎麼設計,也影響提示詞怎麼寫。模型換了,流程和提示詞可能就得重新調整。所以「現在跑的到底是哪一個」,我必須知道。
上班族其實也一樣。你習慣的問法,做簡報大綱的那套提示詞,都是在某個模型上摸出來的。工具背後的模型一換,結果可能變好,也可能讓原本順手的用法出現你沒預期的變化。如果你用的工具有顯示模型名稱,哪天覺得回答方式怪怪的,先看一眼是不是換了,再懷疑自己的提示詞。
錯了怎麼看,比換了怎麼看更實際。不管模型新舊、排名高低,信和簡報裡查得到的東西,像數字和出處,送出去之前自己查一次。幻覺率低的模型也還是會編,只是比較少。
Argon 發表後,我也回頭查了自己有沒有要跟著換。我平常會請 Google 的 AI 工具幫我做第二輪檢查,查下來,能選的模型清單裡根本沒有 Argon,想換也換不到。就算哪天它出現了,我也會先在自己的工作上試過再說。幻覺率低聽起來很吸引人,但那量的是會不會亂編,跟能不能幫我抓出問題是兩件事。
我的模型頁怎麼決定收不收新模型?
我的模型頁有幾條收錄規則,說穿了就是把上面三題寫成固定流程。
第一條是能不能用。一般人用不到的模型,分數再好也不放進卡片,只在說明裡記下讀數。Argon 就卡在這一關,跟先前同樣只開放給少數單位的模型一樣處理。反過來,新模型只要開放了、有第三方量過,就算目前只有 AA 一份數字,也可以先放進相關的卡片。
第二條是分數從哪裡來。每個分數都標明是廠商自己跑的,還是第三方用同一套方法量的,兩種不放進同一張表比高低。Google 自報的 DeepSWE 77.9% 就屬於前者,DeepSWE 的公開資料檔裡還沒有它,所以不採計。DeepSWE 的分數一律從公開資料檔取,不用網路上的轉述。這條是踩過坑才加的:以前用轉述,曾經把一個已經有成績的模型,錯列成「尚未送測」。
第三條是主動找缺口:每次更新都要搜尋這段時間有沒有還沒上榜的新模型。Argon 這次還是被漏掉,原因是那天上午只照第三方榜的新進者去找,沒有對幾家大廠各查一次最近有沒有發表。
發表會給的分數,能直接拿來比嗎?
發表會給的是宣稱。能拿來比較的,只有同一把尺量過的數字。
這不代表 Google 的 77.9% 是假的,只是在它出現在公開資料之前,我沒辦法拿它跟別人的分數放在同一列。上面三個問題,其實都在幫你分辨宣稱和量過的差別:宣布是廠商在發表會上做的事;能不能用,要看你的帳號在不在開放名單裡;量過了,得等第三方用同一套方法跑完。三件事常常落在不同的日子,有時隔好幾週。
企業選 AI 也是同一個道理,AI 劇場落幕那篇寫過:要的是經得起驗證的價值。換到每天用 AI 的上班族身上,差別只在你驗證的是自己的信和簡報。會問這三個問題的人,跟只看發表會的人,能力落差會慢慢拉開。
頁面上的那幾行字
Argon 現在在我的頁面上,只有幾行字。等它真的開放給一般人用,再看它該進哪張卡片。
想看更多 AI 治理的討論:AI 與人類秩序 → AI 治理
💬 留言討論
載入中...